六个案例与下载
让每一个因素的作用
在地图和时间上看得见
BSTVC 桌面版 V2 中文用户手册:不写代码,点几下就能做时空回归。六个真实案例,每一步告诉你点哪里、为什么、应该看到什么,最后把结果画成可以直接投稿的论文图。
这本手册怎么读
记号:截图上的 1 对应图下同号步骤;白话 是一句话讲明白;概念卡 用五步讲清一个新概念(一句话 · 打个比方 · 为什么 · 怎么用 · 讲给别人听)。“预期结果”中的数字与案例文件夹里的结果表一致;你自己运行时,第 3–4 位有效数字可能略有不同。
10 分钟上手:用案例 1 跑通全流程
- 从中文官网下载并安装 V2,双击桌面图标启动(第一次启动要等几秒到半分钟)。
- 数据输入:表格选
Case-01-Continuous-Africa-U5MR\africa_u5mr_panel_zh.csv,地图一次选中africa_countries_v2的 4 个文件 → 读取并验证输入 → 看到 1008 行、10 列、48 个地图单元。 - 数据检查:时间“年份”、空间“iso3” → 运行检查 → 看到“已完成自动重排”。
- BSTVC 时空建模:数据来源“检查后数据”,Y“五岁以下儿童死亡率”,X“城市人口比例、PM25暴露、人口百万”,响应类型“连续型”,标准化“是”,线程 20 → 运行模型,< 15 秒 完成。
- 下载全部表格,再运行案例文件夹里的 R 脚本,得到中英两套论文图(见案例 1 的可视化)。
就像做菜:先备好食材(数据输入),对一下菜谱顺序(数据检查),再下锅(建模),最后装盘(下载结果、出图)。
1 BSTVC 能回答什么:用一个真实结果来看
普通回归只给每个因素一个系数,好像它在所有地方、所有年份作用都一样。BSTVC 让这个系数在每个地区、每个时点都可以不一样,于是能回答三个问题:
下面是案例 1(非洲 48 国五岁以下儿童死亡率,2000–2020)的真实结果,一张图回答一个问题:
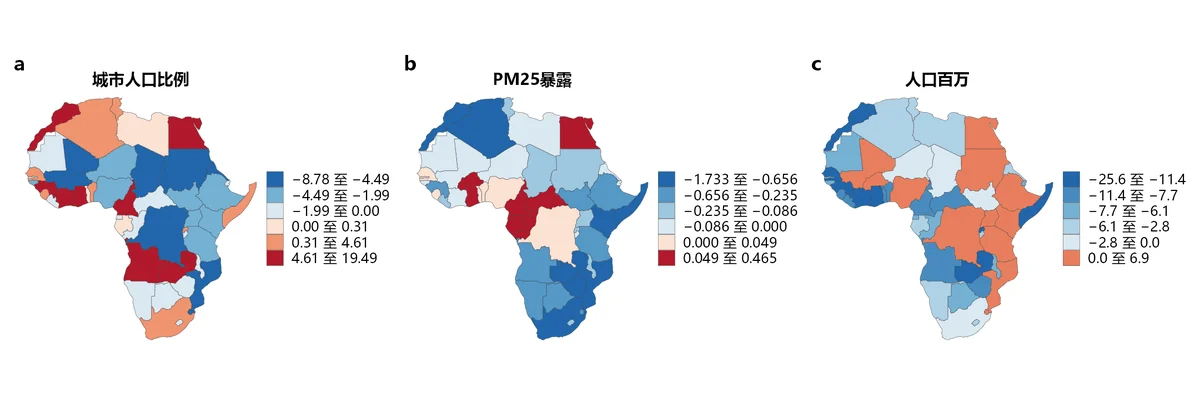
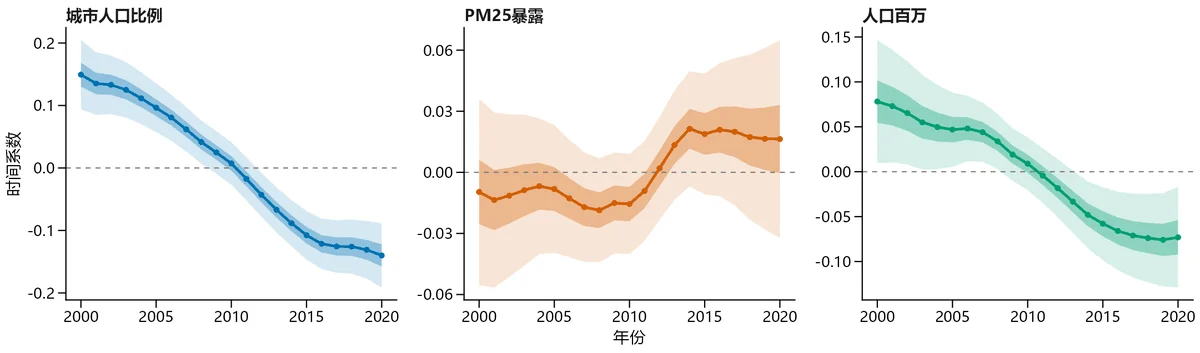
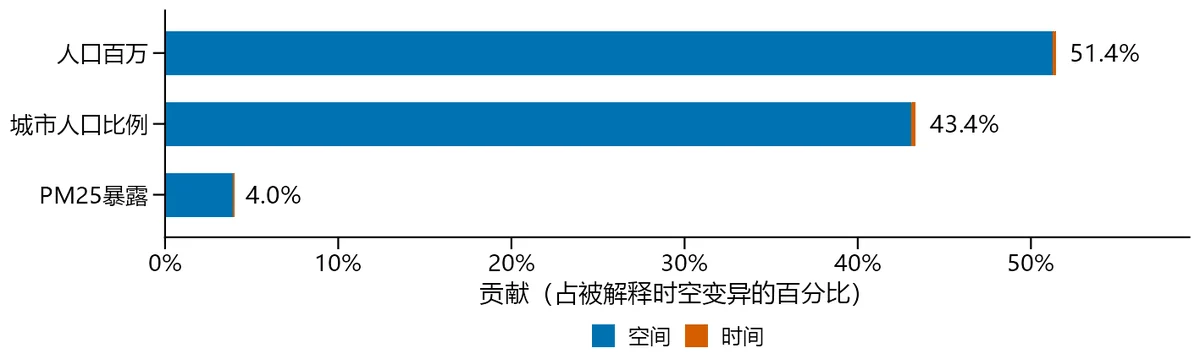
同样是城市化,在不同国家和儿童死亡率的关系很不一样;而这种关系 20 年里变化不大。所以政策重点是“因地制宜”。BSTVC 就是把这种结论从数据里直接算出来、画出来。
- 一句话
- 回归系数 = X 变化时 Y 跟着变多少;BSTVC 给每个地区、每个时点各算一个,叫“局部回归系数”。
- 打个比方
- 同样下一场雨(X),山区的河水涨得多,平原涨得少;雨季涨得多,旱季涨得少。“涨多少”随地点、季节而变。
- 为什么要用
- 只给一个全局系数,会把“有的地方作用强、有的地方几乎没作用”平均掉,政策就会一刀切。
- 怎么用
- 看两张表:
space.coefficients(各地区)和time.coefficients(各时点)。某地某时的完整作用 = 空间系数 + 该时点的时间系数。 - 讲给别人听
- “BSTVC 不只告诉你某个因素重不重要,还告诉你它在哪里、什么时候更重要。”
1.1 三种结局、两种模型
| 你的结局 Y 是…… | 响应类型选 | 例子 | 照哪个案例 |
|---|---|---|---|
| 正的连续数(率、寿命、浓度) | 连续型 | 儿童死亡率、健康预期寿命 | 案例 1、6 |
| 只有 0 / 1(发生、没发生) | 二分类 | 当月是否发生疫情 | 案例 2、4a、5 |
| 非负整数(个数) | 计数型 | 病例数、死亡人数 | 案例 3、4b |
多个时点的数据用 BSTVC 时空建模;只有一个时点(一年、一次普查)用 BSVC 空间建模(案例 5)。全部计算在你自己的电脑上完成,数据不会上传。
2 V2 的进步:用结果说话
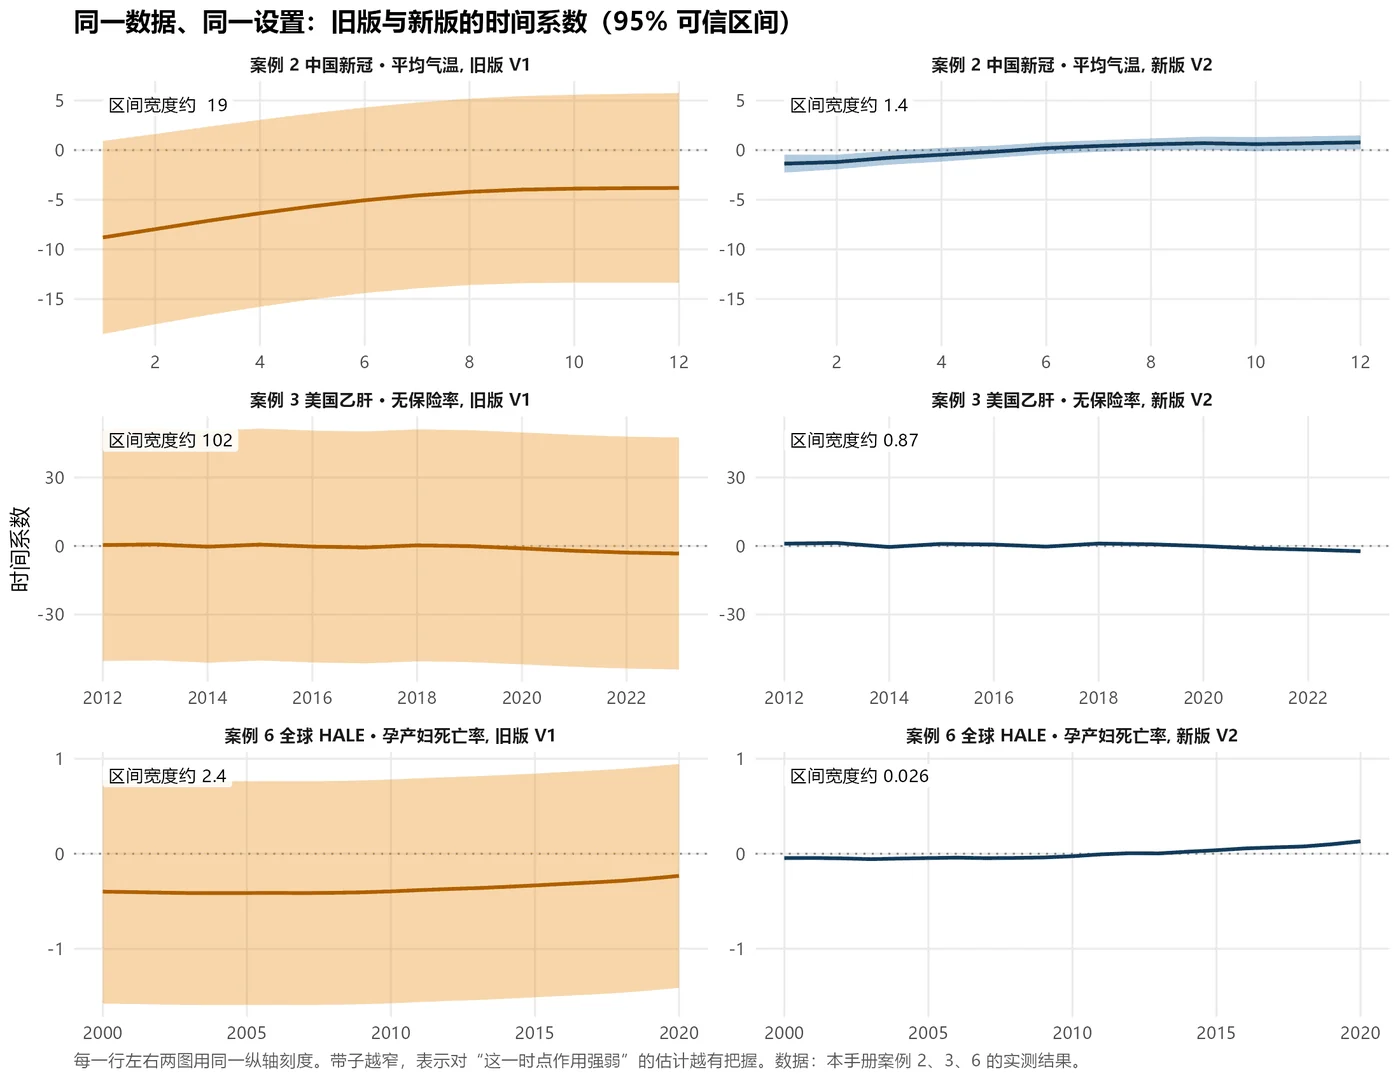
上图从三个案例里各取一个因素:新冠案例“平均气温”的区间中位宽度从约 19 收窄到 1.4,乙肝案例“无保险率”从约 102 收窄到 0.87,HALE 案例“孕产妇死亡率”从 2.4 收窄到 0.026。全部案例的逐项对比:
| 案例 | 时间区间中位收窄 | 空间区间中位收窄 | DIC V1 → V2 | WAIC V1 → V2 | R² / AUC V1 → V2 |
|---|---|---|---|---|---|
| 1 非洲五岁以下儿童死亡率(3X) | 99.2%(63/63) | 89.4%(144/144) | 8,365.4 → 8,369.3 | 8,372.8 → 8,370.5 | 0.791 → 0.793 |
| 1 非洲(7X,4 个有缺失) | 99.3%(147/147) | 85.4%(336/336) | 6,742.6 → 6,724.5 | 8,364.4 → 8,595.6 | 0.899 → 0.901 |
| 2 中国新冠疫情 | 97.8%(72/72) | 90.4%(186/186) | 298.2 → 391.2 | 297.2 → 568.4 | 0.950 → 0.938 |
| 3 美国乙肝 | 99.1%(48/48) | 98.2%(20/20) | 538.1 → 520.9 | 564.3 → 521.5 | 0.983 → 0.992 |
| 4a 美国高自杀率(二分类) | 99.7%(52/52) | 98.1%(196/196) | 323.4 → 315.0 | 336.0 → 318.9 | 0.990 → 0.990 |
| 4b 自杀死亡数(标准化 = 否) | 99.4%(52/52) | 92.3%(195/196) | 6,357.7 → 6,341.4 | 6,521.7 → 6,491.8 | 0.998 → 0.998 |
| 5 BSVC 2016 截面 | —(无时间项) | 两版相同 | 48.9 → 48.9 | 50.2 → 50.2 | 0.898 → 0.898 |
| 6 全球 HALE(12X) | 98.6%(252/252) | 39.2%(2051/2124) | 14,068.8 → 14,162.9 | 16,027.4 → 16,154.0 | 0.967 → 0.967 |
| 6 HALE(6 个 X) | 98.7%(126/126) | 41.9%(1020/1062) | 22,256.8 → 22,284.0 | 24,139.4 → 24,114.9 | 0.568 → 0.575 |
括号内为“变窄的配对项 / 全部配对项”。R² 用于连续型与计数型,AUC 用于二分类;都是同一数据上的拟合。
V2 对同一份数据给出的“这个因素在哪里强、什么时候强”的估计范围窄了很多,结论更清楚;模型对数据的整体拟合(R²、AUC)与 V1 基本一样。
- 一句话
- V2 的时间系数表示:这个时点,因素的作用比整个研究时期的平均水平强多少或弱多少。
- 打个比方
- 像天气预报说“今天比常年平均高 2℃”(距平),而不是“今天 30℃”。
- 为什么要知道
- 时间系数图里的 0 线就是“时期平均”;读对了参照,才不会把“比平时弱”误读成“没有作用”。
- 怎么用
- 时间系数 > 0:这个时点作用比平时更正向;< 0:更负向。想知道某地某年的完整作用,把这个地区的空间系数和这一年的时间系数相加(均值相加即可)。
- 讲给别人听
- “V2 的时间系数是距平,告诉你哪一年比平常更强、哪一年更弱。”
进阶 V1 老用户:还有哪些地方不一样、哪些没变
- 界面:九个页面、按钮和参数与 V1 一样;“关于”页的联系邮箱统一为
bstvc.research@gmail.com;未上传自定义空间矩阵时,数据输入页会提示“将使用默认矩阵”。 - V1 与 V2 的时间系数参照不同,不要拿两版“区间不含 0 的比例”互相比较。
- 只有空间系数的 BSVC(案例 5)两版结果完全相同:没有时间系数,这次更新不涉及它。
- 没变的:仍至少需要 2 个解释变量;二分类和计数模型的 STVPI 只在各因素之间分配 100%(没有“残差”一项);没有人口暴露量(offset)选项。
原理请参阅已发表的 BSTVC 方法论文(见怎样引用)。
3 安装与界面
- 从中文官网下载中文版 V2 安装包
BSTVC_desktop_win_x64_26.10.25_setup.exe(约 519 MB)。可选:核对 SHA-2566399a2e7646b69b2c3e05a72f2afa955c7e4e210f4a6384edf2c39f8169b9e6d,确认下载完整。 - 双击安装,默认装到当前用户目录
%LOCALAPPDATA%\Programs\BSTVC,桌面出现快捷方式。Windows 用户名含中文时,默认路径就含中文:请换英文账户,或装到D:\BSTVC这样的位置。 - 双击桌面图标。第一次启动窗口可能黑几秒到半分钟,不要反复双击(每双击一次就多开一份程序)。出现“概览”页即可开始。
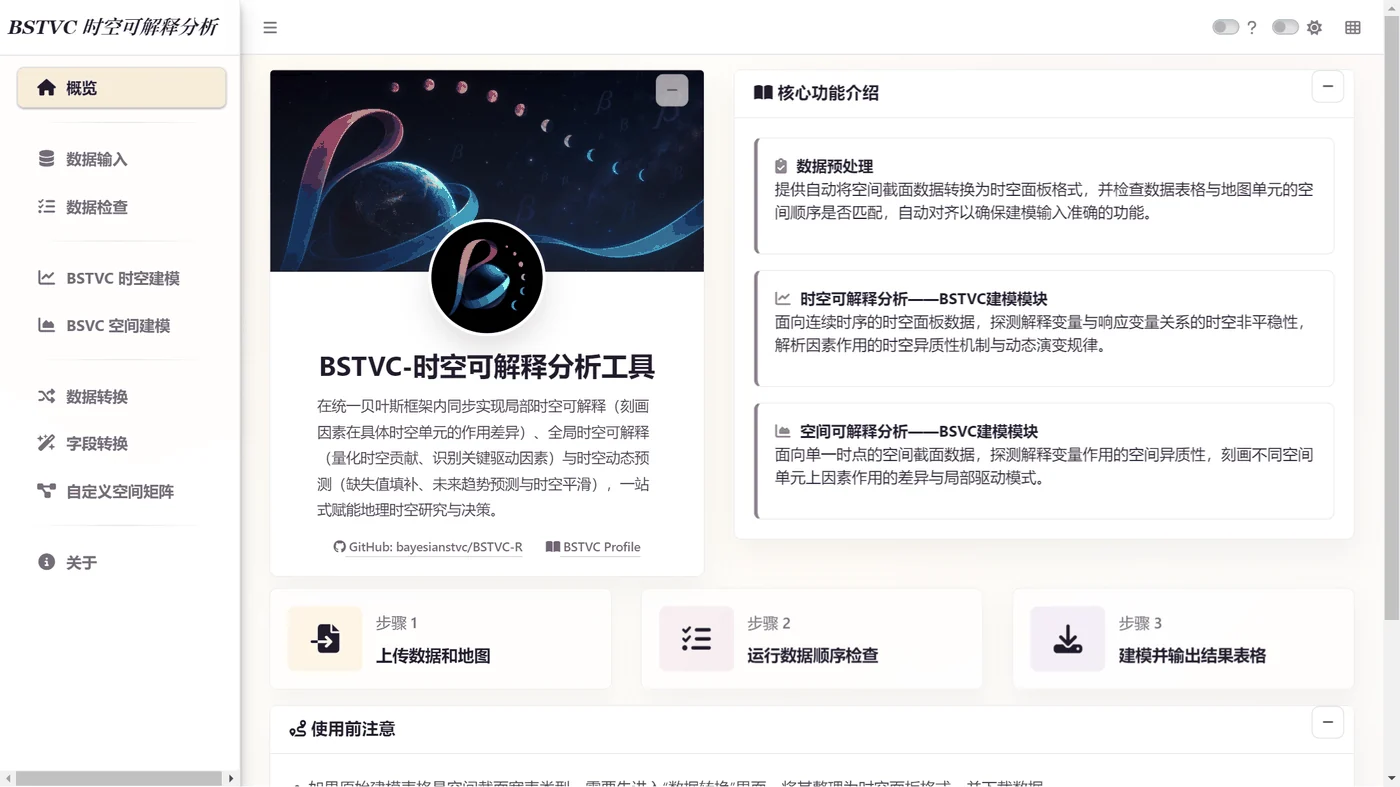
| 页面 | 用来…… | 哪个案例用到 |
|---|---|---|
| 数据输入 | 载入建模表格(CSV / Excel)和地图(shapefile 全部文件) | 全部 |
| 数据检查 | 核对表格里地区的顺序和地图是否一致,不一致就自动重排 | 全部 |
| BSTVC 时空建模 | 多个地区 × 多个时点 | 1、2、3、4、6 |
| BSVC 空间建模 | 只有一个时点 | 5 |
| 数据转换 | 把“每个时点一列”的宽表转成一行一地一时的长表 | 2、3 |
| 字段转换 · 自定义空间矩阵 · 关于 | 修改字段类型;构建其他空间权重矩阵;开发者与联系方式 | — |
进阶 其他页面截图与资源占用
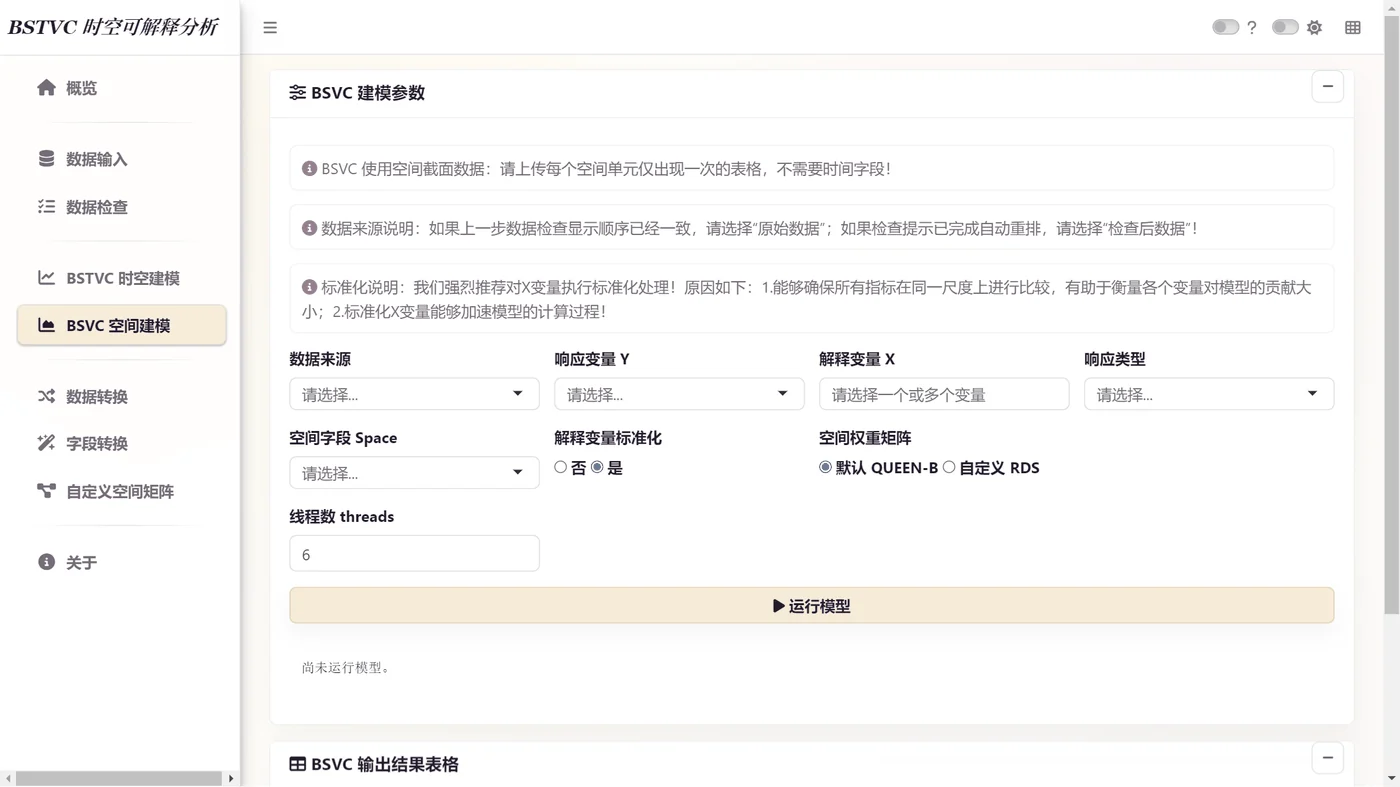
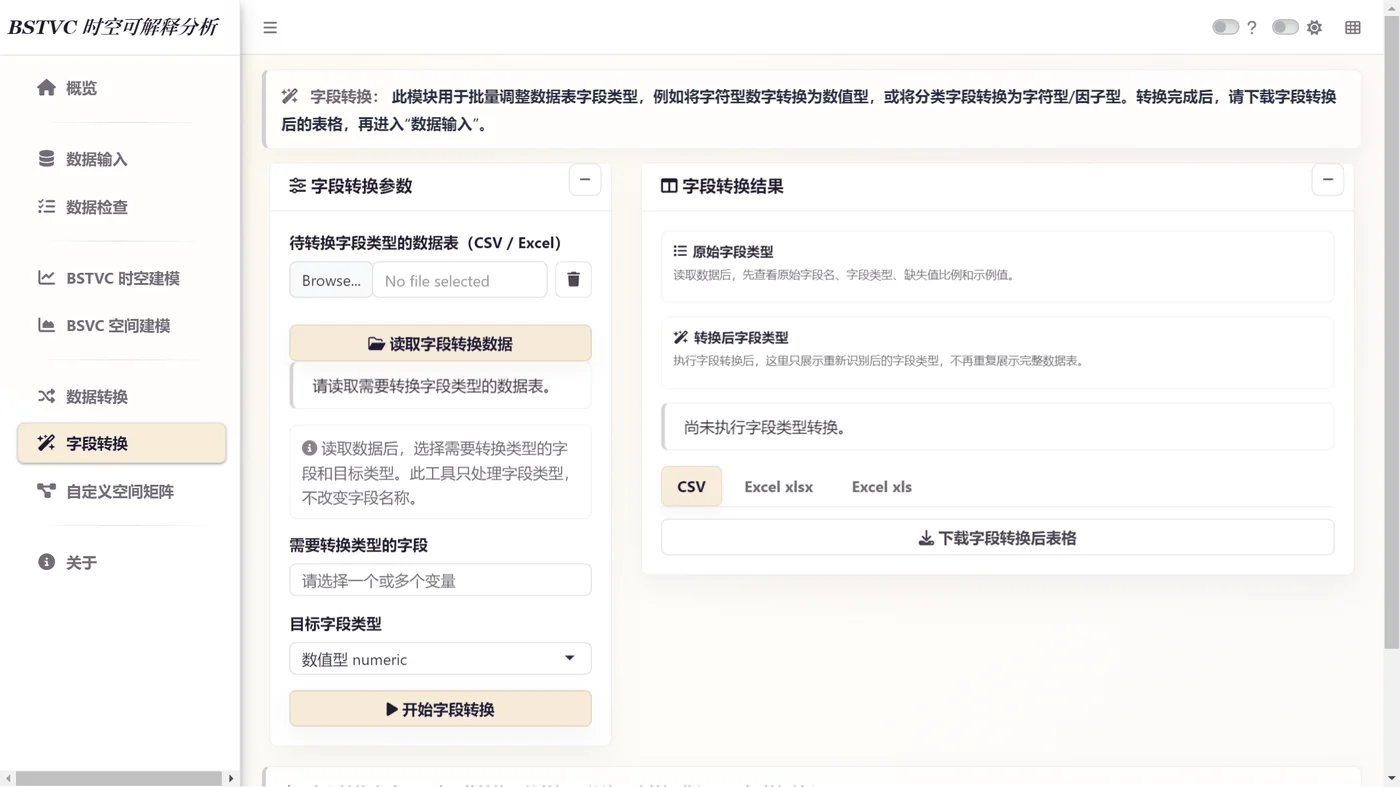
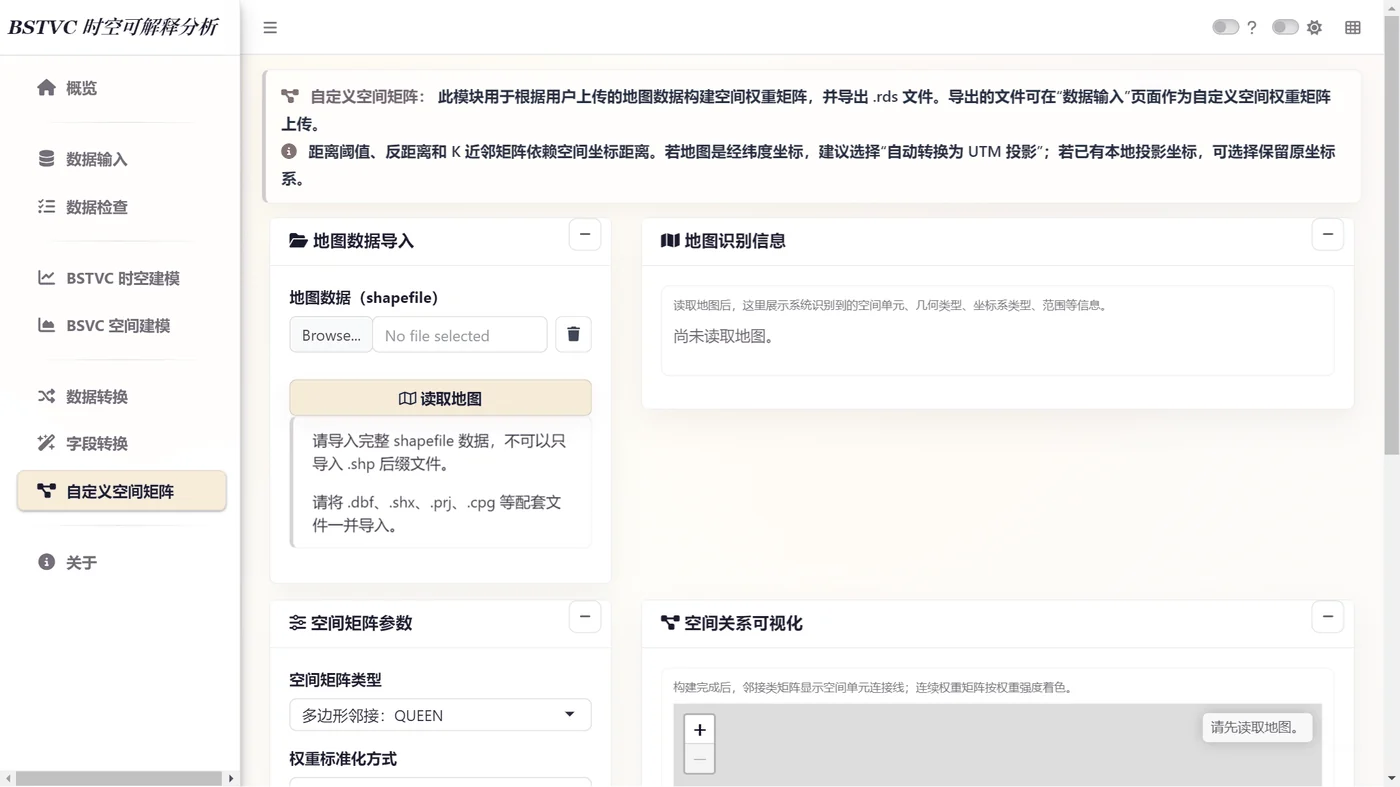
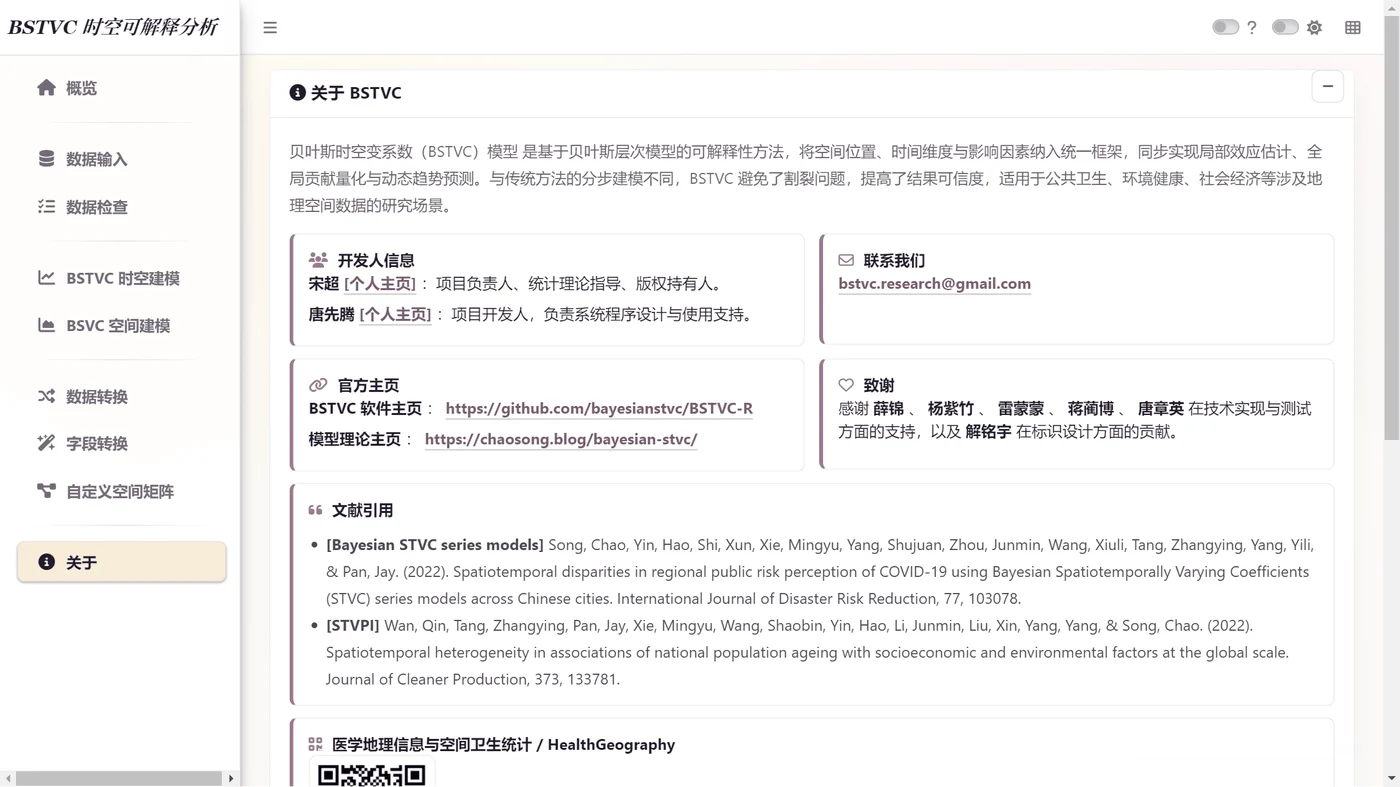
安装后约占 1.2 GB;本手册最大的案例(177 国 × 21 年,12 个解释变量)运行时占用内存约 3.5 GB。
4 准备数据:动手前检查五件事
大多数运行失败是数据问题,不是软件问题。打开软件之前先把数据整理对。
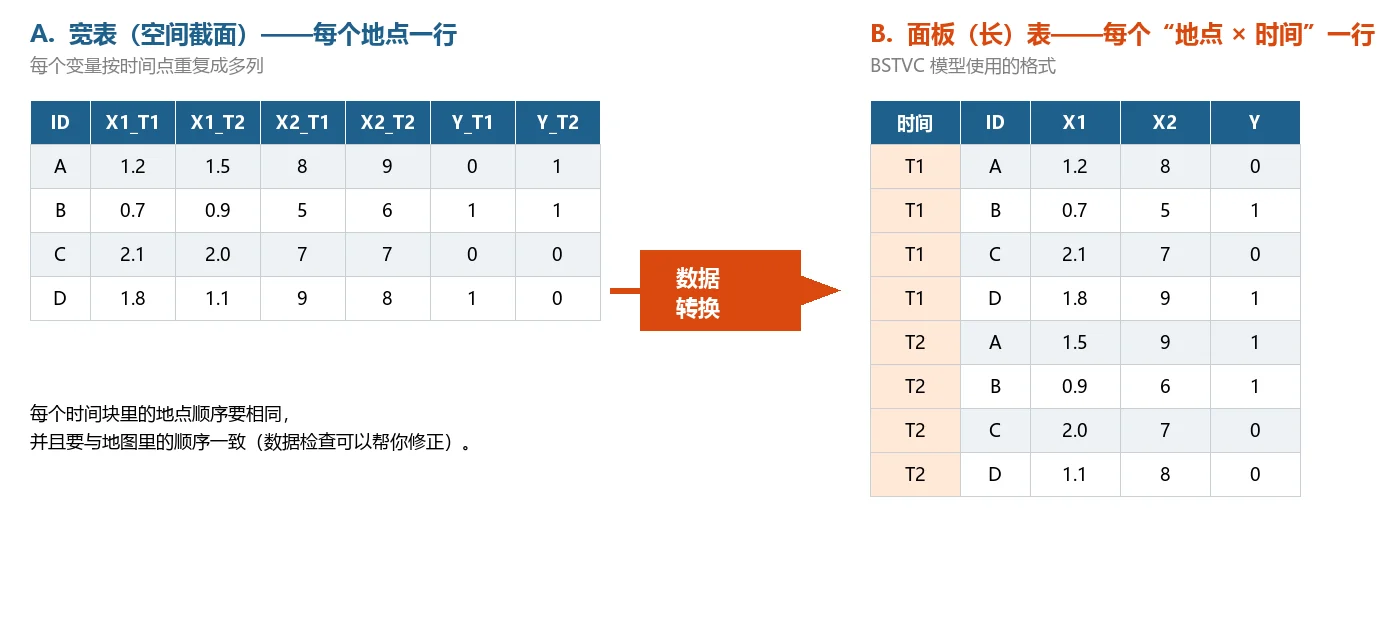
- 表格是长表:一行 = 一个地区在一个时点(地区 ID、时间、Y、X1、X2…);同一个(地区, 时间)不能出现两次。宽表先做“数据转换”。
- 缺失写 NA:不要用空格、0、−999。Y 可以有缺失(软件会给出拟合值,可用来补缺);X 尽量少缺失。
- 结局类型对得上:连续型(正数)、二分类(只有 0/1)、计数型(非负整数)。“率”不是计数。
- 空间 ID 对得上:表格和地图属性表里要有一个名字和类型都相同的 ID 字段,取值一致(文本“21”和数字 21 对不上)。
- 地图文件齐全:
.shp .dbf .shx .prj(有.cpg也一起选)一次全选;没有邻居的岛屿要心中有数(案例 1、2、6 都有)。
- 一句话
- 每一行是“一个地区在一个时点”的观测。
- 打个比方
- 像成绩登记表:一行是“某个学生在某次考试”,而不是一个学生一行、每次考试各占一列。
- 为什么要用
- 模型要同时看“地区之间的差别”和“时间上的变化”,长表能把两个维度都摆清楚。
- 怎么用
- 已经是长表(案例 1、4、6)→ 直接“数据输入”;是宽表(案例 2、3)→ 先“数据转换”;只有一年(案例 5)→ 用 BSVC。
- 讲给别人听
- “一行一个地区一个时间,这是时空模型的标准格式。”
4.1 九个建模参数,怎么选
| 参数 | 推荐 | 常见错误 |
|---|---|---|
| 数据来源 | 数据检查提示“已完成自动重排”→ 选检查后数据 | 重排后仍选原始数据:结果被放到错误的地区上,而且不报错 |
| 响应变量 Y | 你的结局 | 把率、人数、病例数混用 |
| 解释变量 X | 按研究问题选,至少 2 个;记下顺序 | 把 ID、时间、Code / timeID / spaceID 选进去 |
| 响应类型 | 连续型 / 二分类 / 计数型(见上一章表格) | 默认是连续型,二分类、计数忘了改 |
| 时间字段 | 年份、月份等 | 选成了 X |
| 空间字段 | 与地图同名的 ID 字段 | 选了名称字段而不是代码字段 |
| 解释变量标准化 | 是 | 标准化后把系数说成“X 增加 1 个原始单位” |
| 空间权重矩阵 | 默认 QUEEN(共享边或角就算邻居) | 换自定义矩阵却不核对 ID 顺序 |
| 线程数 | 20 | 以为越多越快(超过约 20 不再加速) |
- 一句话
- 把每个 X 换成“比平均高(低)几个标准差”,让所有 X 用同一把尺子。
- 打个比方
- 比较身高(厘米)和体重(公斤)谁对成绩影响大,要先都换成“比平均高几个标准差”,才放得到一起比。
- 为什么要用
- 系数之间才能比大小,STVPI 的“贡献百分比”才有意义。案例 4 用真实结果展示了不标准化时百分比会怎么变(见 4b)。
- 怎么用
- 选“是”。系数的意思变成“X 增加 1 个标准差,结局跟着变多少”。
- 讲给别人听
- “要比较几个因素谁更重要,先标准化。”
- 一句话
- 两个地区只要共享一条边或一个角,就算邻居;邻居之间的系数被认为更相似。
- 打个比方
- 国际象棋里的皇后(Queen)能横竖斜走,所以“挨着角”的格子也算相邻。
- 为什么要用
- “近的东西更相似”:模型据此在相邻地区之间互相借用信息,地区数据少时估计更稳。
- 怎么用
- 用默认即可。没有邻居的岛屿(海南、马达加斯加、很多岛国)借不到邻居的信息,解读时单独说明,不要为此删掉研究对象。
- 讲给别人听
- “模型默认挨着的地区作用更像,岛屿没有邻居,结论要更谨慎。”
5 五步走完一个案例
六个案例走的是同一条流程,只是数据和几个设置不同。这里讲清每一步要看到什么,后面每个案例只讲它特别的地方。
| 步骤 | 页面 | 做完后必须看到 | 没看到怎么办 |
|---|---|---|---|
| A 数据转换 (只有宽表要做) | 数据转换 | “转换完成:已生成 N 行……”,N = 地区数 × 时点数;下载时选 Excel xlsx | 逐个核对每个变量是否恰好选了“时点数”那么多列 |
| B 数据输入 | 数据输入 | [OK] 数据读取成功! [OK] 地图读取成功!;三个方块:行数、列数、地图单元数 | 地图读取失败:少选了一个地图文件 |
| C 数据检查 | 数据检查 | 结果卡片标题“已完成自动重排”→ 建模选“检查后数据” | 灰色日志里先出现 Error、最后是 Success 是正常的,以卡片标题为准 |
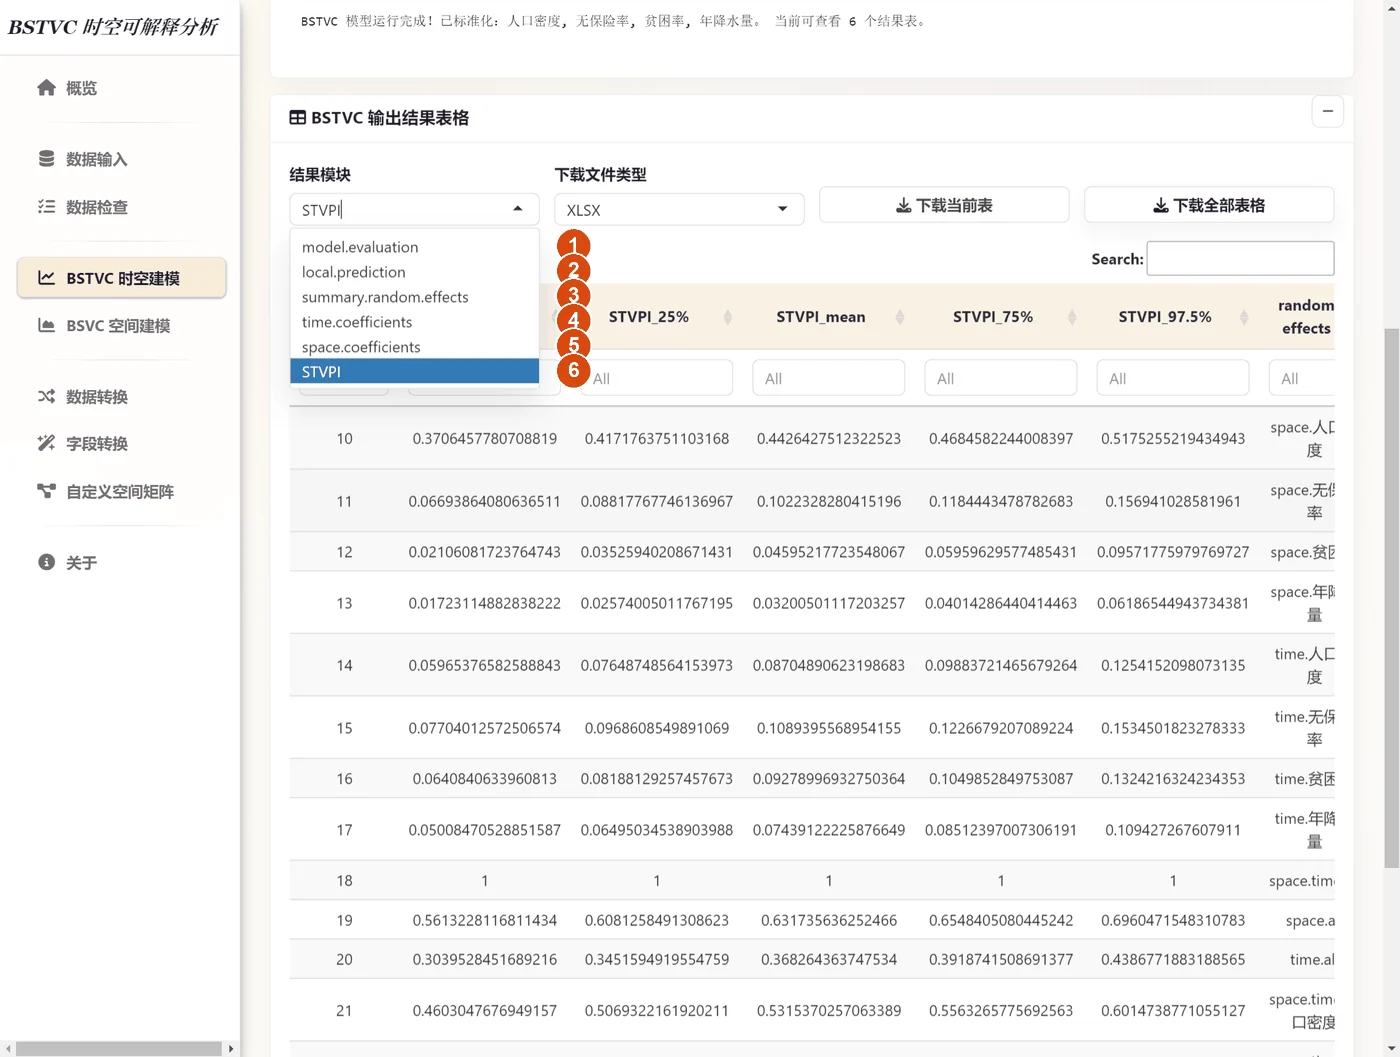
| D 建模、下载 | BSTVC / BSVC 建模 | 状态行“模型运行完成!……当前可查看 6 个结果表”→ 点下载全部表格 | 窗口灰着是在计算,不要点别的页面(见排错) |
| E 读结果、出图 | R | 先看模型评价,再看系数图(读图与出图) | — |
- 一句话
- 软件把表格里地区的顺序排成和地图一模一样。
- 打个比方
- 点名册和座位表顺序要一致,否则会把张三的成绩记到李四的座位上。
- 为什么要用
- 顺序错了模型照样能跑,但结果会画到错误的地区上,而且不报错。
- 怎么用
- 每次换数据都运行检查;提示“已完成自动重排”就在建模页选“检查后数据”。检查后的表多出
Code、timeID、spaceID三列,不要当 X。 - 讲给别人听
- “数据检查就是把表格和地图对齐,这一步永远不能跳。”
- 一句话
- 在这份数据和模型下,这个系数有 95% 的可能落在这个范围里。
- 打个比方
- 天气预报说“明天 18–24℃”:范围越窄,预报越有把握。
- 为什么要看
- 只看一个估计值,不知道它有多可靠;区间告诉你“有多大把握”。
- 怎么用
- 结果表里
0.025quant到0.975quant是 95% 区间,0.25quant到0.75quant是 50% 区间。区间越窄越有把握。 - 讲给别人听
- “区间越窄,结论越有把握;V2 让这个范围窄了很多。”
6 选一个案例
6 个案例、7 个模型,覆盖三种结局、两个建模页面、两种表格格式,变量名全部为中文。挑一个和你的研究最像的,照着做。
| 案例 | 结局 | 页面 | 地区 × 时点 | 主要教什么 | V2 用时 |
|---|---|---|---|---|---|
| 1 非洲五岁以下儿童死亡率 | 连续型 | BSTVC | 48 × 21(长表) | 最短的完整流程;地图报错与修复 | < 15 秒 |
| 2 中国新冠疫情发生状态 | 二分类 | BSTVC | 31 × 12(宽表) | 数据转换;AUC;岛屿 | < 15 秒 |
| 3 美国急性乙型肝炎 | 计数型 | BSTVC | 5 × 12(宽表) | 计数结局;地区很少时怎么读 | < 15 秒 |
| 4a 美国高自杀率状态 | 二分类 | BSTVC | 49 × 13(长表) | 从连续指标派生 0/1 结局 | < 15 秒 |
| 4b 美国自杀死亡数 | 计数型 | BSTVC | 49 × 13(长表) | 为什么要标准化;如实读模型评价 | < 15 秒 |
| 5 美国 2016 年高自杀率 | 二分类 | BSVC | 49 × 1(截面) | 只有一个时点时怎么做 | < 15 秒 |
| 6 全球健康调整预期寿命 | 连续型 | BSTVC | 177 × 21(长表) | 最大的案例;12 个 X | ≈ 17 分钟 |
用时 = 软件记录的计算时间(结果表 model.evaluation 的 running_time);线程 20、默认 QUEEN 矩阵、标准化 = 是。
每个案例都按同样的顺序写:案例卡(数据、来源、变量)→ 逐步操作(截图 + 为什么)→ 预期结果(你应该得到的数字)→ 结果解读 → 可视化与解读(R 代码 + 论文图 + 每张图怎么读)。
7 案例 1 · 连续型:非洲 48 国五岁以下儿童死亡率
7.1 案例卡:数据、来源与变量
| 项目 | 内容 |
|---|---|
| 文件夹 | Case-01-Continuous-Africa-U5MR |
| 表格 | africa_u5mr_panel_zh.csv:48 国 × 2000–2020 年 = 1,008 行,10 列,长表 |
| 地图 | africa_countries_v2.shp / .dbf / .shx / .prj(修复后的版本,4 个文件);original_map\africa_countries.* 是未修复的原图,用于演示报错 |
| 来源与许可 | 边界:Natural Earth 1:110m(公有领域)。指标:世界银行开放数据(CC BY 4.0,需署名);五岁以下儿童死亡率是联合国 IGME 的模型估计值 |
| 空间 / 时间 | iso3(ISO 三位字母代码,与地图同名)/ 年份 |
| Y | 五岁以下儿童死亡率:每千名活产儿中的死亡数(无缺失) |
| X(主运行) | 城市人口比例(%)、PM25暴露(µg/m³)、人口百万——都完整 |
| X(扩展运行) | 再加 人均GDP(缺 5.5%)、基本饮水服务覆盖率(2.6%)、电力可及率(1.6%)、卫生支出占GDP比重(4.0%) |
| 设置 | 连续型 · 检查后数据 · 标准化 = 是 · QUEEN-B · 线程 20 |
7.2 步骤 A:数据输入
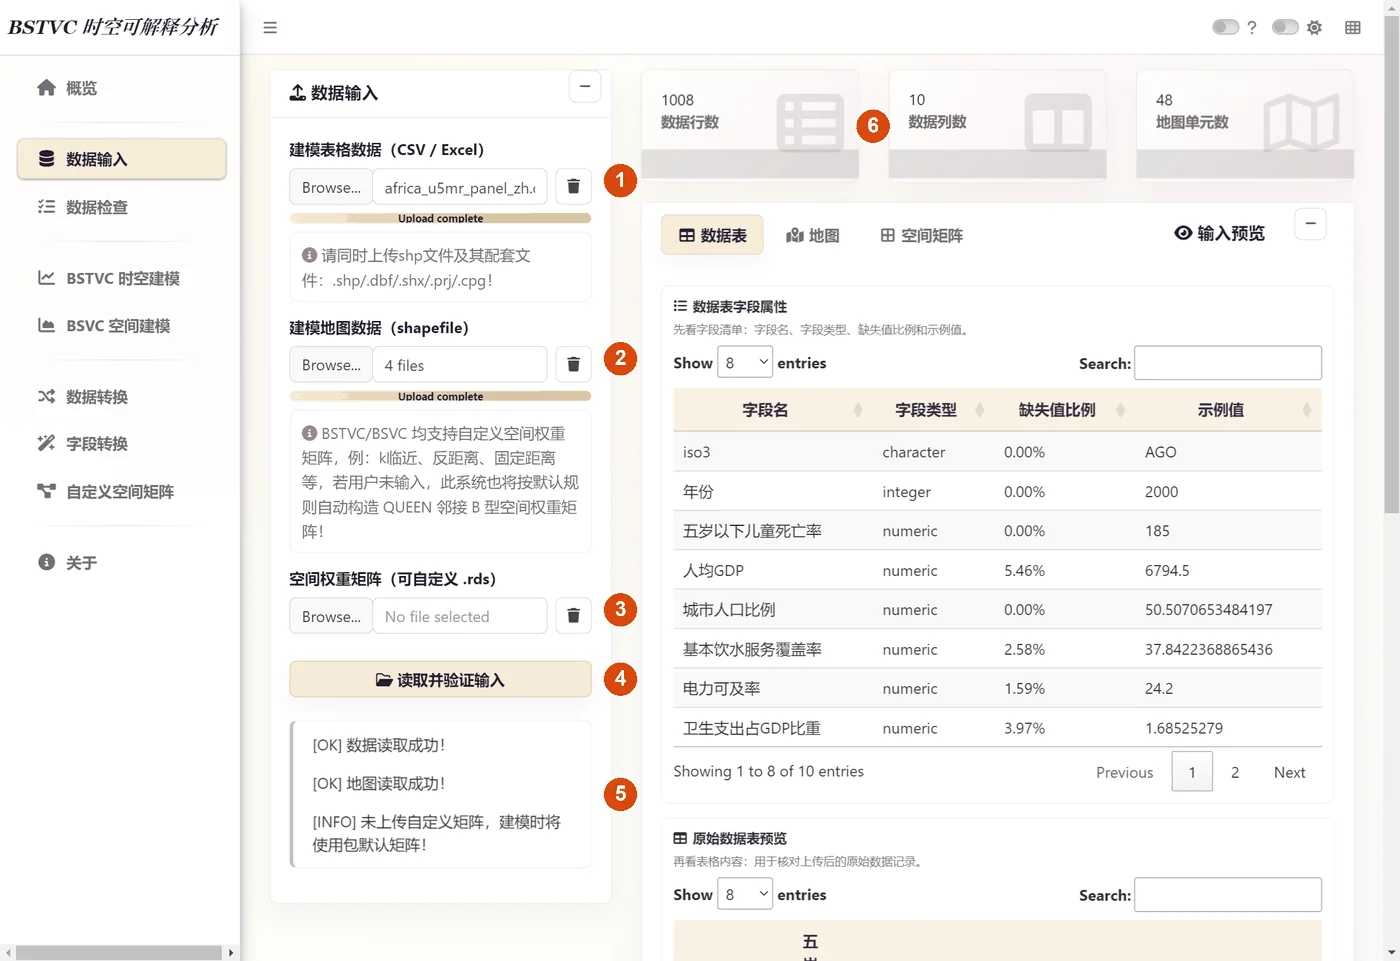
- 点左侧数据输入。在“建模表格数据(CSV / Excel)”下点 Browse…,选
africa_u5mr_panel_zh.csv(1)。这张表已经是“一行一国一年”的长表,可以直接载入,不需要数据转换。 - 在“建模地图数据(shapefile)”下点 Browse…,按住 Shift 一次选中
africa_countries_v2的 4 个文件(2),框里显示“4 files”。shapefile 是一组文件:.shp存形状、.dbf存属性(里面有iso3)、.shx是索引、.prj是坐标系。少一个就读不出来。这份地图没有 .cpg(属性表全是英文),所以是 4 个。 - “空间权重矩阵”留空(3),点读取并验证输入(4)。留空 = 用默认的 QUEEN 邻接矩阵,绝大多数研究用它就够了。
- 看左下三条消息(5):
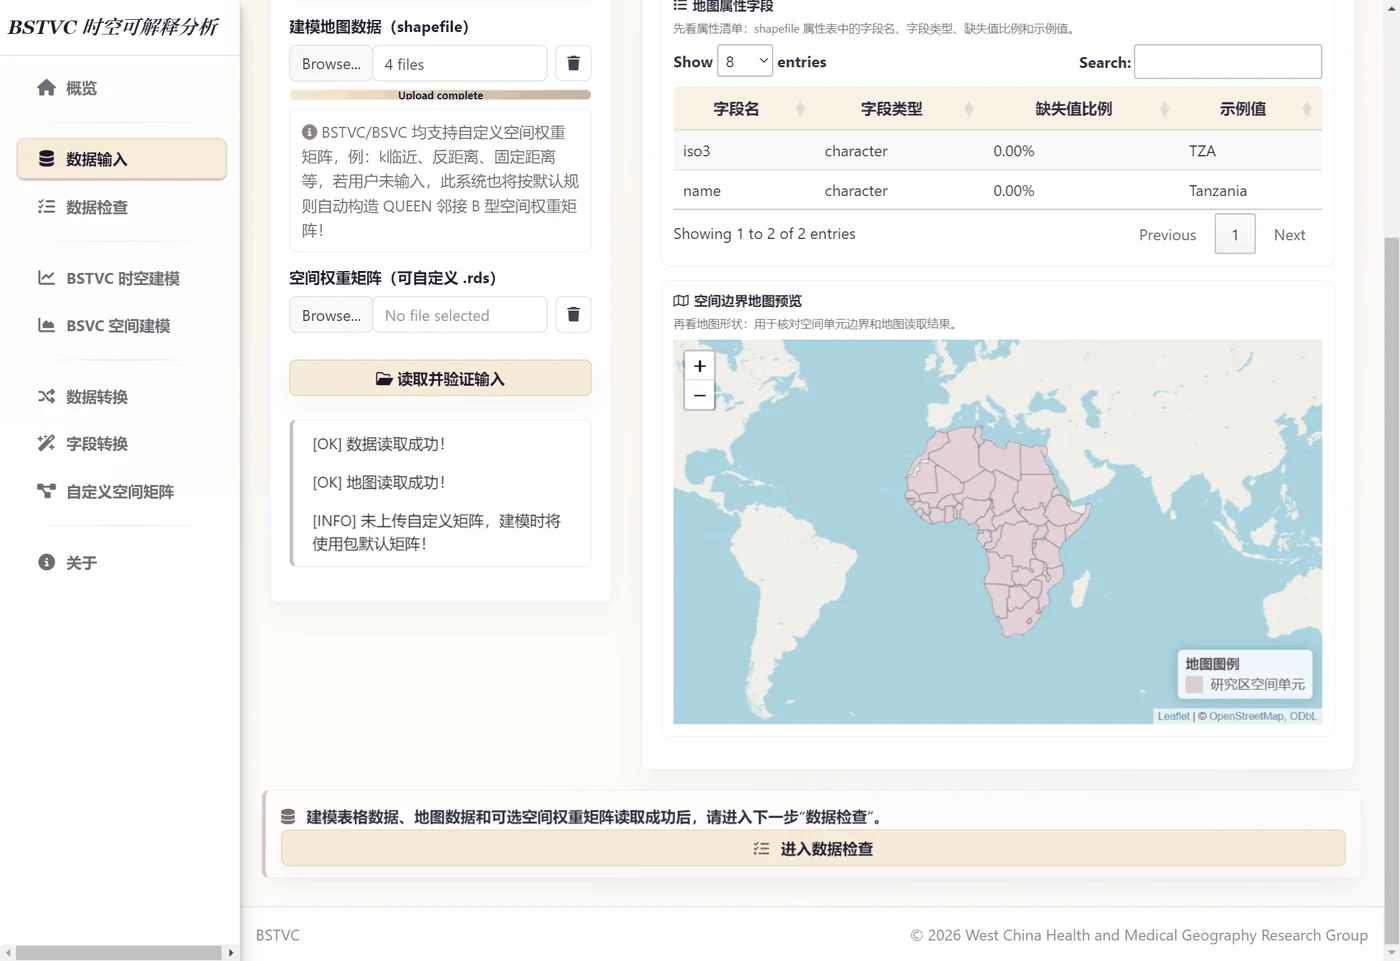
[OK] 数据读取成功!、[OK] 地图读取成功!、[INFO] 未上传自定义矩阵…;看右上三个方块(6):数据行数 1008、数据列数 10、地图单元数 48。1008 = 48 × 21,说明每个国家每年都有一行;48 与地图单元数一致,说明表格和地图覆盖同一批国家。
7.3 步骤 B:数据检查——以及一张需要修复的地图
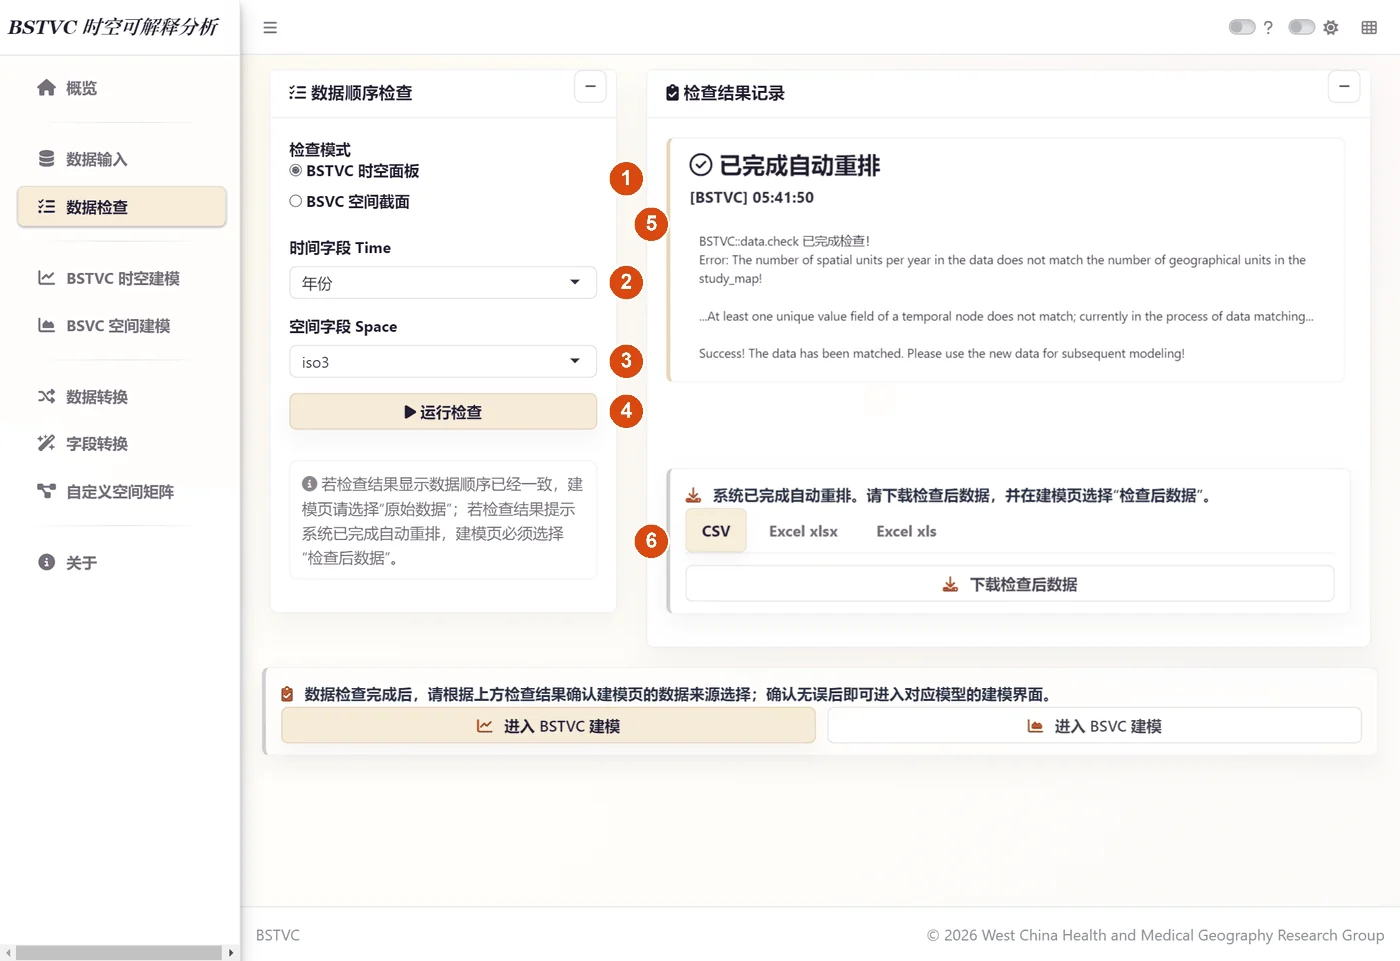
- 点数据检查,检查模式保持 BSTVC 时空面板(1)。
- 时间字段选
年份(2),空间字段选iso3(3),点运行检查(4)。字段框可以直接打字搜索:点一下框,输入“年”,回车。 - 读结果卡片(5):标题 已完成自动重排。灰色日志里先有一行
Error: The number of spatial units per year…,最后是Success——这是正常的检查过程信息。表格是按 iso3 字母排的,地图是按 Natural Earth 的顺序排的,软件把表格重排成地图的顺序。 - 记住:下一步数据来源要选检查后数据。可选:用(6)下载检查后的表格留档。
7.3.1 第一次用原始地图时的报错,以及怎么修
如果在步骤 A 载入的是未修复的 original_map\africa_countries.*,数据输入和数据检查都会成功,但点“运行模型”后状态行出现红字:
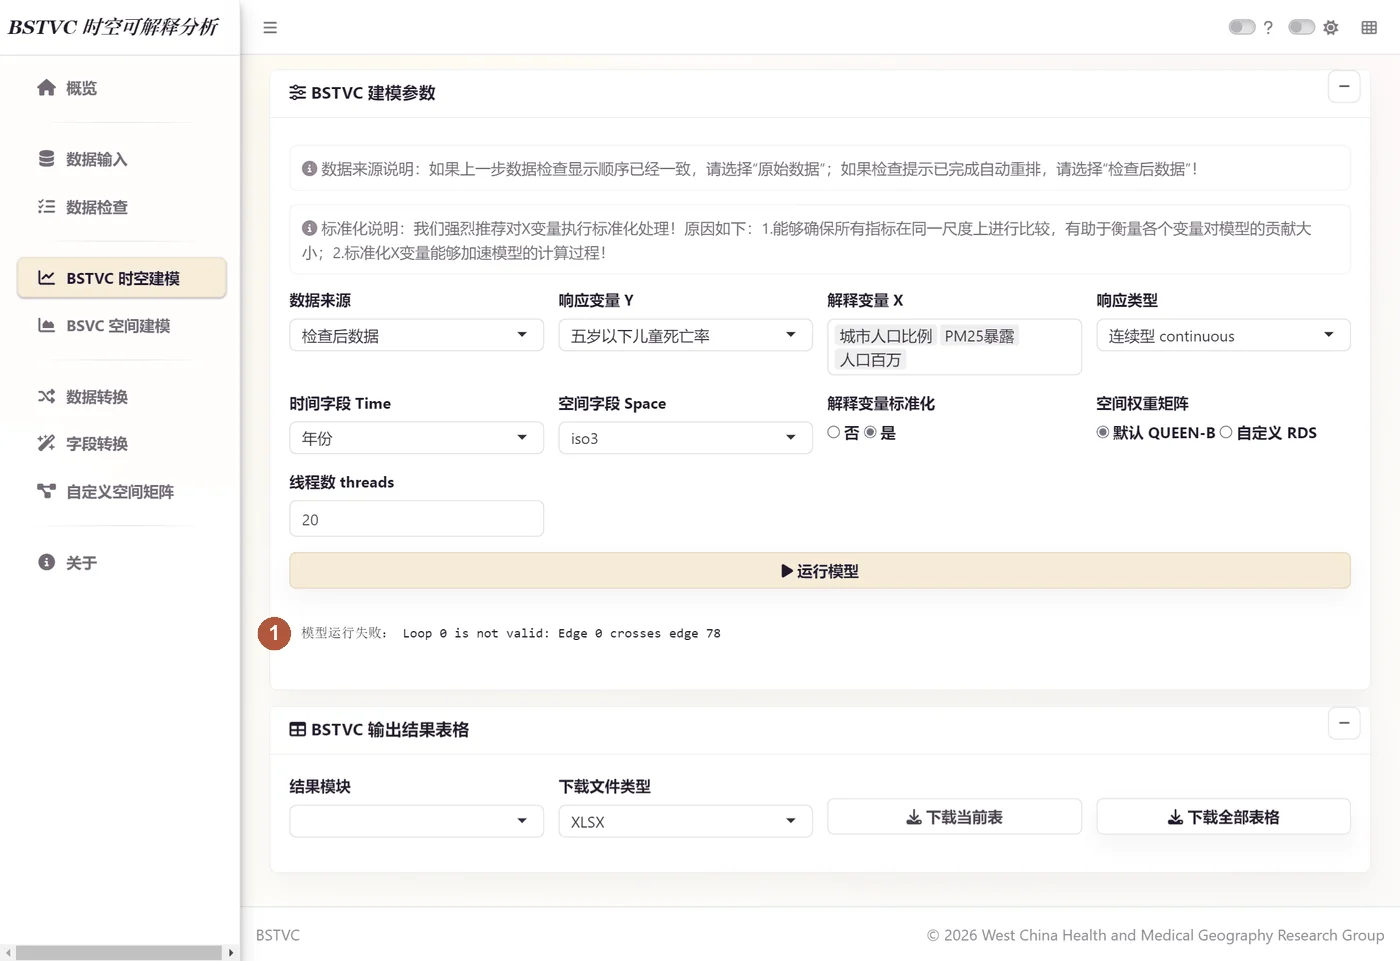
- 读懂报错。
Loop 0 is not valid: Edge 0 crosses edge 78的意思是:某个多边形的边界自己和自己交叉了。软件构建邻接关系时使用球面几何,会拒绝这种“在球面上无效”的多边形。 - 找出是哪一个。在 R 里运行
sf::sf_use_s2(TRUE); which(!sf::st_is_valid(sf::st_read("africa_countries.shp"))),结果指向苏丹(SDN)。它在平面地图上看起来完全正常。 - 修复并另存。把坐标吸附到 0.001° 网格(约 100 米)再修复几何,48 个多边形全部有效、没有孤立国家;存成新文件
africa_countries_v2.*,原图保留不动。 - 用新地图重来:重新数据输入 → 数据检查 → 建模,正常完成。
地图上苏丹的边界线在某处“打了个结”。平面上看不出来,但软件把地图放到地球仪上算邻居时卡住了。把边界理顺、另存一份,就好了。
sf::sf_use_s2(TRUE); all(sf::st_is_valid(sf::st_read("map.shp"))) 必须是 TRUE。7.4 步骤 C:BSTVC 建模
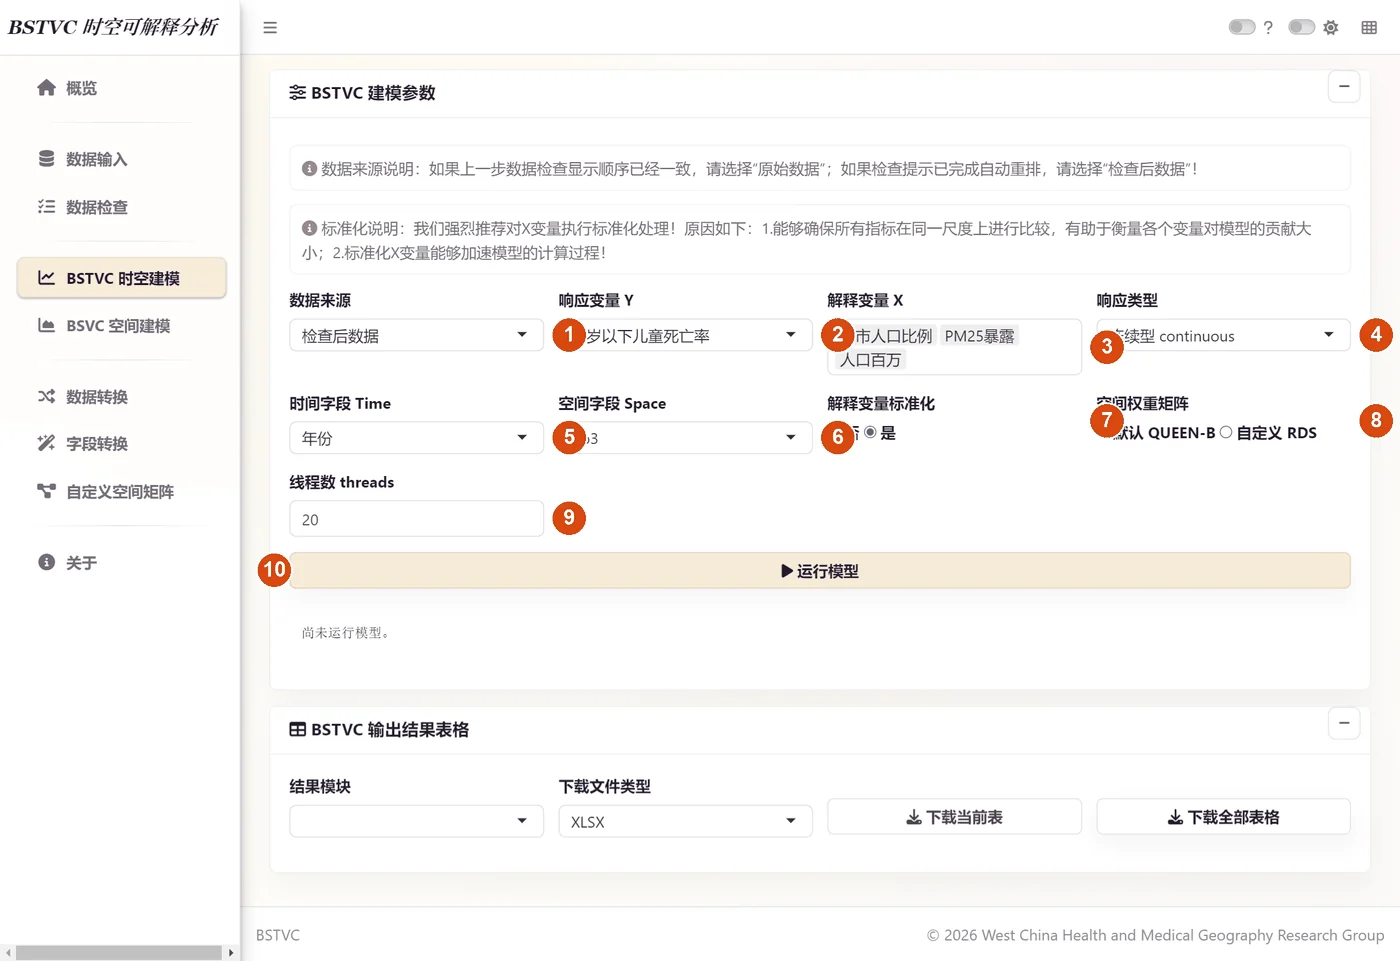
- 数据来源选检查后数据(1)。上一步提示已重排;选“原始数据”会让结果对错国家,而且不会报错。
- 响应变量 Y:
五岁以下儿童死亡率(2)。 - 解释变量 X:依次输入并回车
城市人口比例、PM25暴露、人口百万(3)。先用 3 个没有缺失的 X 跑通,再考虑加变量;不要选iso3、年份、Code、timeID、spaceID。 - 响应类型:连续型 continuous(4)。死亡率是正的连续数。
- 时间字段
年份(5),空间字段iso3(6)。 - 解释变量标准化:是(7);空间权重矩阵:默认 QUEEN-B(8);线程数:20(9)。
- 点运行模型(10)。页面变灰、显示“贝叶斯 STVC/SVC 模型正在运行,请稍候……”,本例 < 15 秒 完成。运行时不要点别的页面;窗口灰着就是在算。
7.5 步骤 D:结果与下载
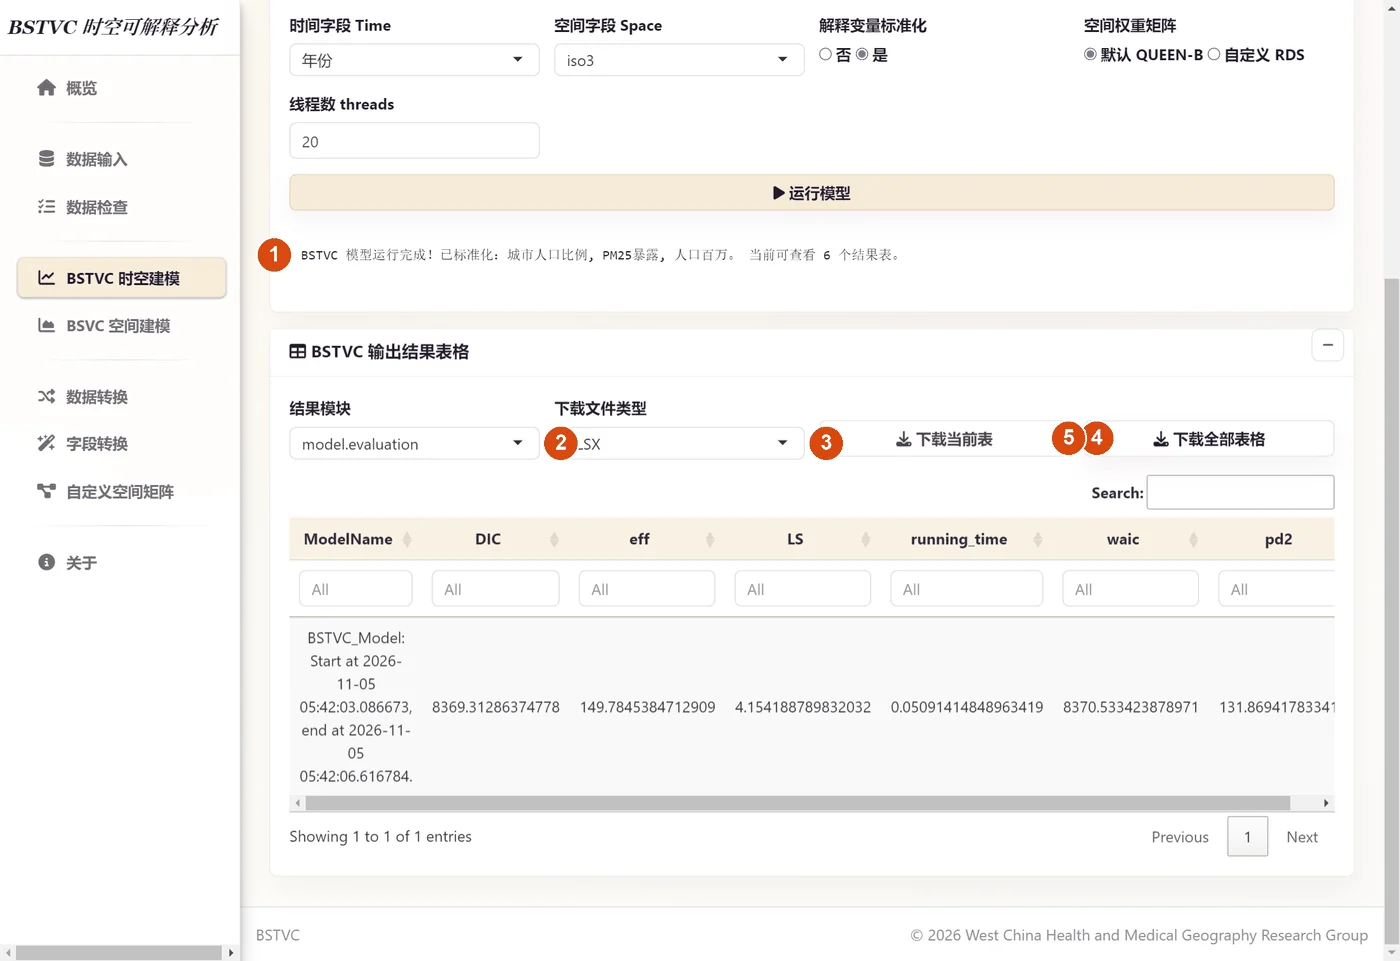
- 核对状态行(1):列出了哪些变量被标准化、有 6 个结果表。
- 点下载全部表格(5),在“另存为”里起名
Case1_Africa_U5MR_all_result_tables.xlsx,存到英文路径。一个工作簿 6 个 sheet;下一次运行会替换屏幕上的结果,所以每次跑完立刻存。 - 用结果模块(2)逐张查看;先看
model.evaluation。
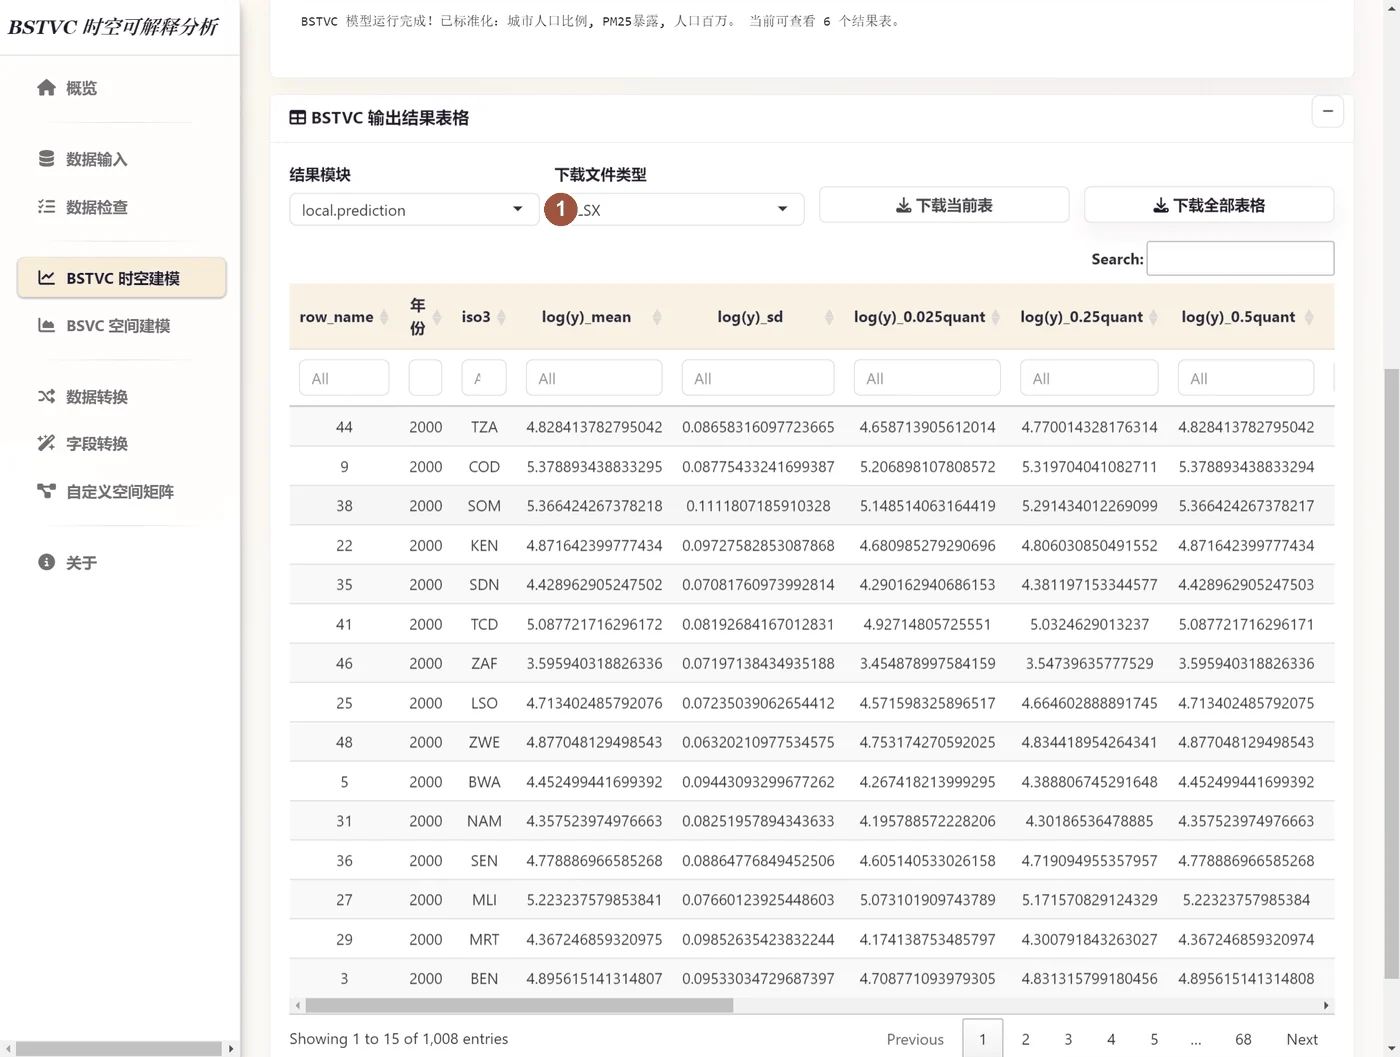
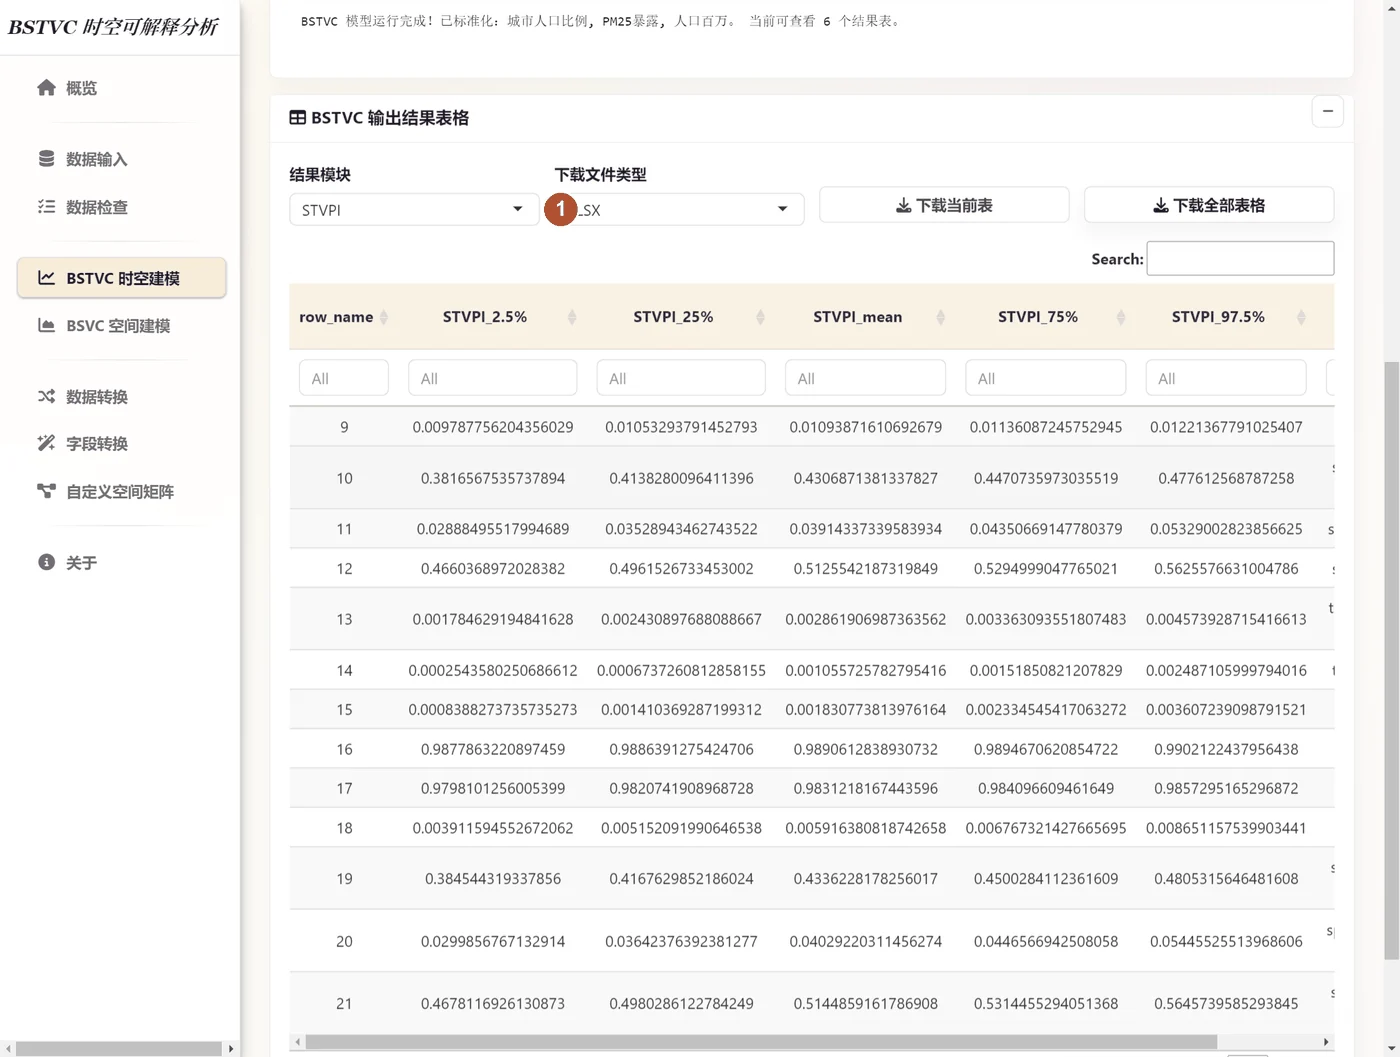
人口百万 51.4%、城市人口比例 43.4%、PM25暴露 4.0%。各 sheet:local.prediction 1008×18、time.coefficients 63×9(3 个变量 × 21 年)、space.coefficients 48×25。7.6 结果解读
- 先看评价:DIC 8,369、WAIC 8,371;拟合值与观测值 R² = 0.79。
- 谁更重要:STVPI 中空间部分占 98.3%,说明三个因素的作用主要是国家之间不同,而不是 2000–2020 年间在变。最重要的是
人口百万。 - 时间系数:表示某一年比 21 年平均强还是弱。时间部分只占 0.6%,偏离不大,但 V2 的区间很窄,趋势一目了然(图 2)。
- 空间系数:每个国家一个值,画成地图(图 3)就能看到哪里作用强、哪里弱;方向概率地图(图 3b)告诉你方向有几成把握;热点图(图 4)找成片的高值区和低值区。
在非洲,同样是城市化和人口规模,在不同国家和儿童死亡率的关系很不一样;而这种关系在 20 年里变化不大。所以政策重点是“因地制宜”,而不是“因时制宜”。
进阶 扩展:七个 X(其中四个有缺失)
把 X 增加到 7 个(再加入人均GDP、基本饮水服务覆盖率、电力可及率、卫生支出占GDP比重,各有 1.6–5.5% 缺失),其他设置不变:
人口百万 36.7%、基本饮水服务覆盖率 24.5%、城市人口比例 23.4%、人均GDP 12.4%、卫生支出占GDP比重 0.9%、电力可及率 0.8%、PM25暴露 0.4%。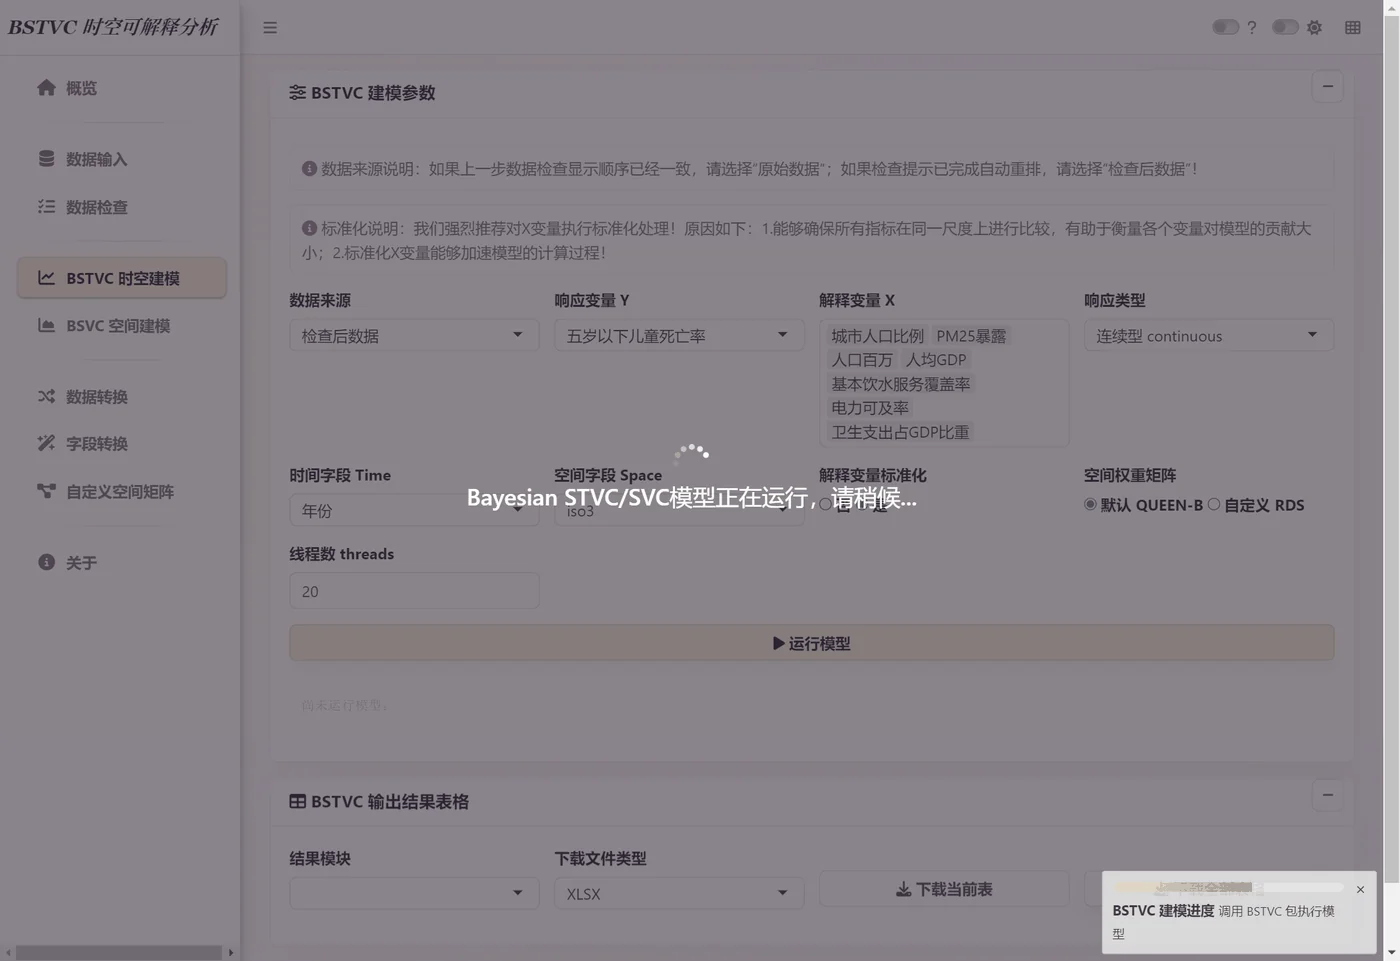
- 用时:同一设置旧版 V1 约 12 分钟,V2 约半分钟。
- DIC 与 WAIC:6,725 与 8,596。两者是不同的算法,数值不同属正常;比较模型时同一指标对同一指标。
- R² 从 3 个 X 的 0.793 提高到 0.901。
7.7 可视化与解读
结果工作簿可以直接画成论文图。代码和画好的图(中文、英文两套,300 dpi PNG + 矢量 PDF)都在 Case-01-Continuous-Africa-U5MR\visualization\:把 R 的工作目录设为该案例文件夹,运行 source("visualization/Case1_Africa_U5MR.R")。
本例的 R 代码(点开可复制)
# ==========================================================================================
#  怎么运行 / How to run
#  1. 安装一次 R 包 / install once:
#     install.packages(c("readxl","dplyr","tidyr","ggplot2","sf","patchwork","scales","RColorBrewer","classInt","ragg","systemfonts"))
#  2. 把工作目录设为本案例文件夹(纯英文路径)/ set the working directory to this case folder (ASCII path):
#     setwd("D:/BSTVC_data/Case-01-Continuous-Africa-U5MR")
#  3. source("visualization/Case1_Africa_U5MR.R")
#  图写到 visualization/outputs/<中文 zh | 英文 en>/;进阶模块的图在其中的 local_coef_module/。
#  换成你自己的结果:改下面 cfg 里的文件名、空间字段 key、结局类型和变量中英对照 var_en 即可。
# ==========================================================================================
# 案例 1:非洲 48 国五岁以下儿童死亡率,2000–2020(连续型)
# Case 1: under-five mortality in 48 African countries, 2000-2020 (continuous)
source("visualization/R/bstvc_plot_functions.R"); source("visualization/R/run_case.R")
source("visualization/R/bstvc_local_coef_functions.R"); source("visualization/R/run_local_coef.R")
cfg <- list(
  id = "Case1_Africa_U5MR", title = "案例 1 非洲五岁以下儿童死亡率", title_en = "Case 1 Africa under-five mortality",
  xlsx = "reference_results_V2/Case1_3X_V2_all_result_tables.xlsx", shp = "africa_countries_v2.shp", outdir = "visualization/outputs", key = "iso3",
  data = "africa_u5mr_panel_zh.csv",                 # 建模用数据:进阶模块取 X 值 / modelling table (covariate values)
  type = "continuous", standardized = TRUE, label_field = "name",
  t0 = 2000, tlab = "年份", tlab_en = "Year", time_col = "年份", pred_times = c(2000, 2010, 2020),
  pred_label = "五岁以下儿童死亡率(‰)", pred_label_en = "Under-five mortality (per 1,000)",
  var_en = c("城市人口比例" = "Urban population", "PM25暴露" = "PM2.5 exposure", "人口百万" = "Population"))

for (lang in c("zh", "en")) {
  run_case(modifyList(cfg, list(lang = lang)))          # 核心图 / core figures
  run_local_coef(modifyList(cfg, list(lang = lang)))    # 进阶模块(可选)/ optional SHAP-style module
}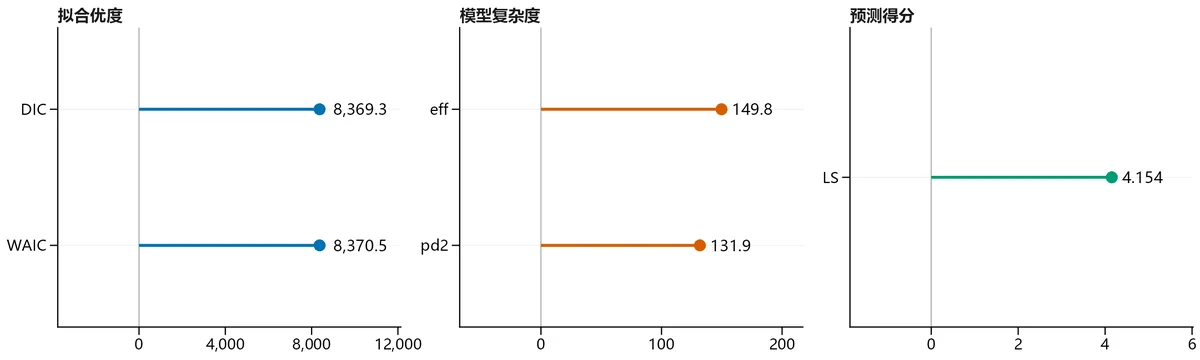
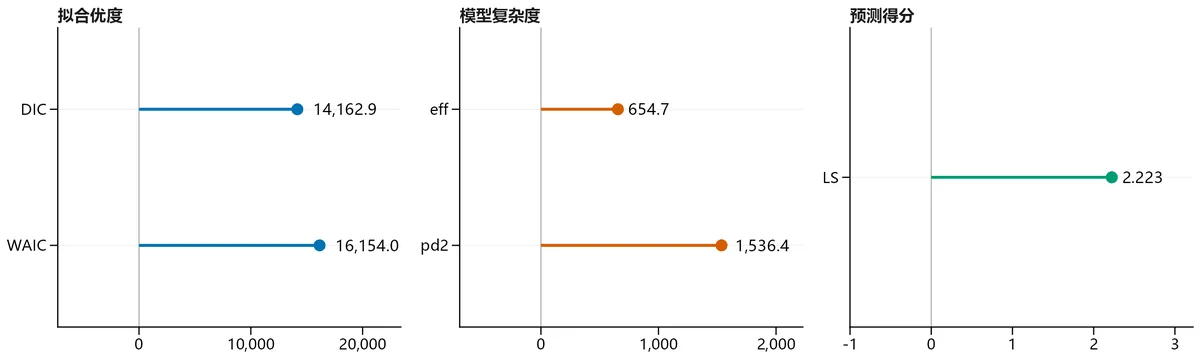
- 三组数字:拟合优度(DIC、WAIC)、模型复杂度(eff、pd2)、预测得分(LS)。
- DIC、WAIC、LS 越小越好,只在同一份数据、同一个 Y 的几个模型之间比较;DIC 和 WAIC 是两种算法,数值不同属正常。
- DIC 8,369.3,WAIC 8,370.5,LS 4.154;eff 149.8,pd2 131.9。
- 拟合值与观测值的一致程度:R² = 0.793。
- 每个小图一个因素;横轴是时间,0 线 = 整个研究时期的平均水平。
- 曲线在 0 以上:这个时点作用比平时更强(更正向);在 0 以下:更弱(更负向)。
- 深色带 = 50%、浅色带 = 95% 可信区间:带子越窄,越有把握。各小图纵轴刻度不同。
- 城市人口比例:从 0.149 到 −0.140,总体下降;最强在 2000 年,最弱在 2020 年。
- 人口百万:从 0.078 到 −0.073,总体下降;最强在 2000 年,最弱在 2019 年。
- PM25暴露:从 −0.010 到 0.016,总体上升;最强在 2014 年,最弱在 2008 年。
- 每幅地图一个因素,颜色 = 这个地区的空间系数:红 = 推高结局,蓝 = 拉低结局,颜色越深作用越强。
- 每幅地图各自分级,比较大小要看图例上的数值。
- 空间系数 = 这个地区在整个研究时期的平均作用;某地某时的完整作用 = 空间系数 + 该时点的时间系数。
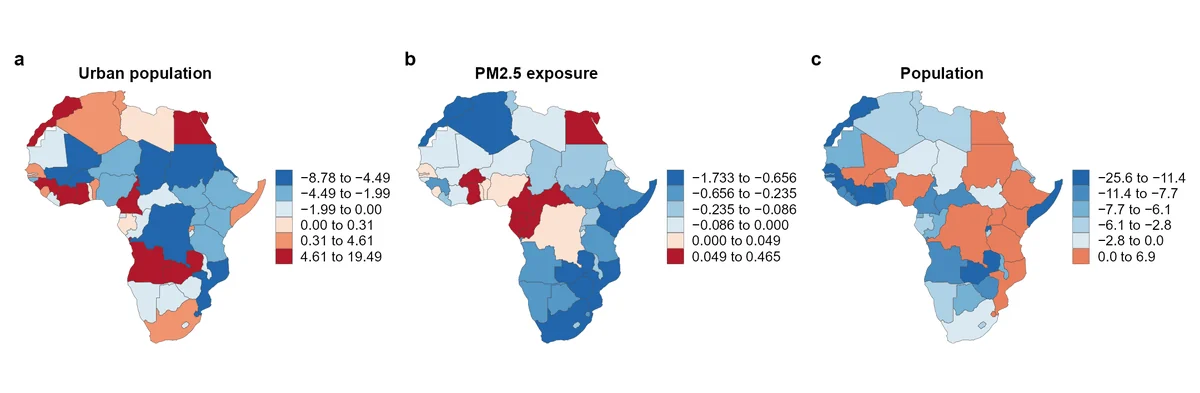
- 人口百万:从 −25.60(Ghana)到 6.86(eSwatini)。
- 城市人口比例:从 −8.78(Dem. Rep. Congo)到 19.49(Egypt)。
- PM25暴露:从 −1.73(South Africa)到 0.47(Egypt)。
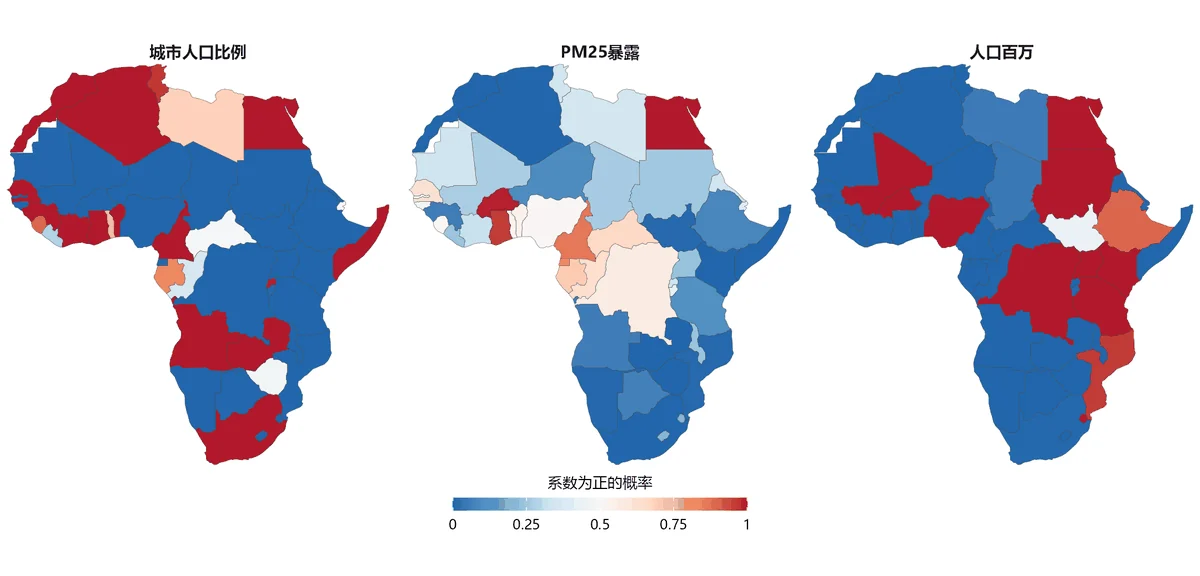
- 颜色 = 这个地区“作用为正”的概率,0 到 1 连续变化:越红越有把握“推高”,越蓝越有把握“拉低”,接近白色 = 方向还说不准。
- 和图 3 搭配看:图 3 看“作用多大”,图 3b 看“方向有几成把握”。
- 人口百万:25% 的地区“作用为正”的把握在八成以上,73% 的地区“作用为负”的把握在八成以上。
- 城市人口比例:35% 的地区“作用为正”的把握在八成以上,50% 的地区“作用为负”的把握在八成以上。
- PM25暴露:10% 的地区“作用为正”的把握在八成以上,35% 的地区“作用为负”的把握在八成以上。
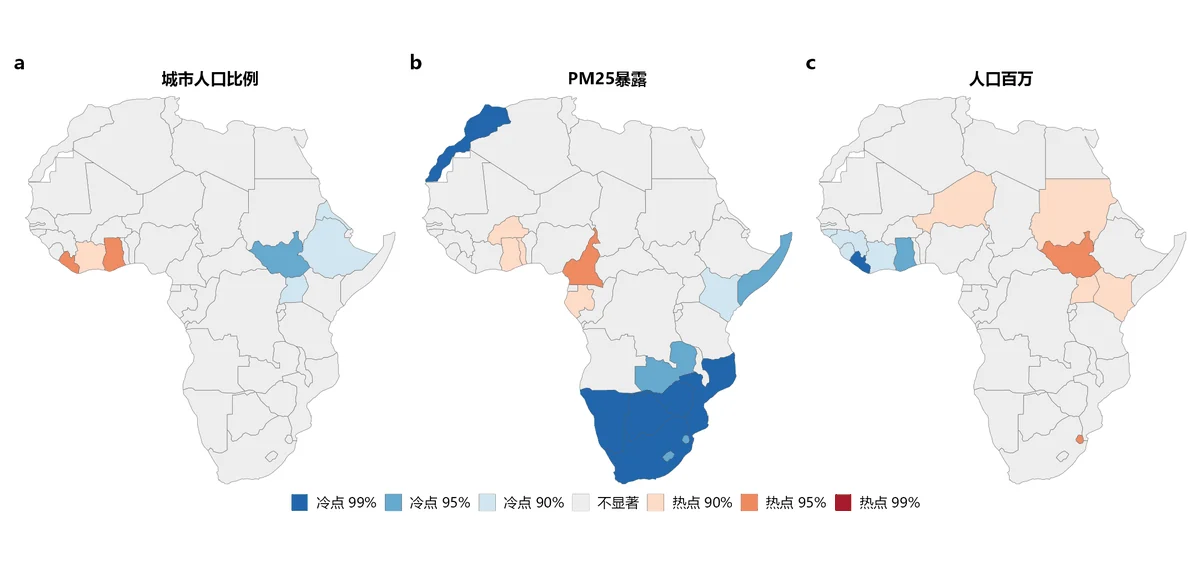
- 找出空间系数“成片偏高”(热点,红色)和“成片偏低”(冷点,蓝色)的区域;灰色 = 没有成片。
- 用来回答:作用特别强(或特别弱)的地区是不是连在一起,适合划定重点区域。
- 城市人口比例:热点 2 个(如 Liberia、Ghana),冷点 1 个(如 S. Sudan)。
- PM25暴露:热点 1 个(如 Cameroon),冷点 10 个(如 Zimbabwe、Botswana、Mozambique)。
- 人口百万:热点 2 个(如 S. Sudan、eSwatini),冷点 2 个(如 Liberia、Ghana)。
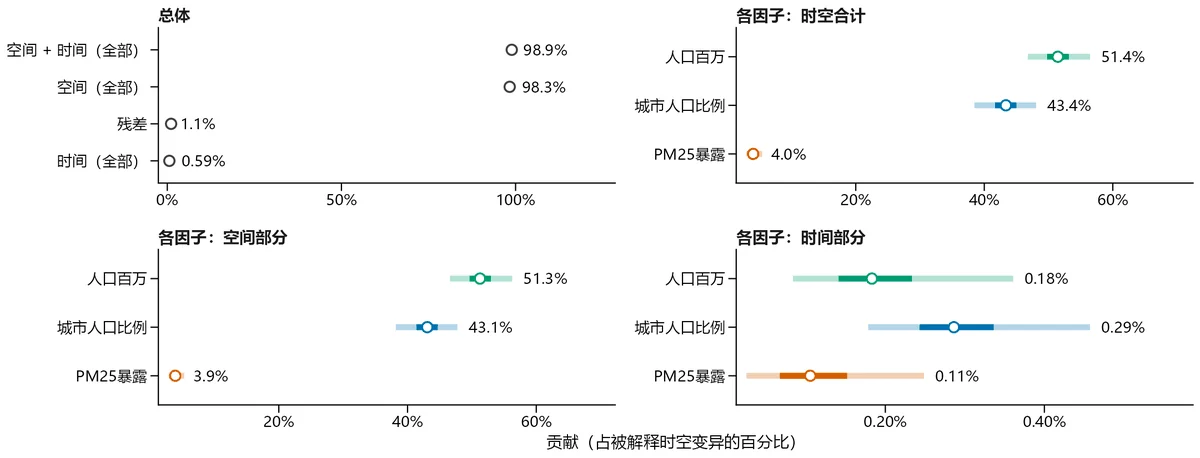
- 左上“总体”:结局的时空差异里,空间部分、时间部分各占多少。
- 其余面板:每个因素的贡献(时空合计、空间部分、时间部分);圆圈 = 估计值,粗、细条 = 50%、95% 可信区间。
- 只有解释变量标准化后,不同因素的百分比才能互相比较。
- 各因素(空间 + 时间合计):
人口百万51.4%、城市人口比例43.4%、PM25暴露4.0%。 - 区间重叠很多的因素,排名不要说得太死。
- 一根条 = 一个因素,条长 = 它的总贡献;两段颜色 = 空间部分和时间部分。
- 条最长的因素是本研究的关键因素候选;空间段占绝大部分 → “因地制宜”;时间段明显 → 还要“因时制宜”。
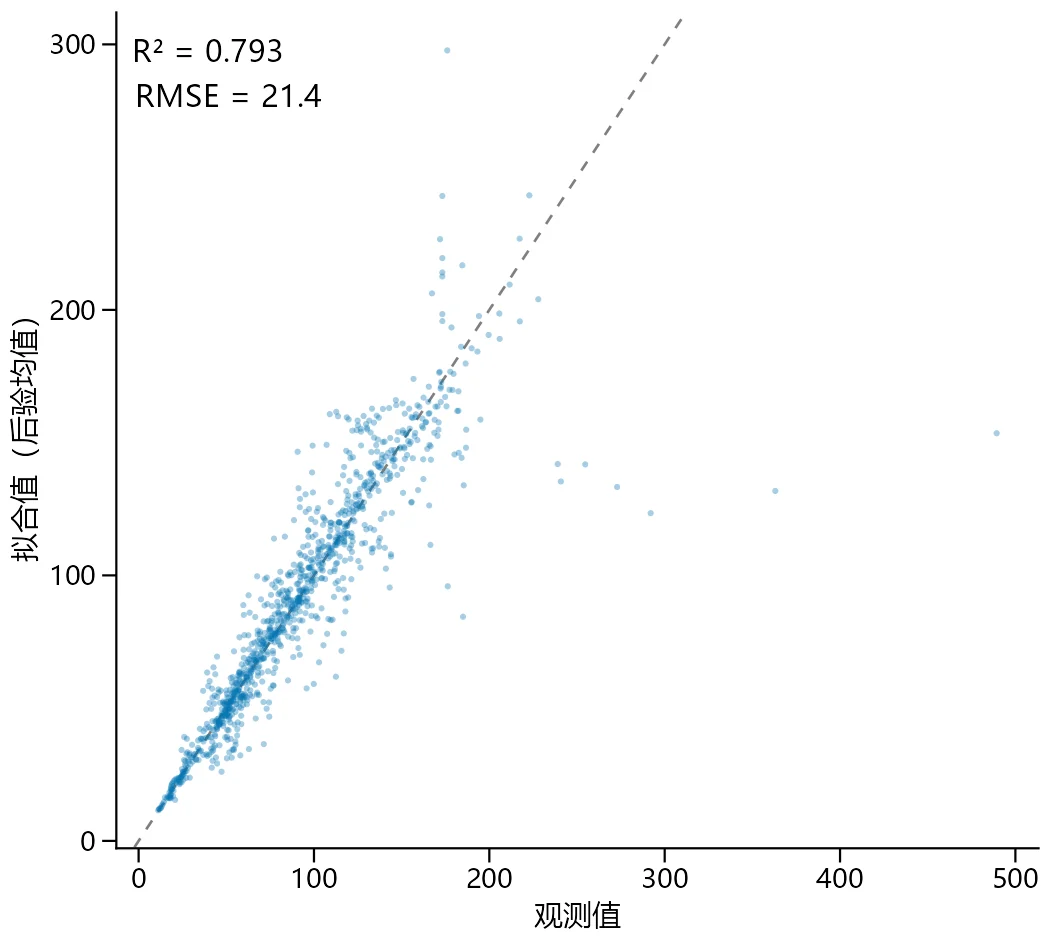
- 横轴观测值,纵轴模型拟合值;点越贴近虚线越好。
- R² 越接近 1 越好;RMSE 是平均误差的大小(和 Y 同单位)。
- R² = 0.793,RMSE = 21.40(1008 个有观测的单元)。
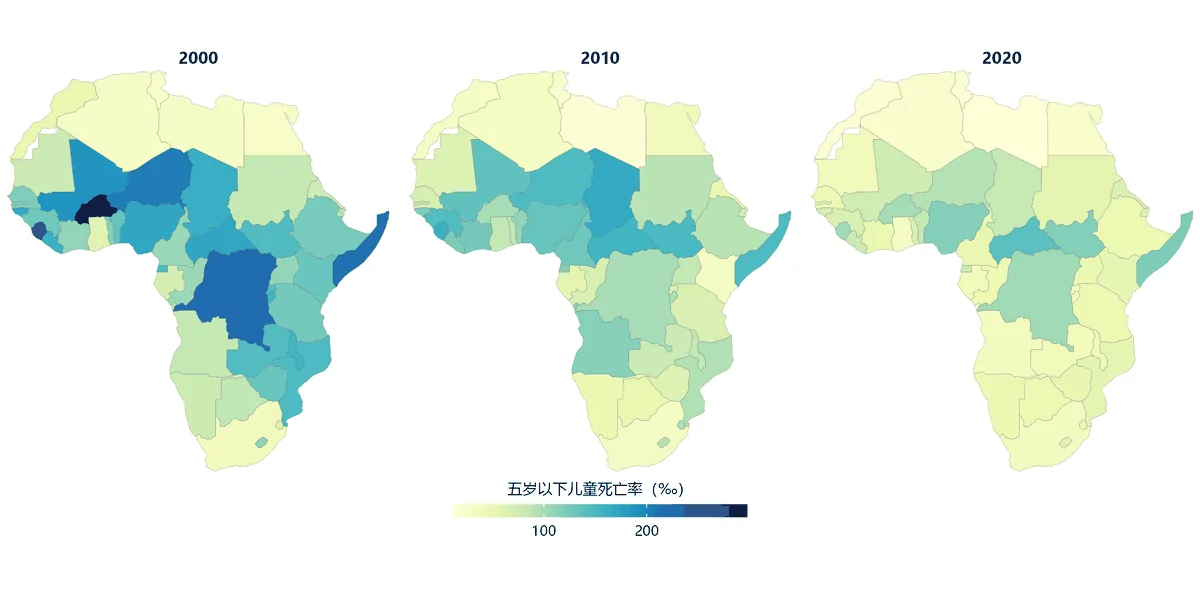
- 几个时点并排,共用同一色标:颜色的变化就是时间上的变化。
- 原数据里缺失的地区和年份也有拟合值,可用于补缺。
- 对比首末时点,看结局整体升降和空间格局有没有变。
想更深入地挖掘各地区的局部系数?本案例的全套类 SHAP 进阶图见第 14 章对应小节。
8 案例 2 · 二分类:中国 31 省 2020 年新冠疫情发生状态(宽表 → 面板)
8.1 案例卡:数据、来源与变量
| 项目 | 内容 |
|---|---|
| 文件夹 | Case-02-Binary-China-COVID-19(官方示例数据,变量名改为中文) |
| 表格 | Covid_Binary_Panel_zh.xlsx——名字叫 Panel,其实是宽表:31 行 × 86 列,列名 = 变量名 + 年月(如 PM25浓度202001) |
| 地图 | China_Provincial_Map\ChinaProv.*(5 个文件 + .sbn/.sbx;原名带空格,已改为 ChinaProv) |
| 来源 | 国家卫生健康委员会(疫情)、多源遥感、气象与环境监测平台、百度迁徙大数据 |
| 空间 / 时间 | gb(省级行政区划代码,数值)/ 转换后新建的 月份(1–12) |
| Y | 疫情发生:当月是否发生疫情(0 = 否,1 = 是) |
| X(6 个) | 官方原文件中这 6 个 X 已是标准化值(z 分数,均值 0、标准差 1),原始单位未提供。PM25浓度、平均气温、植被指数(NDVI)、夜间灯光指数、迁入规模指数、迁出规模指数(迁徙指数有成片缺失,保留 NA) |
| 设置 | 二分类 · 检查后数据 · 标准化 = 是 · QUEEN-B · 线程 20 |
8.2 步骤 A:数据转换(宽表 → 面板)
宽表里每个变量的每个月各占一列,要把它们“竖着摞起来”变成 31 × 12 = 372 行。
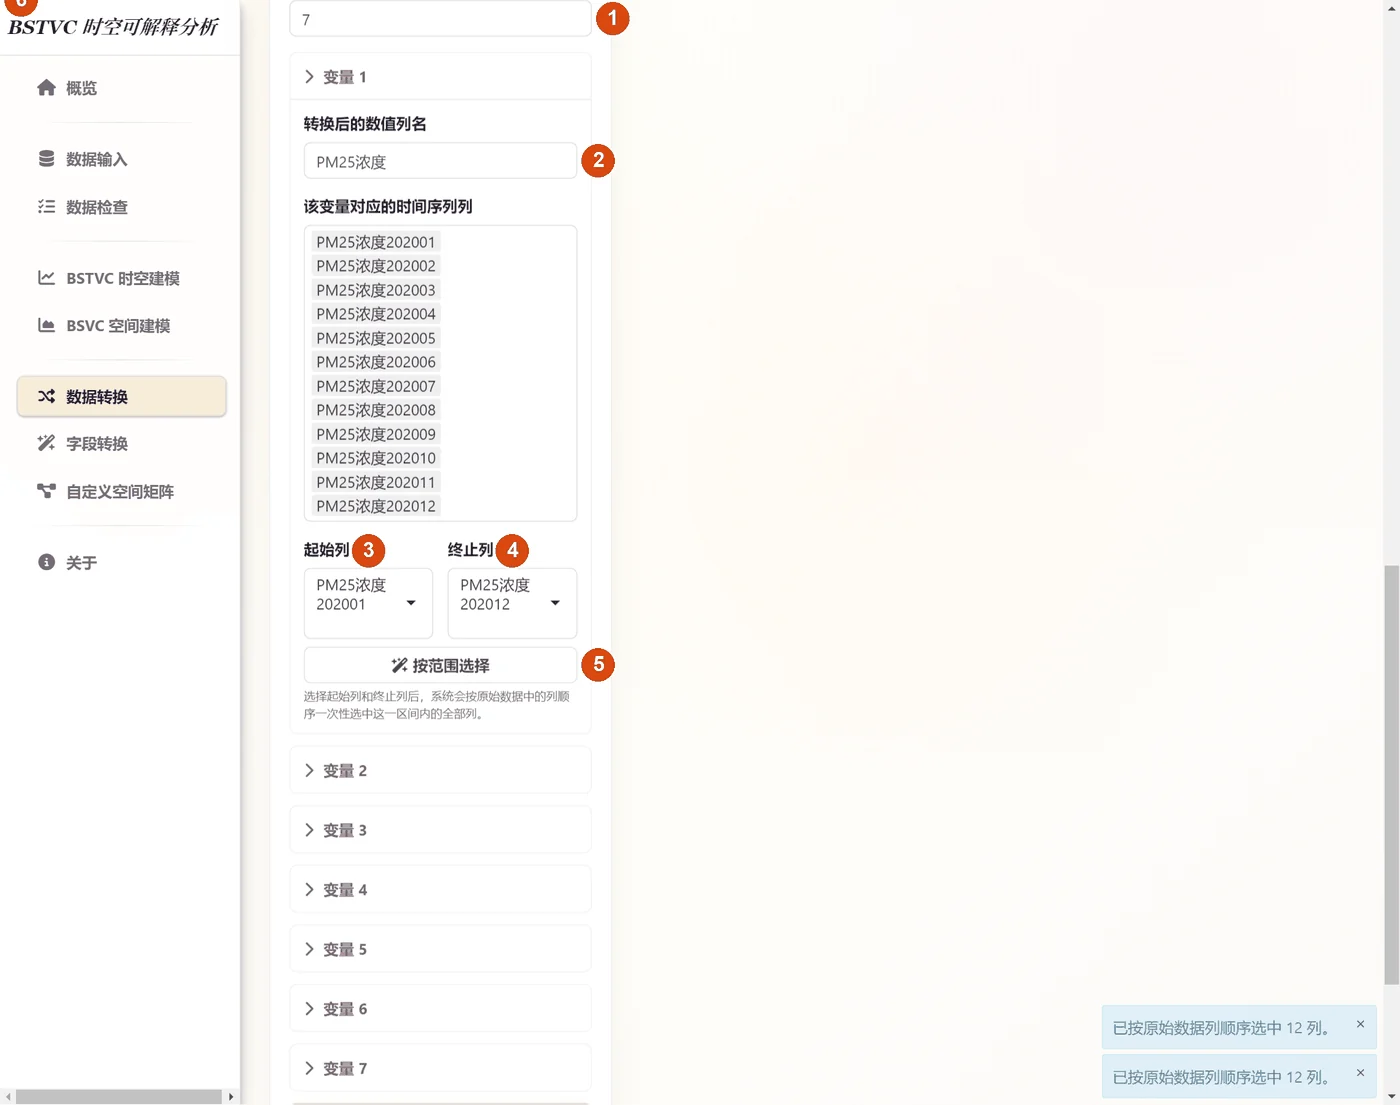
- 点数据转换。在“空间截面原始数据(CSV / Excel)”选
Covid_Binary_Panel_zh.xlsx,点读取转换数据。左边预览 31 行;“数据类型检查”卡片报告这是宽表,并数出带时间标记的列。 - id 列(每个时间点不变):
gb。id 列在每一行里都会被复制 12 次,是以后连接地图的钥匙。省份名称列不要选进变量块。 - 时间序列(数值型):
1:12;新时间列名:月份。“1:12”表示新时间列依次取 1, 2, …, 12,对应每个变量块里的第 1–12 列。 - 需要转换的变量个数:
7(1),出现 7 个可折叠的变量块。6 个 X + 1 个 Y,一共 7 个变量要转换。 - 展开“变量 1”,转换后的数值列名:
PM25浓度(2)。 - 起始列
PM25浓度202001(3)、终止列PM25浓度202012(4),点按范围选择(5)。灰色框(6)按时间顺序列出 12 列。列必须按 1 月 → 12 月的顺序;如果列不连续,就在灰框里一列一列地选。 - 其余 6 个变量照做:
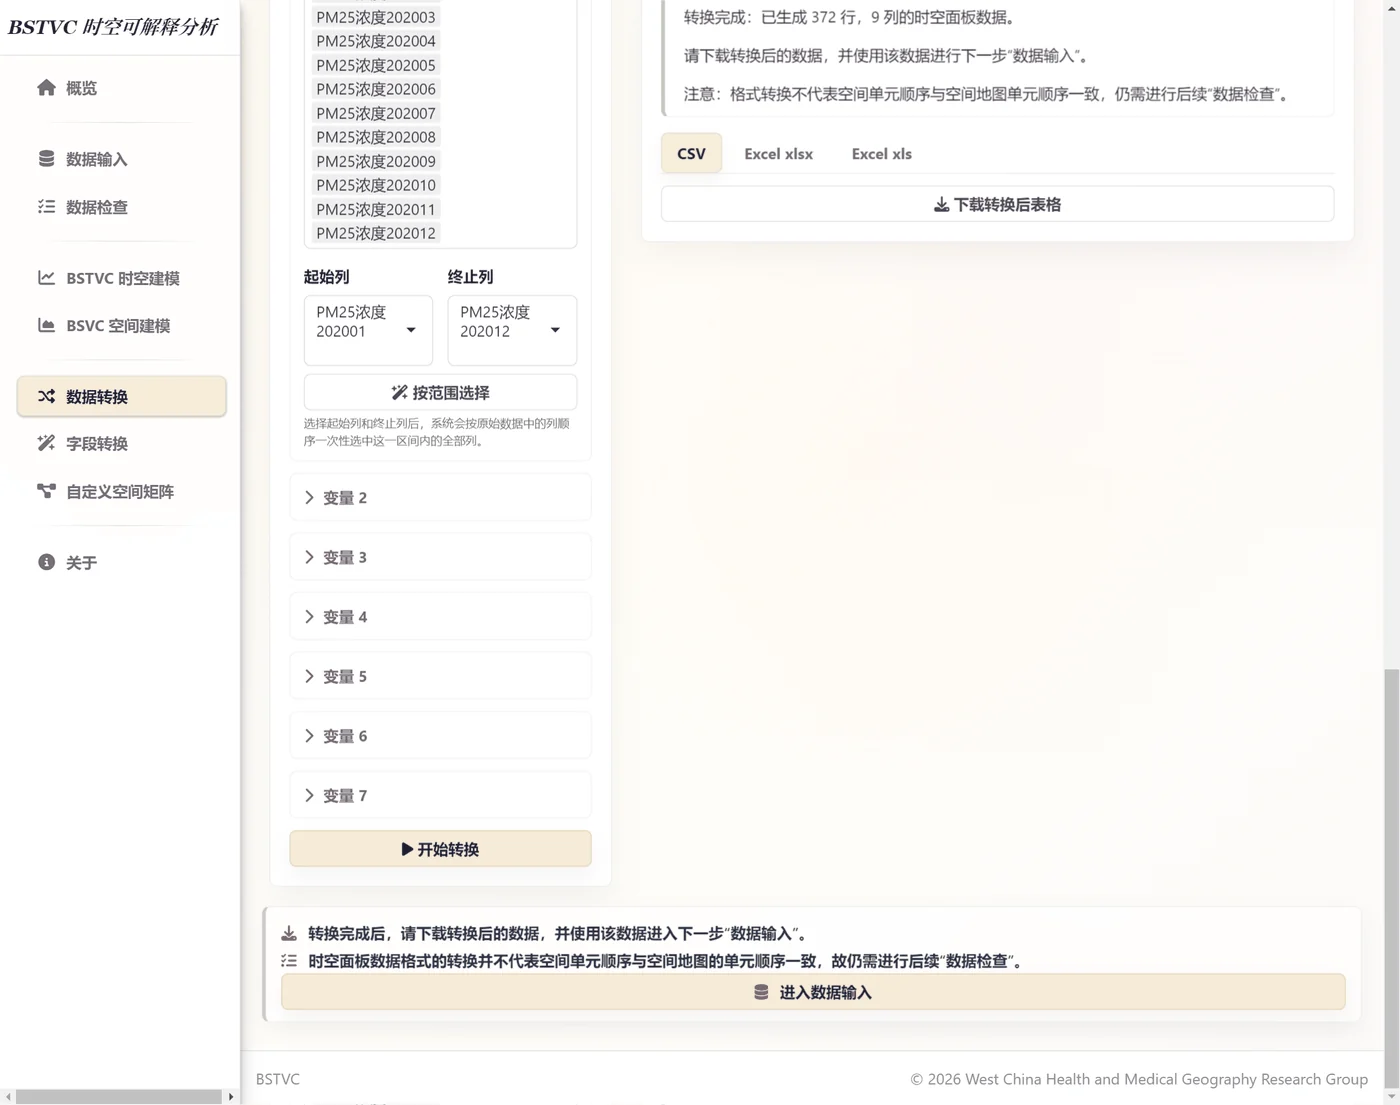
平均气温、植被指数、夜间灯光指数、迁入规模指数、疫情发生、迁出规模指数。每个变量都必须恰好 12 列。 - 点开始转换,右侧出现“转换完成:已生成 372 行,9 列的时空面板数据”(9 列 = gb + 月份 + 7 个变量)。
- 在下载格式里点 Excel xlsx,再点下载转换后表格,存为
BSTVC_panel_converted_zh.xlsx。默认格式是 CSV(UTF-8、没有 BOM):含中文的 CSV 用 Excel 打开会乱码。软件自己也提示“Excel 格式通常受影响较小”。
8.3 步骤 B:数据输入
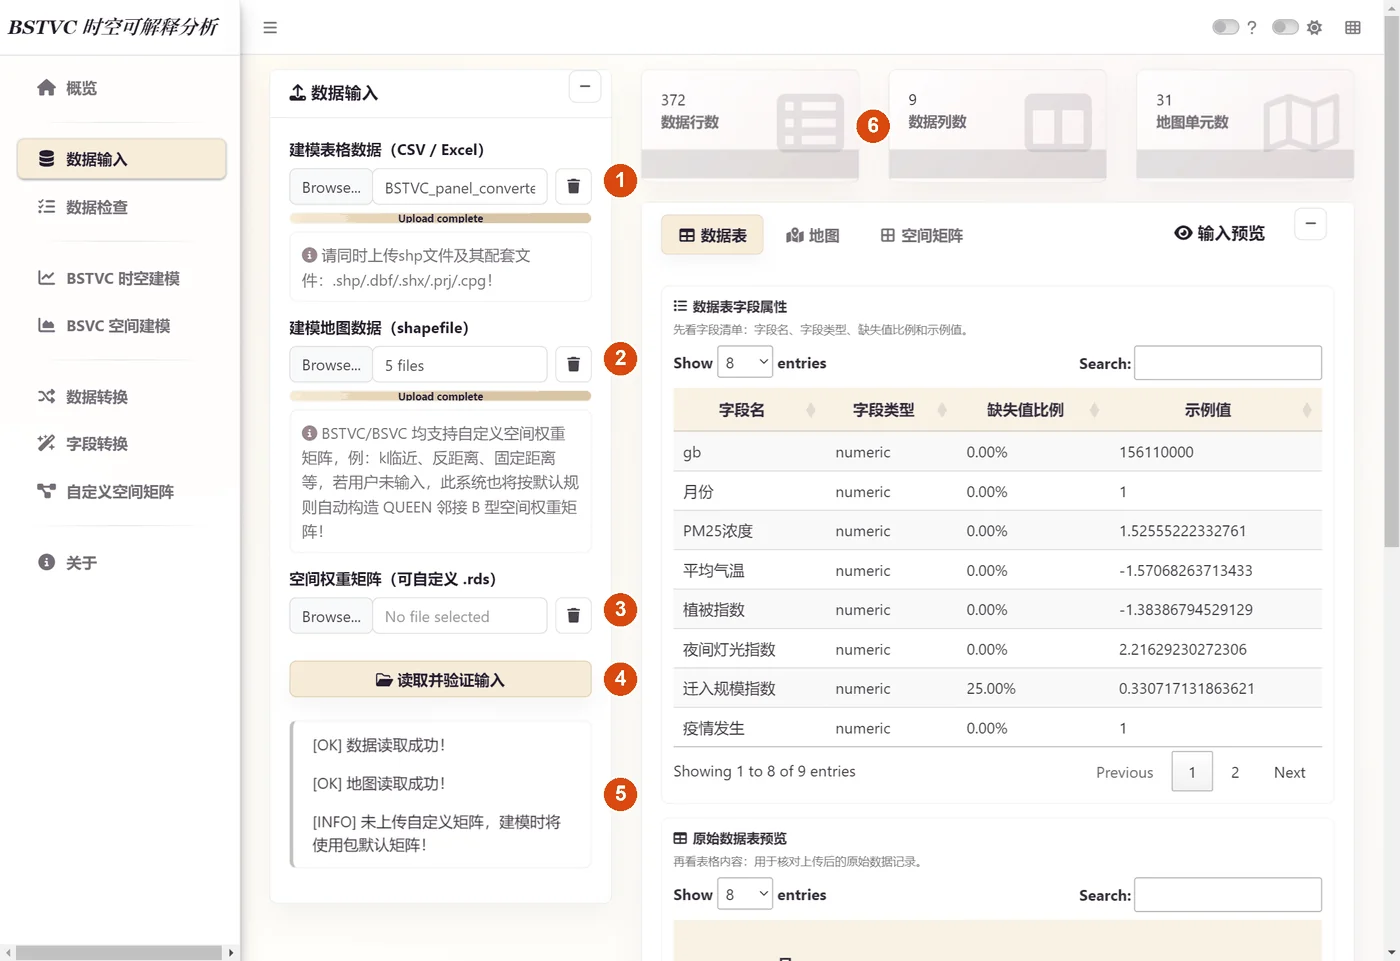
- 表格选转换后的
BSTVC_panel_converted_zh.xlsx(1),不是原来的宽表。 - 地图选
ChinaProv的全部文件(2),点读取并验证输入(4)。 - 核对:372 行、9 列、31 个地图单元(6)。
8.4 步骤 C:数据检查
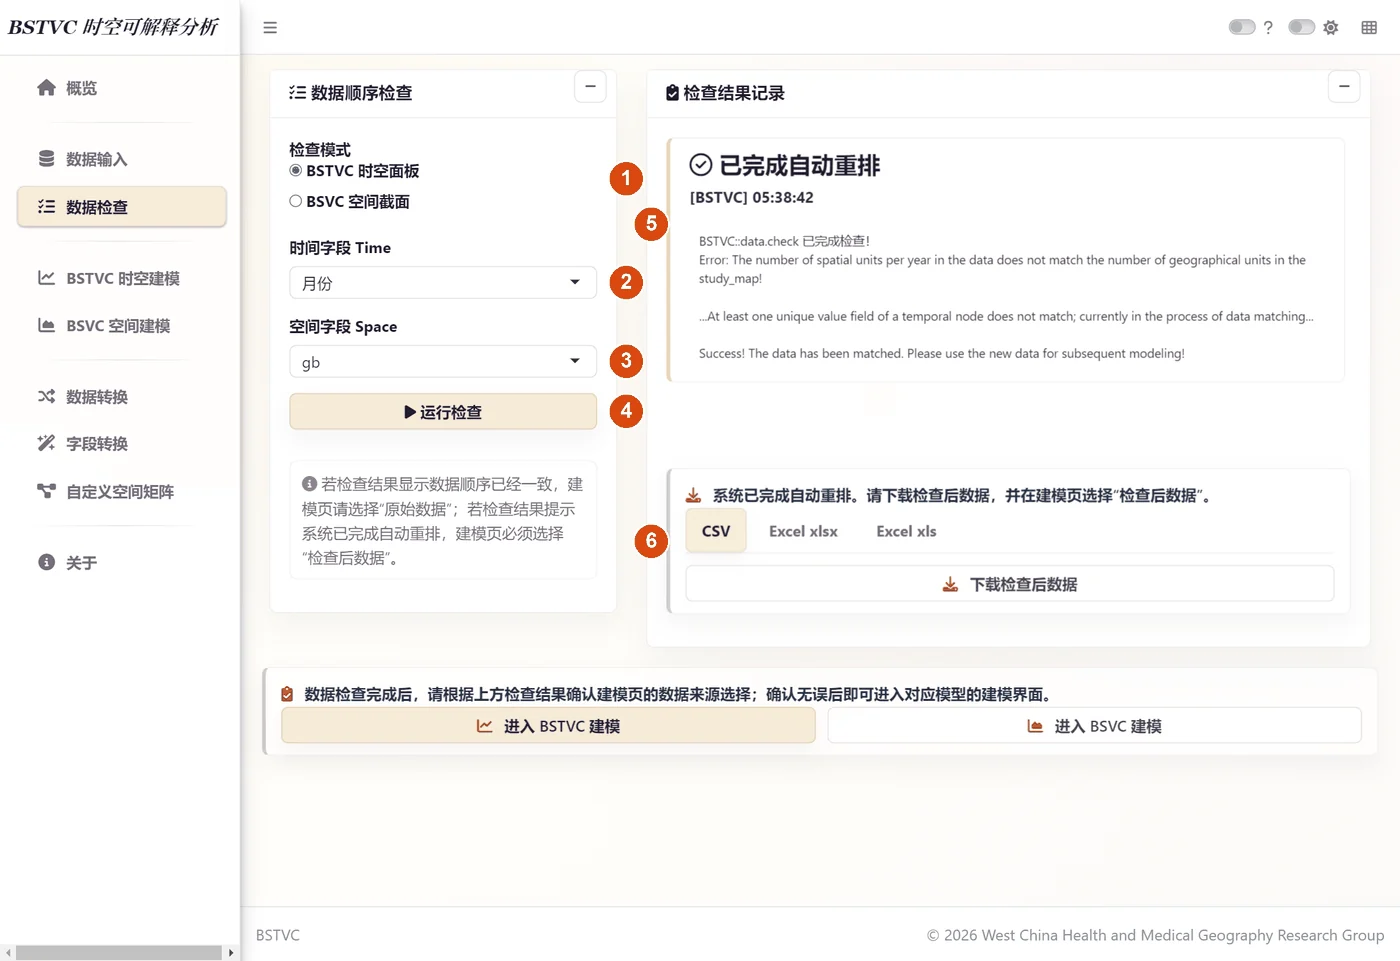
时间字段 月份、空间字段 gb → 运行检查 → 卡片标题 已完成自动重排 → 建模时选“检查后数据”。
8.5 步骤 D:建模与下载
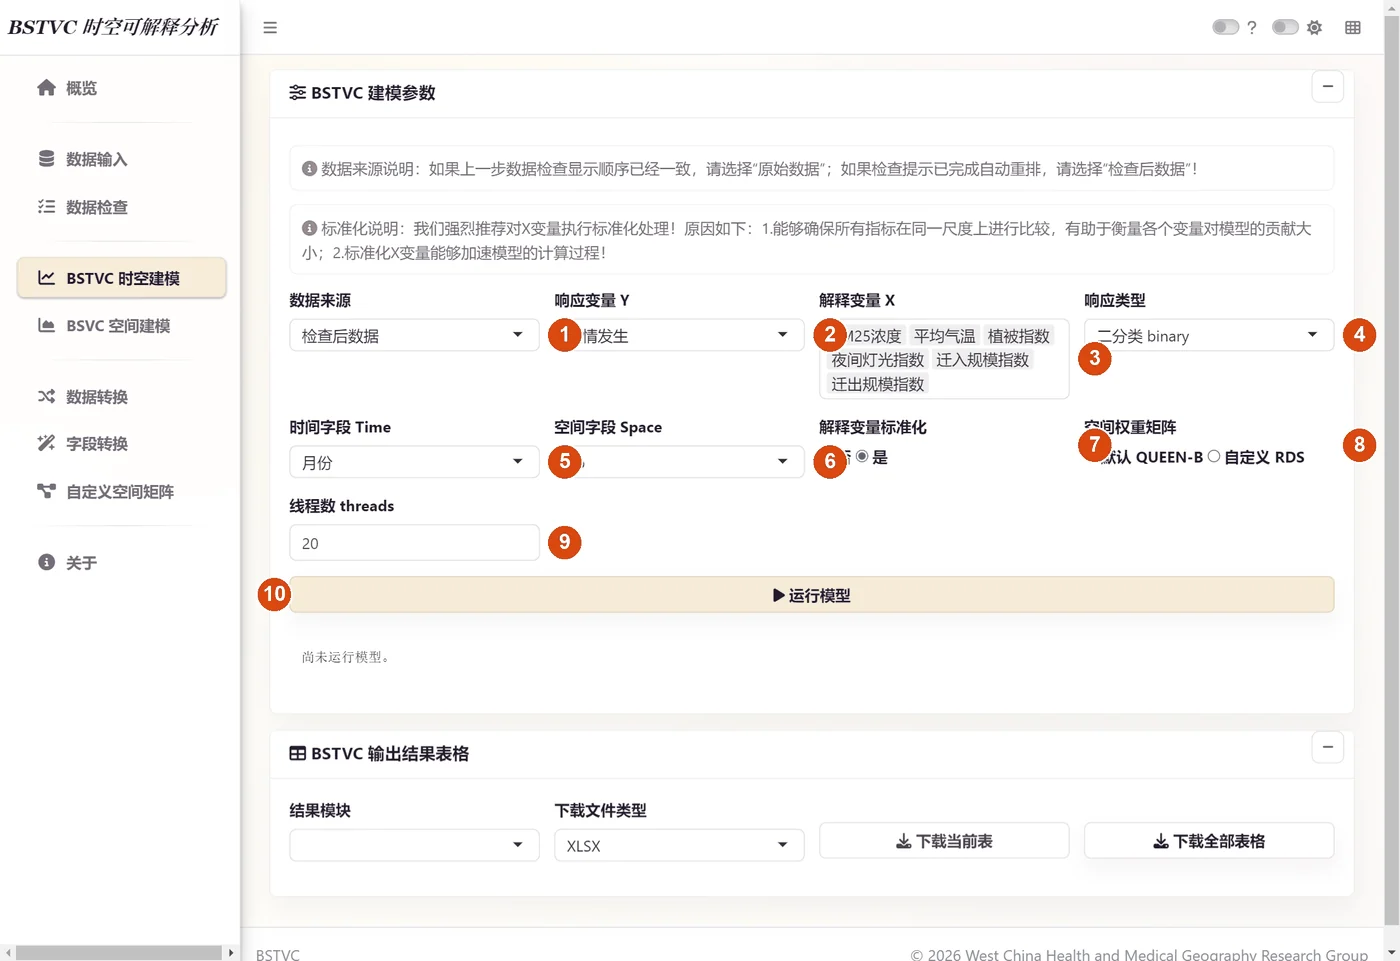
- 数据来源检查后数据(1);Y
疫情发生(2);X 依次选 6 个:PM25浓度、平均气温、植被指数、夜间灯光指数、迁入规模指数、迁出规模指数(3)。 - 响应类型 = 二分类 binary(4)——不要停在默认的“连续型”。结局只有 0 和 1。
- 时间
月份(5)、空间gb(6)、标准化 = 是、QUEEN-B、线程 20,运行模型(10)。< 15 秒 完成。 - 下载全部表格。
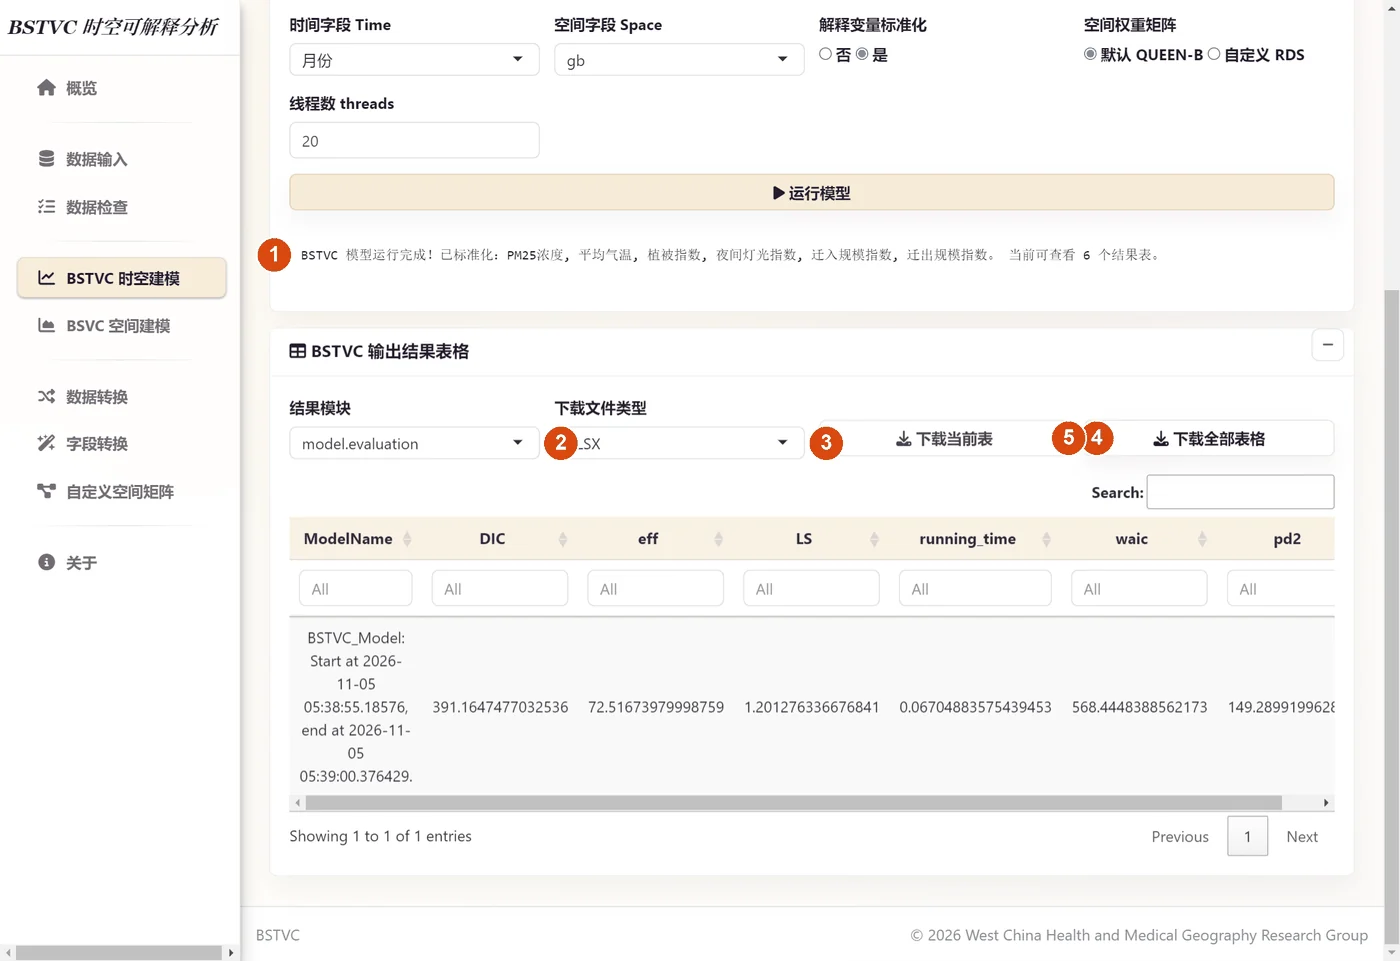
夜间灯光指数 39.0%、PM25浓度 23.5%、平均气温 11.6%、植被指数 7.3%、迁入规模指数 6.8%、迁出规模指数 6.3%。time.coefficients 72 行(6 × 12),space.coefficients 31 行。- 一句话
- 随便挑一个“发生了疫情”的省月和一个“没发生”的省月,模型给前者打的分更高的概率。
- 打个比方
- 像让模型给两个学生排名次:AUC = 0.95 表示 100 次里有 95 次排对了谁考得更好。
- 为什么要用
- 二分类结局不能用 R²;AUC 不受“阈值取 0.5 还是 0.3”的影响。
- 怎么用
- 0.5 = 瞎猜,0.7–0.8 可接受,0.9 以上很好。注意它是在同一批数据上算的(训练拟合),不是对新数据的预测能力。
- 讲给别人听
- “AUC 0.94,说明模型很会区分发生和没发生疫情的省份月份。”
local.prediction 的 predict_y(后验均值概率)对观测 y 计算。8.6 结果解读
- 谁更重要:夜间灯光指数 的 STVPI 最大;与其他案例相比,本例时间部分占比高(25.8%),说明这些因素的作用在 2020 年的不同月份确实在变——符合疫情从年初暴发到后期零散发生的过程。
- 时间系数:例如平均气温的时间系数从 1 月的负值逐月升到年底的正值:相对全年平均,年初气温与疫情发生的关联更负、年底更正(图 2)。
- 空间系数:见图 3 和图 3b。海南没有陆上邻居,模型借不到邻居的信息,它的系数接近 0,论文中要单独说明,不要当成“证据很强”。
疫情发生与夜间灯光(经济活动、人口聚集)的关联最强,而且这些关联在一年里明显在变;海南是个“孤岛”,模型借不到邻居的信息,它的结果要单独看。
8.7 可视化与解读
结果工作簿可以直接画成论文图。代码和画好的图(中文、英文两套,300 dpi PNG + 矢量 PDF)都在 Case-02-Binary-China-COVID-19\visualization\:把 R 的工作目录设为该案例文件夹,运行 source("visualization/Case2_COVID.R")。
本例的 R 代码(点开可复制)
# ==========================================================================================
#  怎么运行 / How to run
#  1. 安装一次 R 包 / install once:
#     install.packages(c("readxl","dplyr","tidyr","ggplot2","sf","patchwork","scales","RColorBrewer","classInt","ragg","systemfonts"))
#  2. 把工作目录设为本案例文件夹(纯英文路径)/ set the working directory to this case folder (ASCII path):
#     setwd("D:/BSTVC_data/Case-02-Binary-China-COVID-19")
#  3. source("visualization/Case2_COVID.R")
#  图写到 visualization/outputs/<中文 zh | 英文 en>/;进阶模块的图在其中的 local_coef_module/。
#  换成你自己的结果:改下面 cfg 里的文件名、空间字段 key、结局类型和变量中英对照 var_en 即可。
# ==========================================================================================
# 案例 2:中国 31 省 2020 年逐月新冠疫情发生状态(二分类)。地图仅为案例展示。
# Case 2: monthly COVID-19 occurrence in 31 Chinese provinces, 2020 (binary). Map for illustration only.
source("visualization/R/bstvc_plot_functions.R"); source("visualization/R/run_case.R")
source("visualization/R/bstvc_local_coef_functions.R"); source("visualization/R/run_local_coef.R")
cfg <- list(
  id = "Case2_COVID", title = "案例 2 中国新冠疫情发生状态", title_en = "Case 2 COVID-19 occurrence",
  xlsx = "reference_results_V2/Case2_COVID_V2_all_result_tables.xlsx", shp = "China_Provincial_Map/ChinaProv.shp", outdir = "visualization/outputs", key = "gb",
  data = "Covid_Binary_Panel_zh.xlsx", wide = list(suffix = sprintf("2020%02d", 1:12), times = 1:12), label_col = "省份",
  type = "binary", standardized = TRUE, label_field = "name",
  t0 = 1, tlab = "月份(2020 年)", tlab_en = "Month (2020)", time_col = "月份", pred_times = c(1, 3, 5, 7, 9, 11),
  time_labels = setNames(paste0(1:12, "月"), 1:12), time_labels_en = setNames(month.abb, 1:12),
  pred_label = "预测概率", pred_label_en = "Fitted probability",
  map_note = "注:地图仅为案例展示,实际使用请依据国家标准地图重新绘制。",
  map_note_en = "Note: map for illustration only; redraw with an officially approved base map for publication.",
  var_en = c("PM25浓度" = "PM2.5", "平均气温" = "Mean temperature", "植被指数" = "NDVI", "夜间灯光指数" = "Night-time light",
             "迁入规模指数" = "In-migration index", "迁出规模指数" = "Out-migration index"))

for (lang in c("zh", "en")) {
  run_case(modifyList(cfg, list(lang = lang)))          # 核心图 / core figures
  run_local_coef(modifyList(cfg, list(lang = lang)))    # 进阶模块(可选)/ optional SHAP-style module
}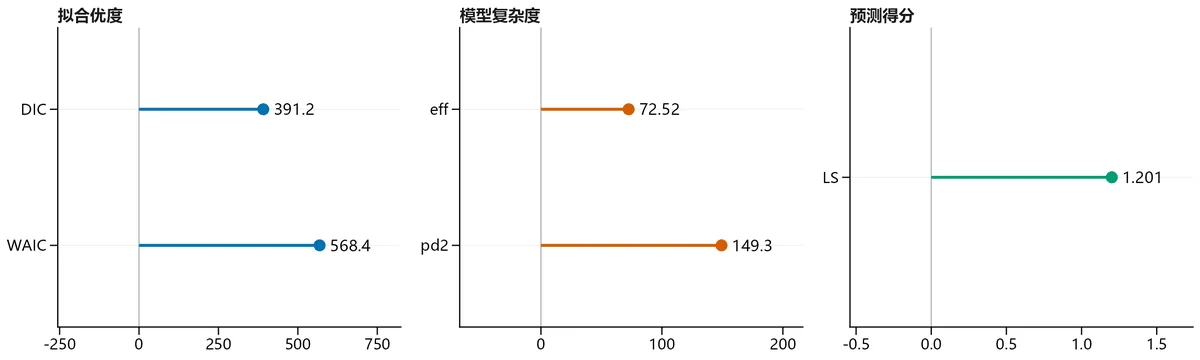
- 三组数字:拟合优度(DIC、WAIC)、模型复杂度(eff、pd2)、预测得分(LS)。
- DIC、WAIC、LS 越小越好,只在同一份数据、同一个 Y 的几个模型之间比较;DIC 和 WAIC 是两种算法,数值不同属正常。
- DIC 391.2,WAIC 568.4,LS 1.201;eff 72.5,pd2 149.3。
- 拟合值与观测值的一致程度:AUC = 0.938。
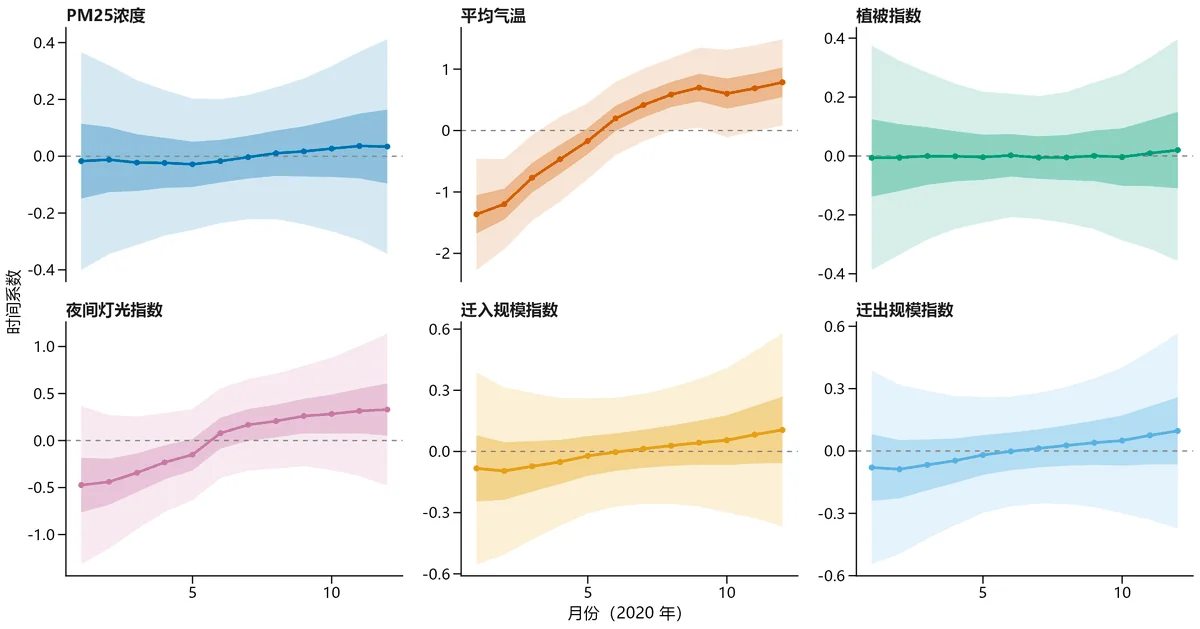
- 每个小图一个因素;横轴是时间,0 线 = 整个研究时期的平均水平。
- 曲线在 0 以上:这个时点作用比平时更强(更正向);在 0 以下:更弱(更负向)。
- 深色带 = 50%、浅色带 = 95% 可信区间:带子越窄,越有把握。各小图纵轴刻度不同。
- 平均气温:从 −1.365 到 0.785,总体上升;最强在 12 月,最弱在 1 月。
- 夜间灯光指数:从 −0.474 到 0.329,总体上升;最强在 12 月,最弱在 1 月。
- 迁入规模指数:从 −0.083 到 0.106,总体上升;最强在 12 月,最弱在 2 月。
- 迁出规模指数:从 −0.079 到 0.097,总体上升;最强在 12 月,最弱在 2 月。
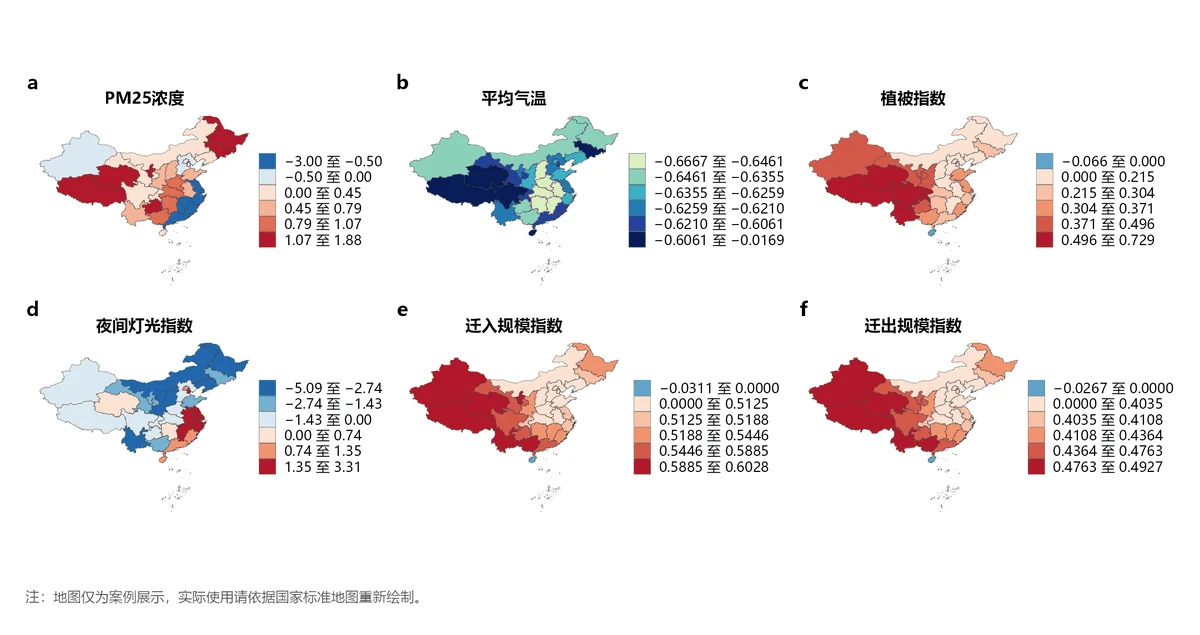
- 每幅地图一个因素,颜色 = 这个地区的空间系数:红 = 推高结局,蓝 = 拉低结局,颜色越深作用越强。
- 每幅地图各自分级,比较大小要看图例上的数值。
- 空间系数 = 这个地区在整个研究时期的平均作用;某地某时的完整作用 = 空间系数 + 该时点的时间系数。
- 夜间灯光指数:从 −5.09(辽宁)到 3.31(天津)。
- PM25浓度:从 −3.00(福建)到 1.88(黑龙江)。
- 植被指数:从 −0.07(海南)到 0.73(四川)。
- 平均气温:从 −0.67(安徽)到 −0.02(海南)。
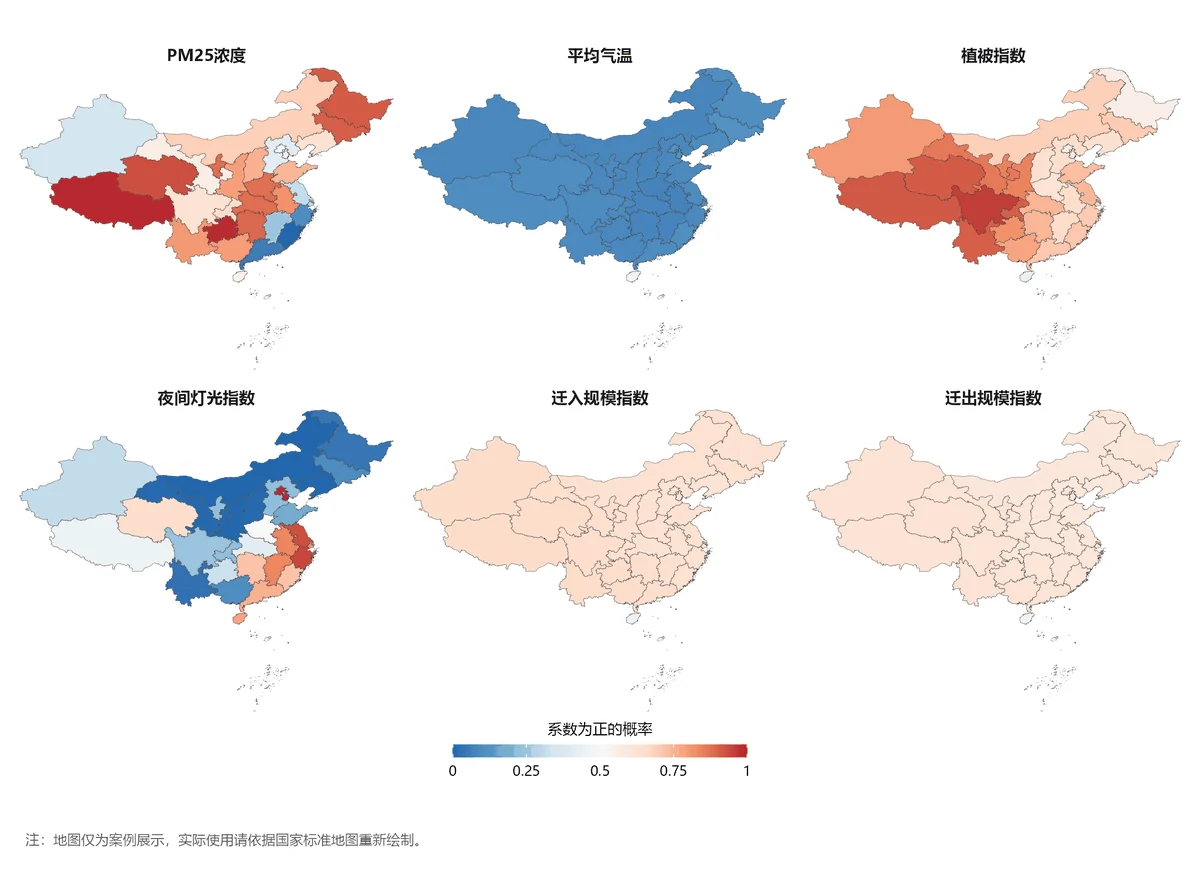
- 颜色 = 这个地区“作用为正”的概率,0 到 1 连续变化:越红越有把握“推高”,越蓝越有把握“拉低”,接近白色 = 方向还说不准。
- 和图 3 搭配看:图 3 看“作用多大”,图 3b 看“方向有几成把握”。
- 平均气温:0% 的地区“作用为正”的把握在八成以上,97% 的地区“作用为负”的把握在八成以上。
- 夜间灯光指数:23% 的地区“作用为正”的把握在八成以上,32% 的地区“作用为负”的把握在八成以上。
- PM25浓度:35% 的地区“作用为正”的把握在八成以上,10% 的地区“作用为负”的把握在八成以上。
- 植被指数:32% 的地区“作用为正”的把握在八成以上,0% 的地区“作用为负”的把握在八成以上。
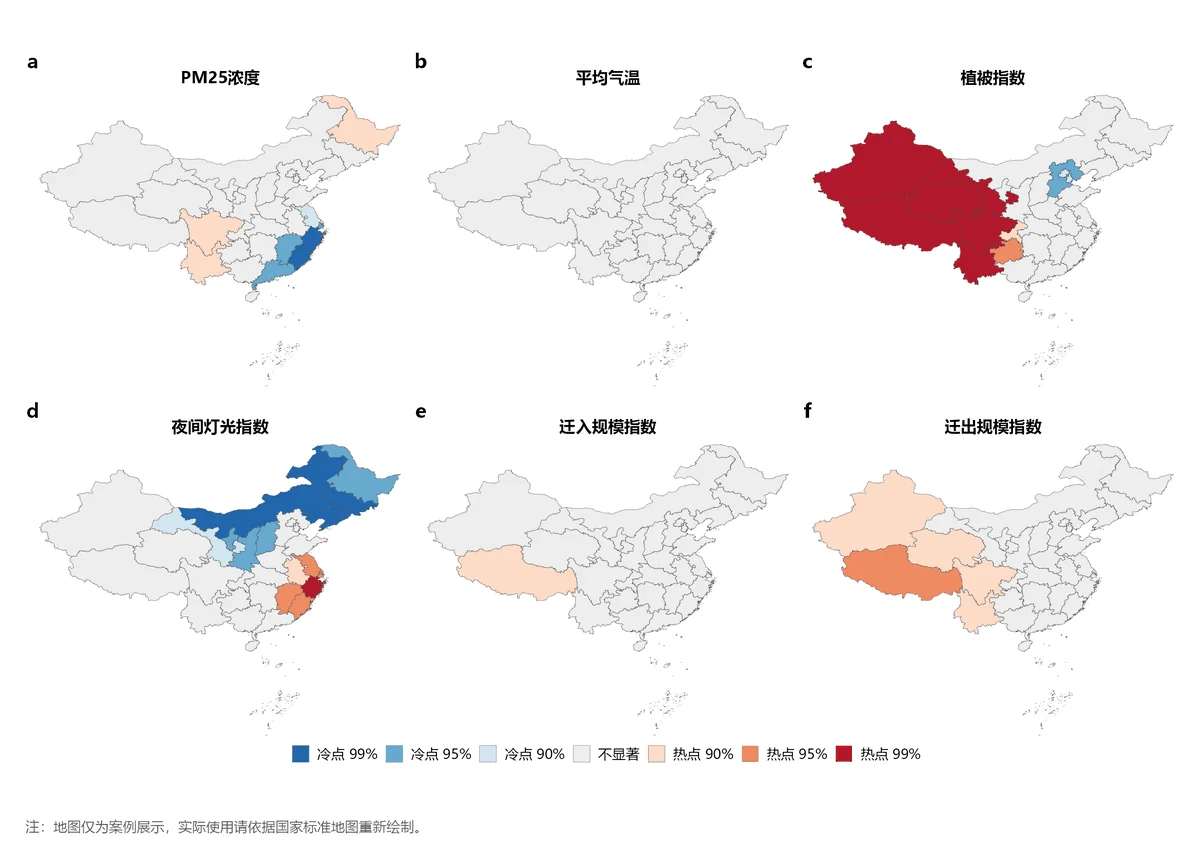
- 找出空间系数“成片偏高”(热点,红色)和“成片偏低”(冷点,蓝色)的区域;灰色 = 没有成片。
- 用来回答:作用特别强(或特别弱)的地区是不是连在一起,适合划定重点区域。
- PM25浓度:热点 0 个,冷点 5 个(如 福建、浙江、江西)。
- 平均气温:热点 0 个,冷点 0 个。
- 植被指数:热点 7 个(如 四川、西藏、青海),冷点 1 个(如 河北)。
- 夜间灯光指数:热点 5 个(如 浙江、江苏、江西),冷点 7 个(如 内蒙古、吉林、辽宁)。
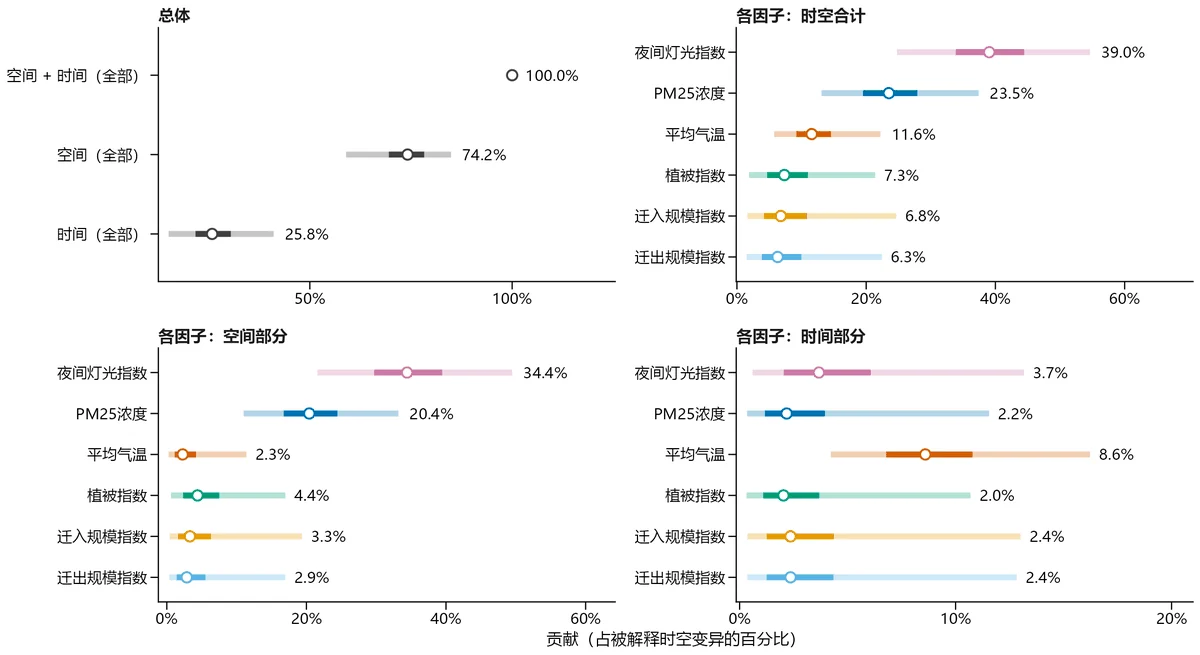
- 左上“总体”:结局的时空差异里,空间部分、时间部分各占多少。
- 其余面板:每个因素的贡献(时空合计、空间部分、时间部分);圆圈 = 估计值,粗、细条 = 50%、95% 可信区间。
- 只有解释变量标准化后,不同因素的百分比才能互相比较。
- 各因素(空间 + 时间合计):
夜间灯光指数39.0%、PM25浓度23.5%、平均气温11.6%、植被指数7.3%、迁入规模指数6.8%、迁出规模指数6.3%。 - 区间重叠很多的因素,排名不要说得太死。
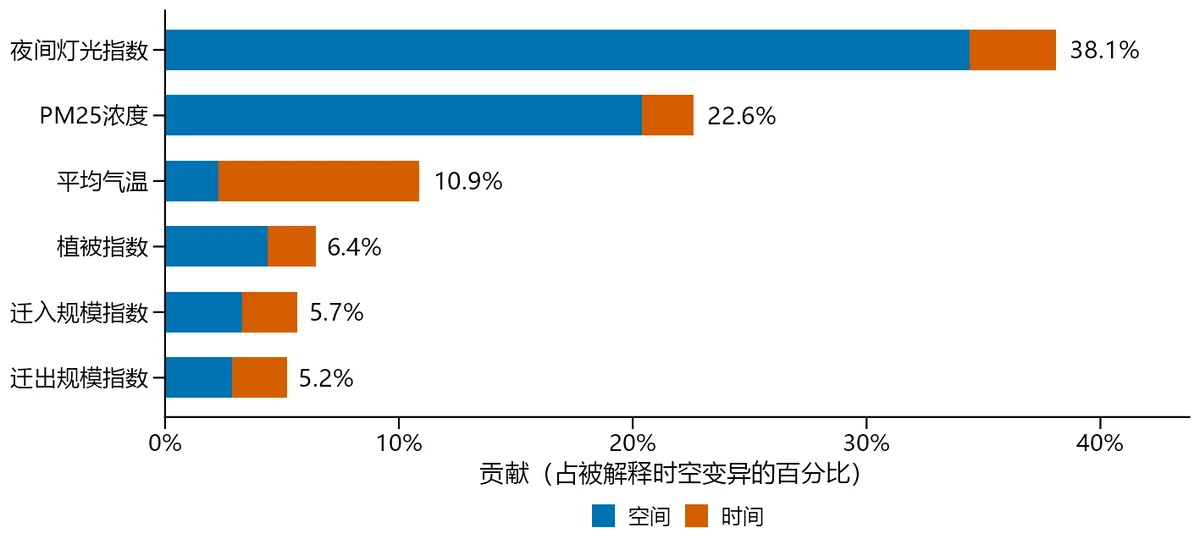
- 一根条 = 一个因素,条长 = 它的总贡献;两段颜色 = 空间部分和时间部分。
- 条最长的因素是本研究的关键因素候选;空间段占绝大部分 → “因地制宜”;时间段明显 → 还要“因时制宜”。
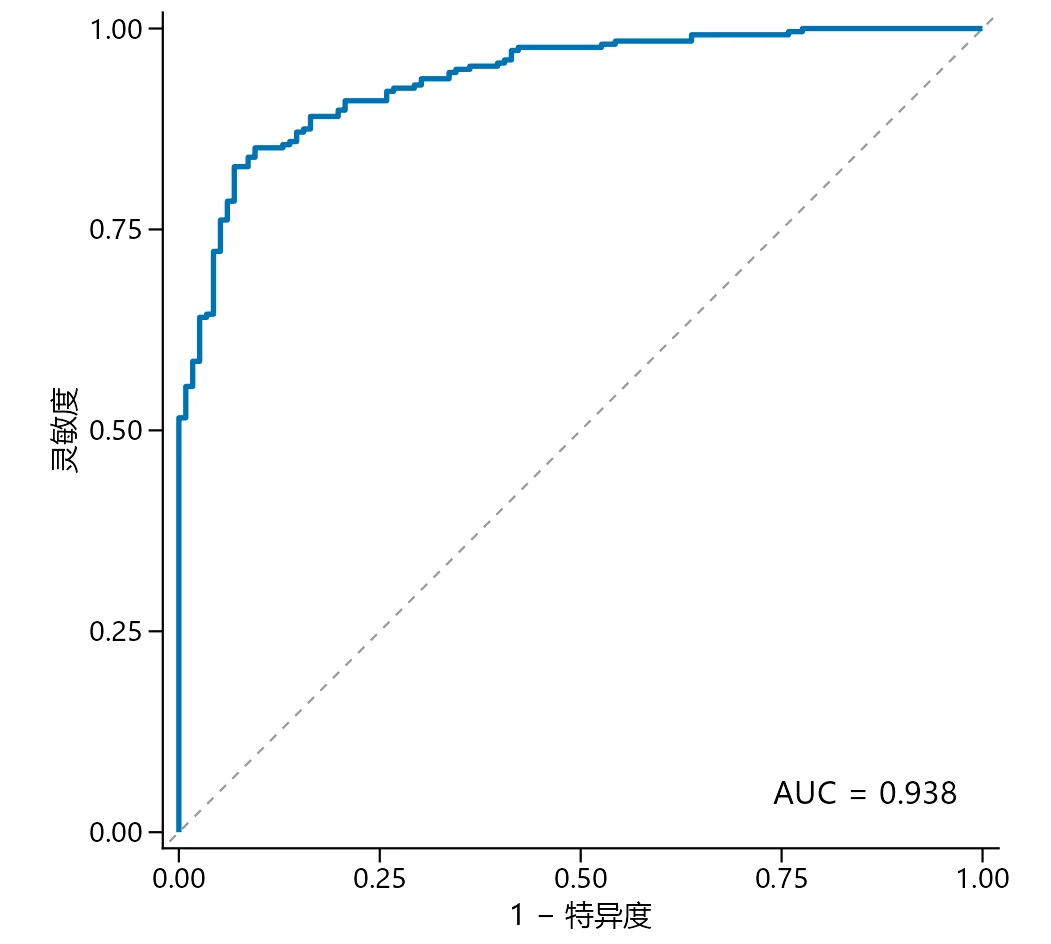
- ROC 曲线越靠近左上角越好;AUC 0.5 = 瞎猜,1 = 完全分得开。
- 这是在同一份数据上的拟合,不等于对新数据的预测能力。
- AUC = 0.938(372 个观测)。
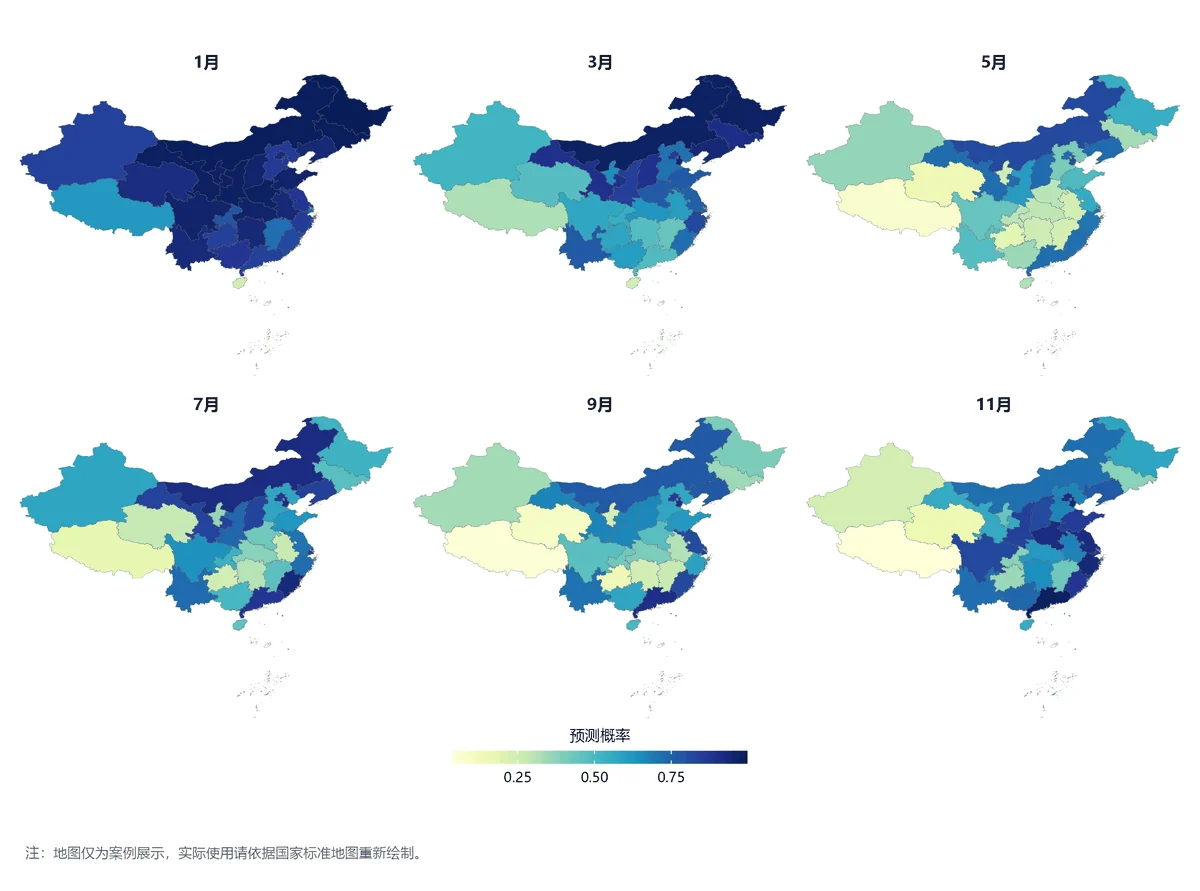
- 几个时点并排,共用同一色标:颜色的变化就是时间上的变化。
- 原数据里缺失的地区和年份也有拟合值,可用于补缺。
- 对比首末时点,看结局整体升降和空间格局有没有变。
想更深入地挖掘各地区的局部系数?本案例的全套类 SHAP 进阶图见第 14 章对应小节。
9 案例 3 · 计数型:美国阿巴拉契亚 5 州急性乙型肝炎(宽表 → 面板)
9.1 案例卡:数据、来源与变量
| 项目 | 内容 |
|---|---|
| 文件夹 | Case-03-Count-US-Hepatitis-B(官方示例数据,变量名改为中文) |
| 表格 | hbv_a5_space_zh.xlsx:宽表,5 行 × 68 列,列名 = 变量名 + 年份(如 病例数2012) |
| 地图 | us_a5_map\us_a5.*(肯塔基 KY、北卡 NC、田纳西 TN、弗吉尼亚 VA、西弗吉尼亚 WV) |
| 来源 | 美国 CDC(病例)、美国社区调查 ACS(人口密度、贫困率、无保险率)、NOAA(年降水量);无缺失 |
| 空间 / 时间 | GEOID(州 FIPS 代码)/ 转换后的 年份(2012–2023) |
| Y | 病例数:急性乙型肝炎监测病例数(非负整数) |
| X(4 个) | 人口密度(人/km²)、无保险率、贫困率(比例)、年降水量(英寸) |
| 设置 | 计数型 · 检查后数据 · 标准化 = 是 · QUEEN-B · 线程 20 |
9.2 步骤 A:数据转换
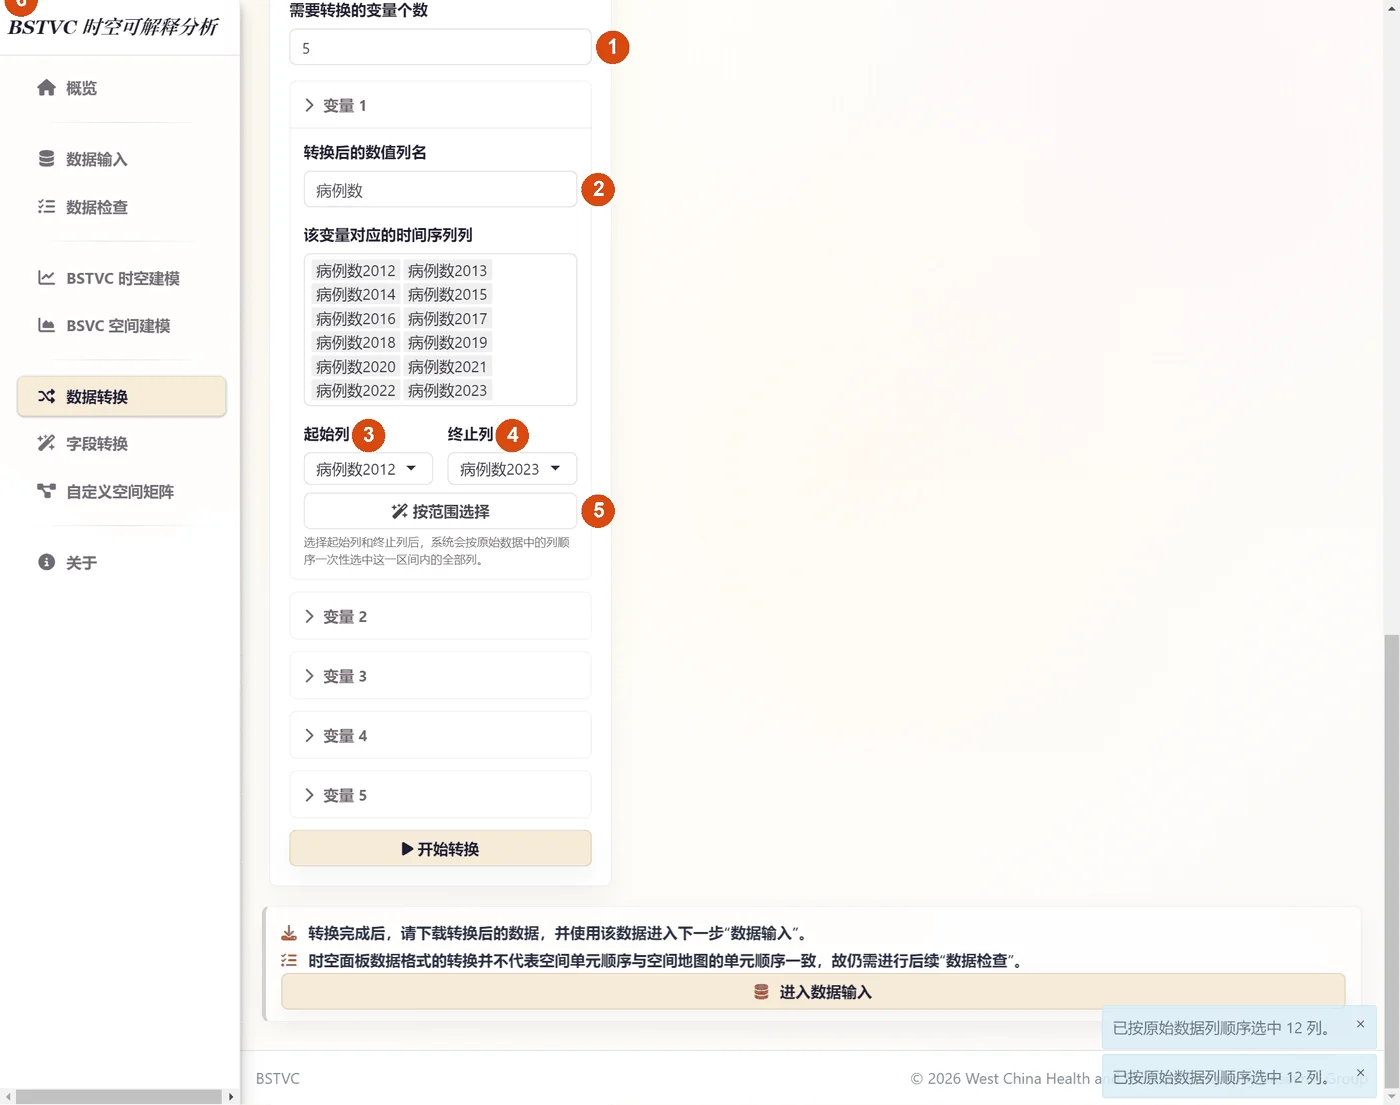
- 数据转换页读取
hbv_a5_space_zh.xlsx;检查卡片应报告 60 个含时间信息的列(5 个变量 × 12 年)。 - id 列
GEOID;时间序列2012:2023;新时间列名年份;变量个数5。如果刚做过案例 2,表单里还留着 7 个变量和 1:12——每一项都要重新填。 - 5 个变量块:
病例数(病例数2012 → 病例数2023)、人口密度、无保险率、贫困率、年降水量,每块都“按范围选择”。 - 开始转换 → “转换完成:已生成 60 行,7 列的时空面板数据” → 选 Excel xlsx 下载。
9.3 步骤 B、C:数据输入与检查
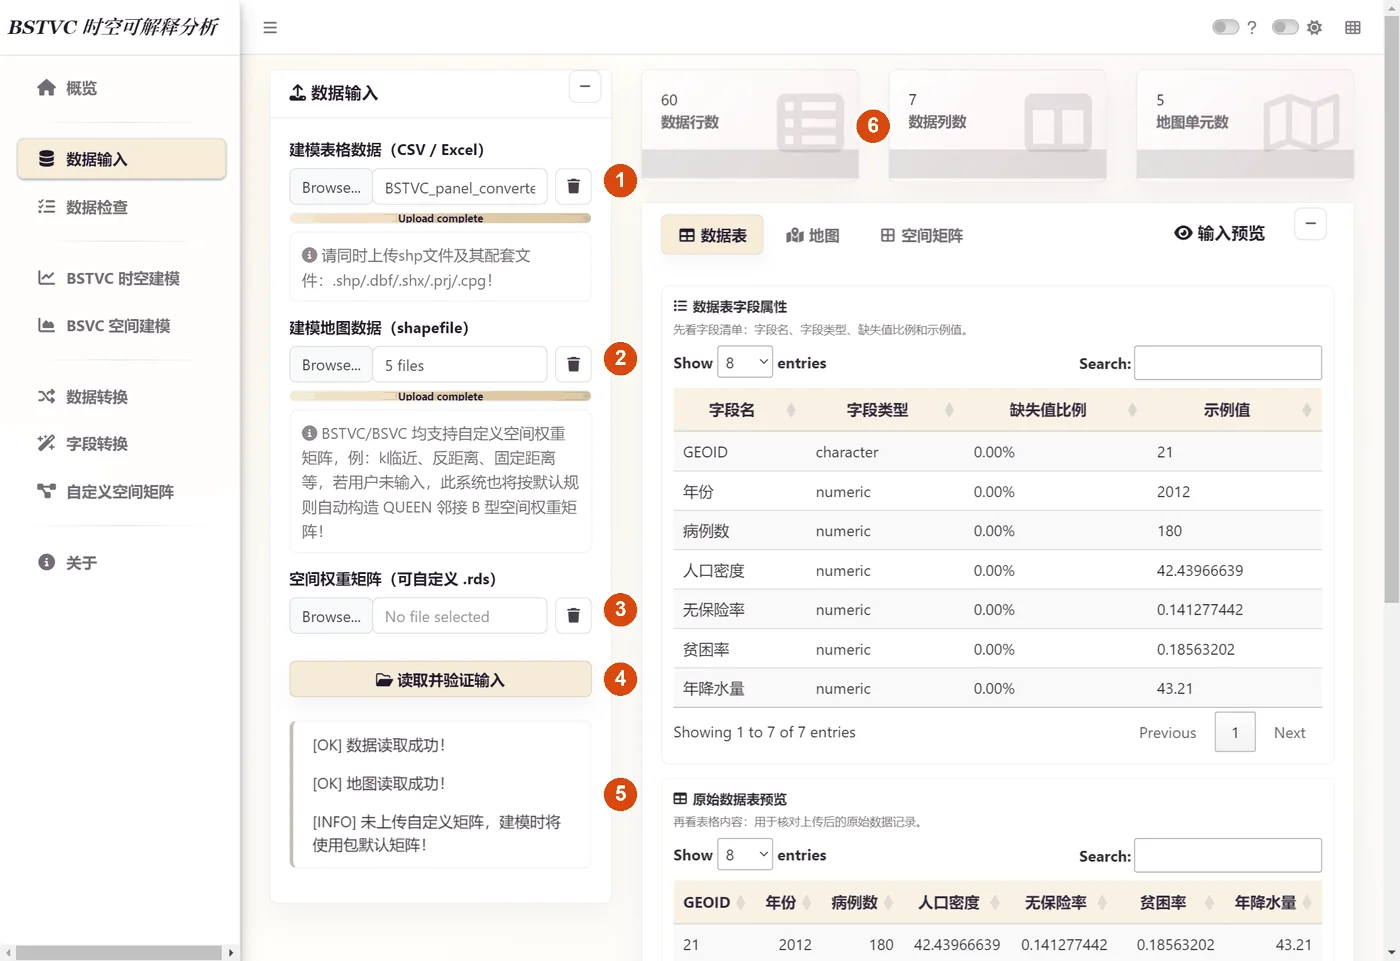
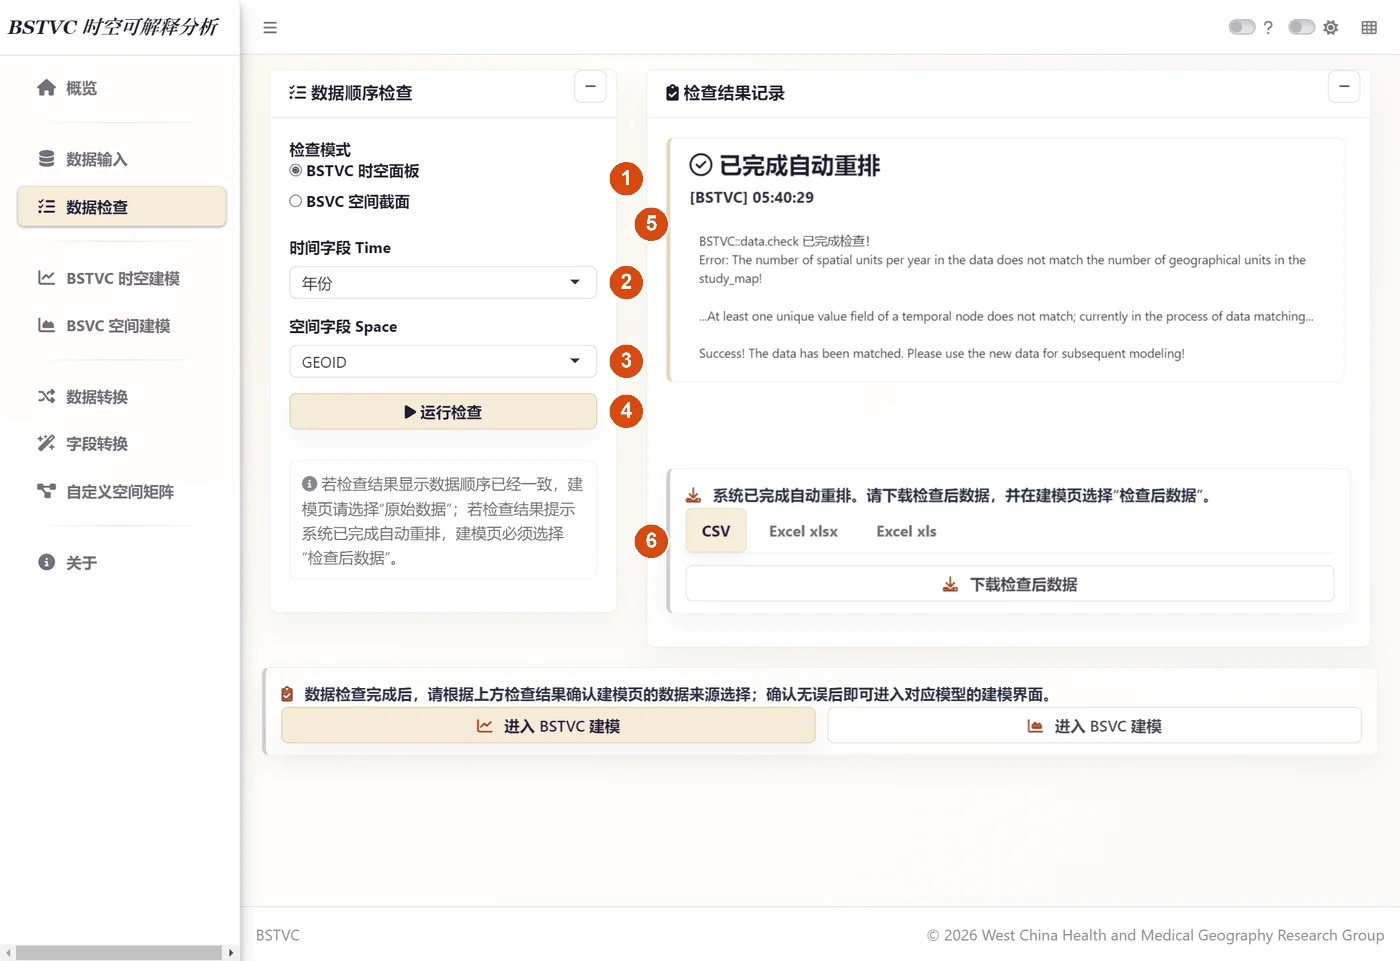
载入转换后的表格和 us_a5 的 5 个文件(多出来的 .sbn .sbx .shp.xml 不需要);核对 60 行、7 列、5 个地图单元。数据检查:时间 年份、空间 GEOID → 已完成自动重排。
9.4 步骤 D:建模与下载
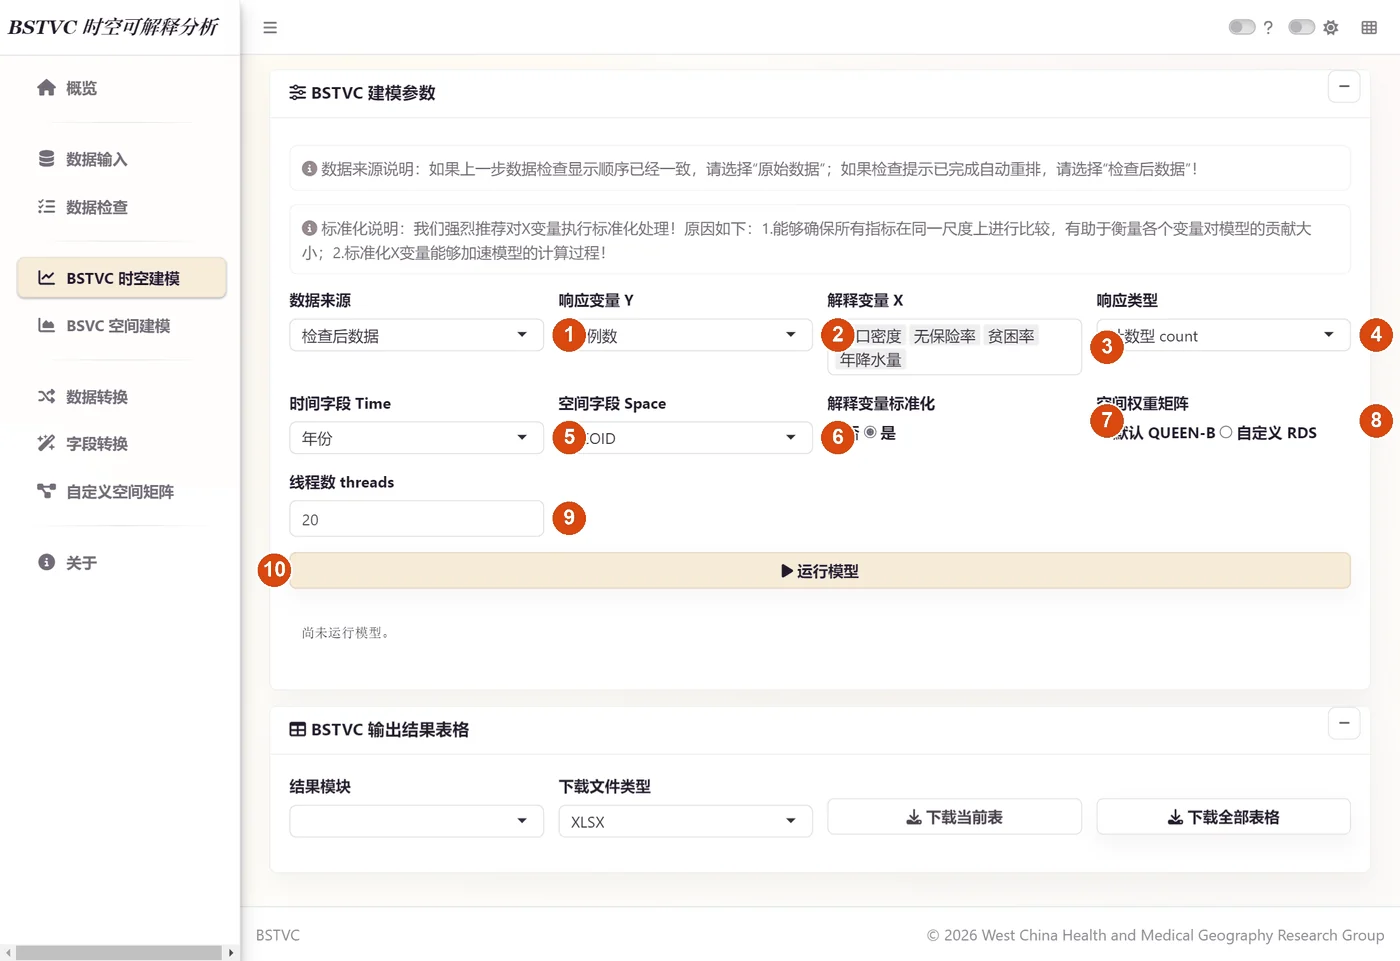
- 检查后数据;Y
病例数;X人口密度、无保险率、贫困率、年降水量;响应类型 = 计数型 count;时间年份;空间GEOID;标准化 = 是;QUEEN-B;线程 20 → 运行模型。< 15 秒 完成。病例数是非负整数。 - 下载全部表格。
人口密度 53.2%、无保险率 21.4%、贫困率 14.1%、年降水量 10.8%。time.coefficients 48 行(4 × 12),space.coefficients 5 行。9.5 结果解读
- 评价:V2 的 DIC、WAIC、LS 都比 V1 小(DIC 538.1 → 520.9)。
- 谁更重要:人口密度 的 STVPI 最大;时间部分占 36.8%,是六个案例中时间作用较强的一个(各因子时间部分:无保险率 10.9%、贫困率 9.3%、人口密度 8.7%、年降水量 7.4%)。
- 只有 5 个州:空间系数靠 5 个点估计,模型能“借力”的邻居很少;V1 时空间区间非常宽,V2 收窄了约 98%,但这仍是一个教学示例,不宜据此下强的实质性结论。少于 10 个地区时,出图脚本自动跳过热点分析。
在这 5 个州,人口越密集的地方,人口密度和乙肝病例的关联越突出;但地区太少,结论只适合演示怎么用计数模型。
9.6 可视化与解读
结果工作簿可以直接画成论文图。代码和画好的图(中文、英文两套,300 dpi PNG + 矢量 PDF)都在 Case-03-Count-US-Hepatitis-B\visualization\:把 R 的工作目录设为该案例文件夹,运行 source("visualization/Case3_HBV.R")。
本例的 R 代码(点开可复制)
# ==========================================================================================
#  怎么运行 / How to run
#  1. 安装一次 R 包 / install once:
#     install.packages(c("readxl","dplyr","tidyr","ggplot2","sf","patchwork","scales","RColorBrewer","classInt","ragg","systemfonts"))
#  2. 把工作目录设为本案例文件夹(纯英文路径)/ set the working directory to this case folder (ASCII path):
#     setwd("D:/BSTVC_data/Case-03-Count-US-Hepatitis-B")
#  3. source("visualization/Case3_HBV.R")
#  图写到 visualization/outputs/<中文 zh | 英文 en>/;进阶模块的图在其中的 local_coef_module/。
#  换成你自己的结果:改下面 cfg 里的文件名、空间字段 key、结局类型和变量中英对照 var_en 即可。
# ==========================================================================================
# 案例 3:美国 5 个州 2012–2023 年急性乙型肝炎病例数(计数型)
# Case 3: acute hepatitis B cases in five US states, 2012-2023 (count)
source("visualization/R/bstvc_plot_functions.R"); source("visualization/R/run_case.R")
source("visualization/R/bstvc_local_coef_functions.R"); source("visualization/R/run_local_coef.R")
cfg <- list(
  id = "Case3_HBV", title = "案例 3 美国急性乙型肝炎", title_en = "Case 3 US acute hepatitis B",
  xlsx = "reference_results_V2/Case3_HBV_V2_all_result_tables.xlsx", shp = "us_a5_map/us_a5.shp", outdir = "visualization/outputs", key = "GEOID", k = 4,
  data = "hbv_a5_space_zh.xlsx", wide = list(suffix = as.character(2012:2023), times = 2012:2023),
  type = "count", standardized = TRUE, label_field = "NAME",
  t0 = 2012, tlab = "年份", tlab_en = "Year", time_col = "年份", pred_times = c(2012, 2015, 2018, 2021, 2023),
  pred_label = "病例数", pred_label_en = "Cases",
  var_en = c("人口密度" = "Population density", "无保险率" = "Uninsured rate", "贫困率" = "Poverty rate", "年降水量" = "Annual precipitation"))

for (lang in c("zh", "en")) {
  run_case(modifyList(cfg, list(lang = lang)))          # 核心图 / core figures
  run_local_coef(modifyList(cfg, list(lang = lang)))    # 进阶模块(可选)/ optional SHAP-style module
}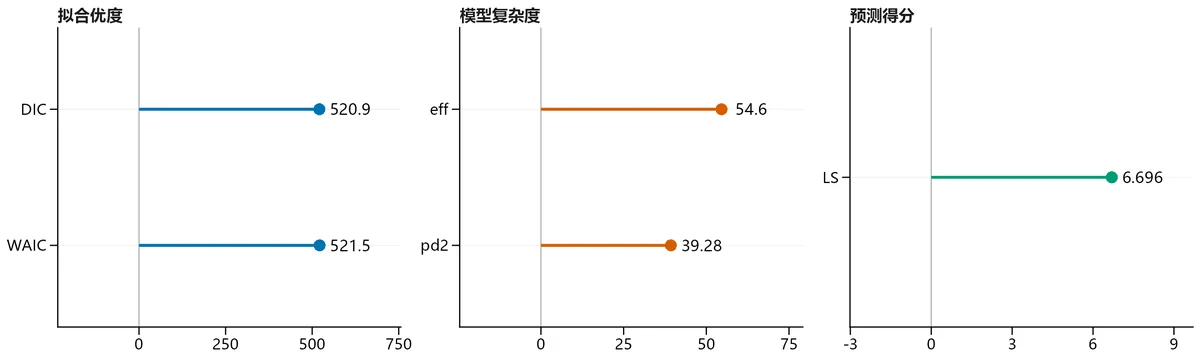
- 三组数字:拟合优度(DIC、WAIC)、模型复杂度(eff、pd2)、预测得分(LS)。
- DIC、WAIC、LS 越小越好,只在同一份数据、同一个 Y 的几个模型之间比较;DIC 和 WAIC 是两种算法,数值不同属正常。
- DIC 520.9,WAIC 521.5,LS 6.696;eff 54.6,pd2 39.3。
- 拟合值与观测值的一致程度:R² = 0.992。
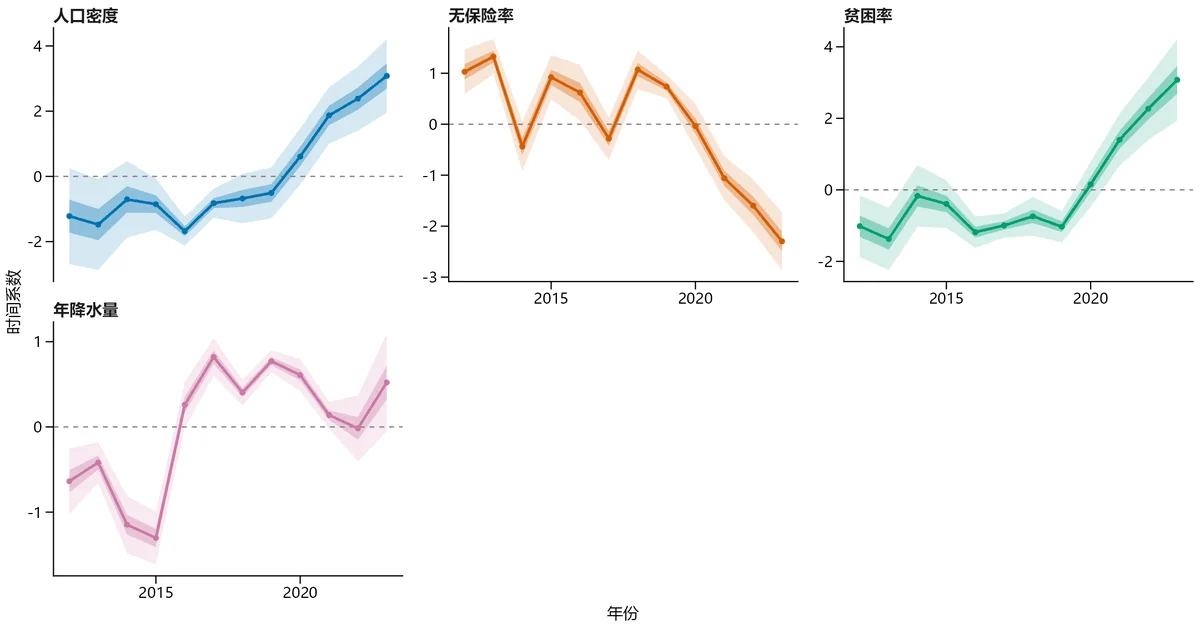
- 每个小图一个因素;横轴是时间,0 线 = 整个研究时期的平均水平。
- 曲线在 0 以上:这个时点作用比平时更强(更正向);在 0 以下:更弱(更负向)。
- 深色带 = 50%、浅色带 = 95% 可信区间:带子越窄,越有把握。各小图纵轴刻度不同。
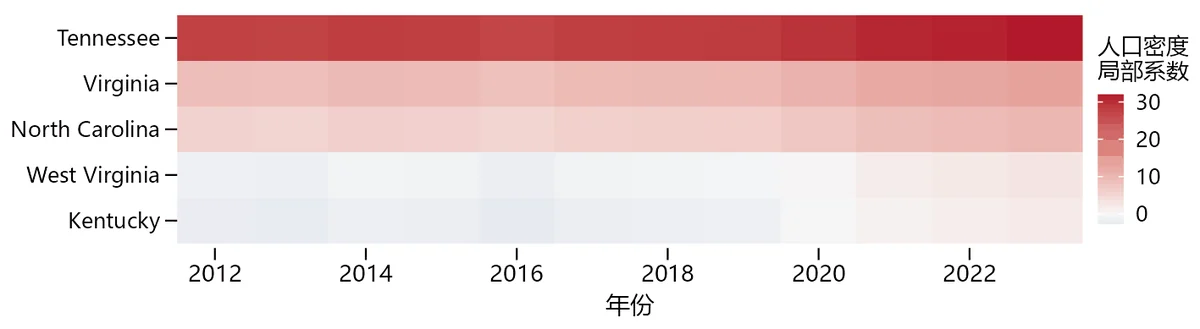
- 人口密度:从 −1.217 到 3.081,总体上升;最强在 2023 年,最弱在 2016 年。
- 贫困率:从 −1.016 到 3.075,总体上升;最强在 2023 年,最弱在 2013 年。
- 无保险率:从 1.029 到 −2.297,总体下降;最强在 2013 年,最弱在 2023 年。
- 年降水量:从 −0.637 到 0.521,总体上升;最强在 2017 年,最弱在 2015 年。
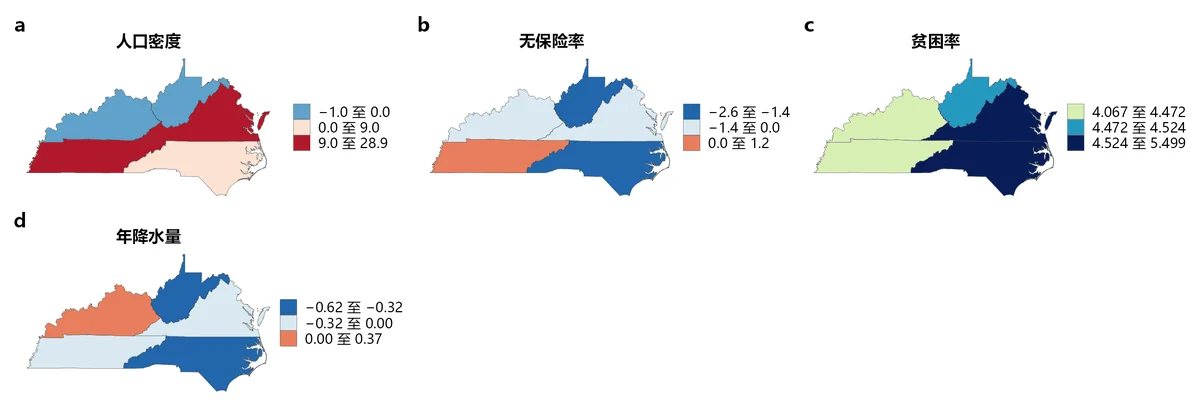
- 每幅地图一个因素,颜色 = 这个地区的空间系数:红 = 推高结局,蓝 = 拉低结局,颜色越深作用越强。
- 每幅地图各自分级,比较大小要看图例上的数值。
- 空间系数 = 这个地区在整个研究时期的平均作用;某地某时的完整作用 = 空间系数 + 该时点的时间系数。
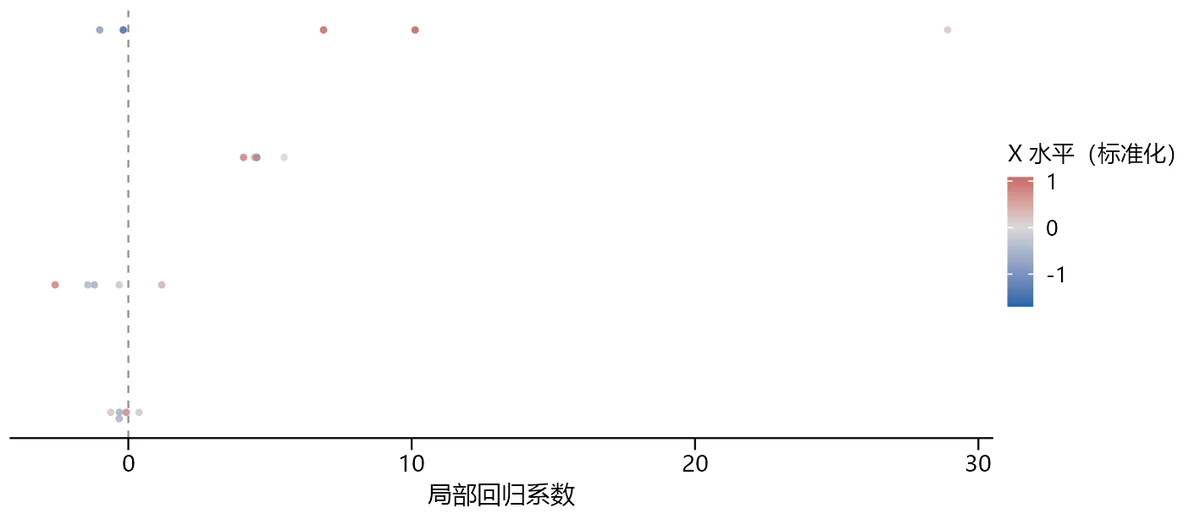
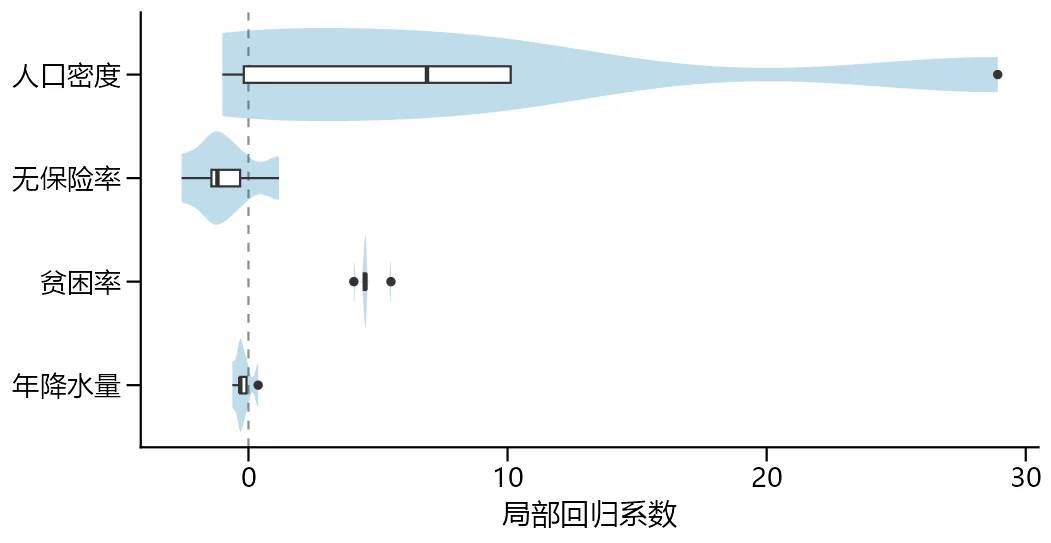
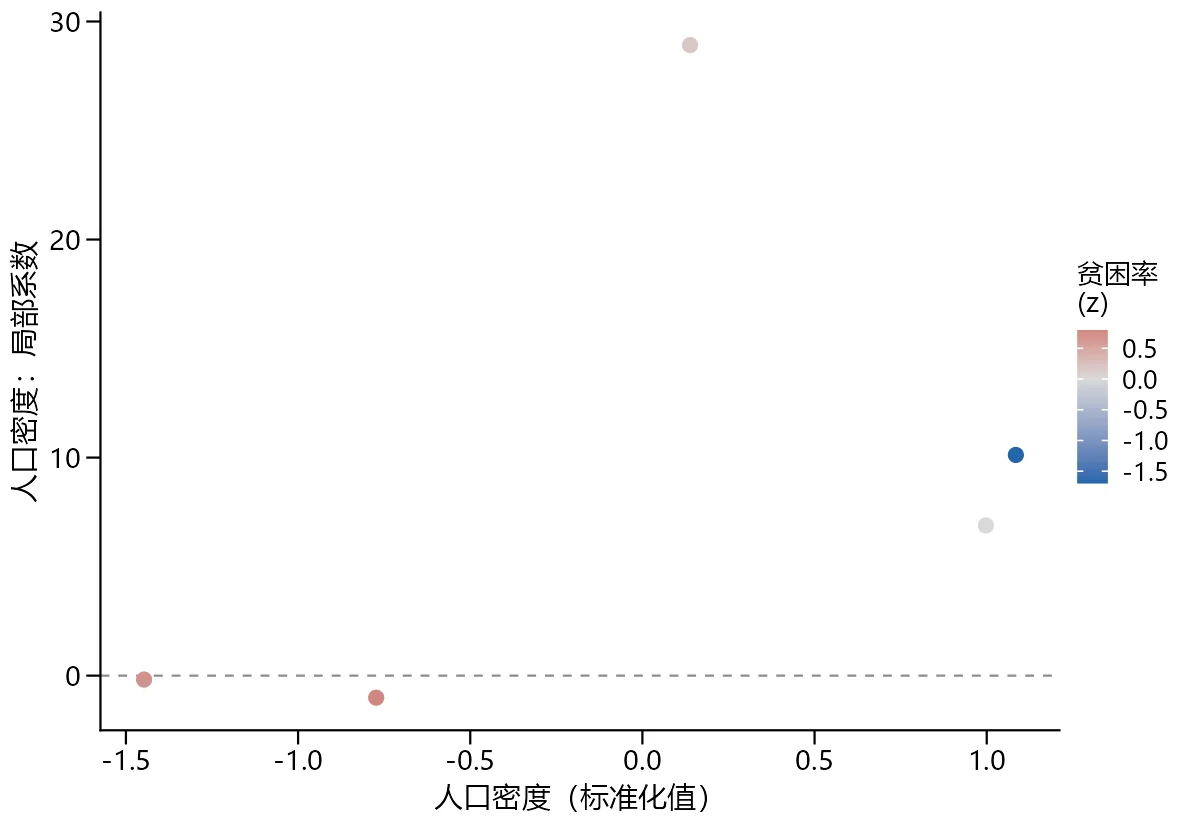
- 人口密度:从 −1.01(Kentucky)到 28.92(Tennessee)。
- 无保险率:从 −2.58(North Carolina)到 1.18(Tennessee)。
- 贫困率:从 4.07(Kentucky)到 5.50(North Carolina)。
- 年降水量:从 −0.62(North Carolina)到 0.37(Kentucky)。
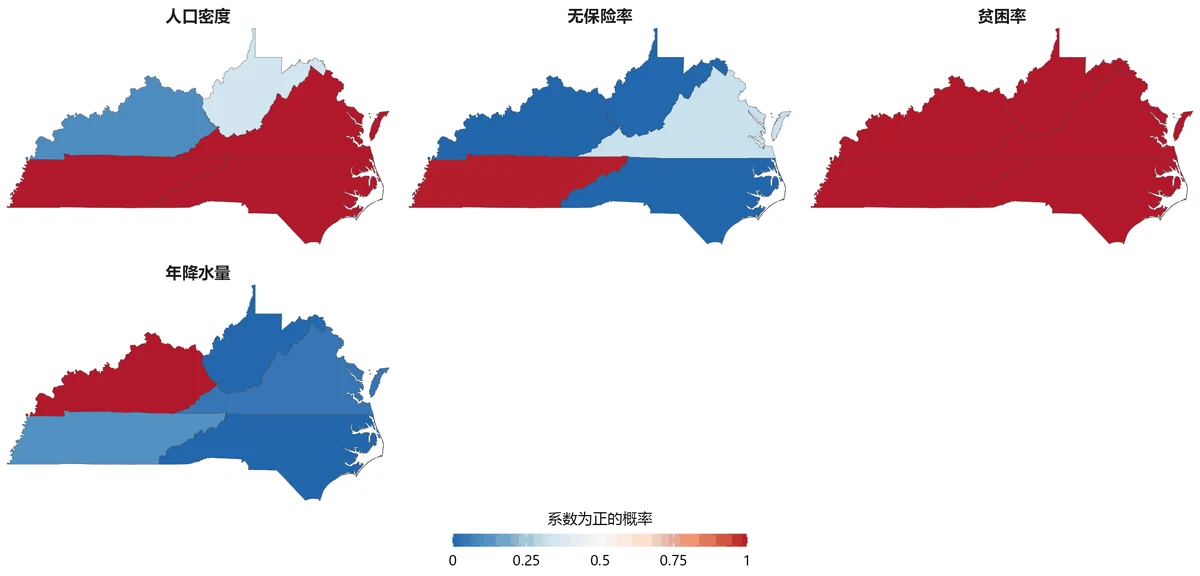
- 颜色 = 这个地区“作用为正”的概率,0 到 1 连续变化:越红越有把握“推高”,越蓝越有把握“拉低”,接近白色 = 方向还说不准。
- 和图 3 搭配看:图 3 看“作用多大”,图 3b 看“方向有几成把握”。
- 贫困率:100% 的地区“作用为正”的把握在八成以上,0% 的地区“作用为负”的把握在八成以上。
- 年降水量:20% 的地区“作用为正”的把握在八成以上,80% 的地区“作用为负”的把握在八成以上。
- 人口密度:60% 的地区“作用为正”的把握在八成以上,20% 的地区“作用为负”的把握在八成以上。
- 无保险率:20% 的地区“作用为正”的把握在八成以上,60% 的地区“作用为负”的把握在八成以上。
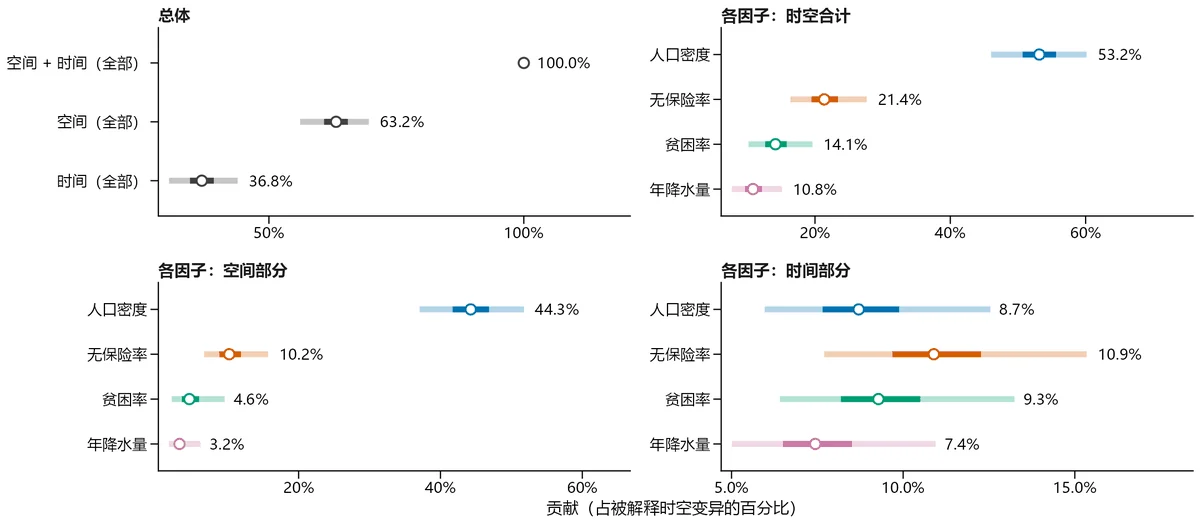
- 左上“总体”:结局的时空差异里,空间部分、时间部分各占多少。
- 其余面板:每个因素的贡献(时空合计、空间部分、时间部分);圆圈 = 估计值,粗、细条 = 50%、95% 可信区间。
- 只有解释变量标准化后,不同因素的百分比才能互相比较。
- 各因素(空间 + 时间合计):
人口密度53.2%、无保险率21.4%、贫困率14.1%、年降水量10.8%。 - 区间重叠很多的因素,排名不要说得太死。
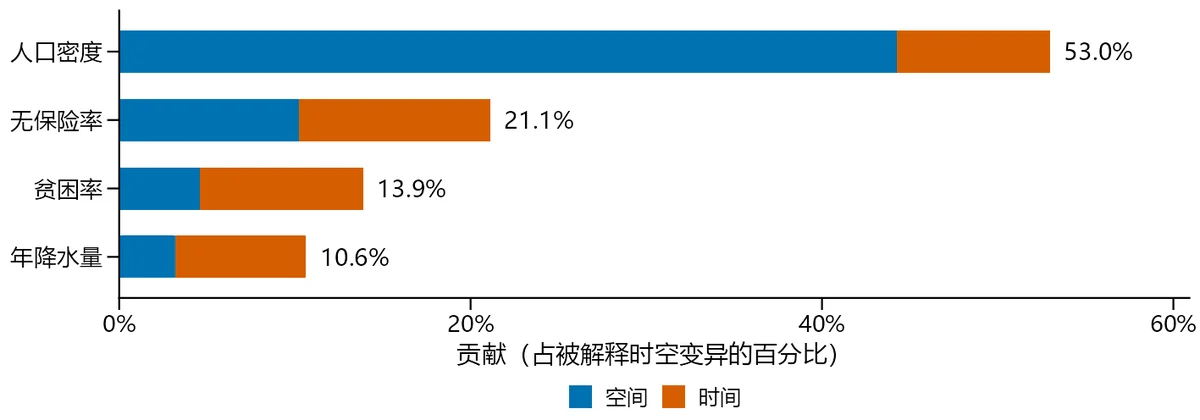
- 一根条 = 一个因素,条长 = 它的总贡献;两段颜色 = 空间部分和时间部分。
- 条最长的因素是本研究的关键因素候选;空间段占绝大部分 → “因地制宜”;时间段明显 → 还要“因时制宜”。
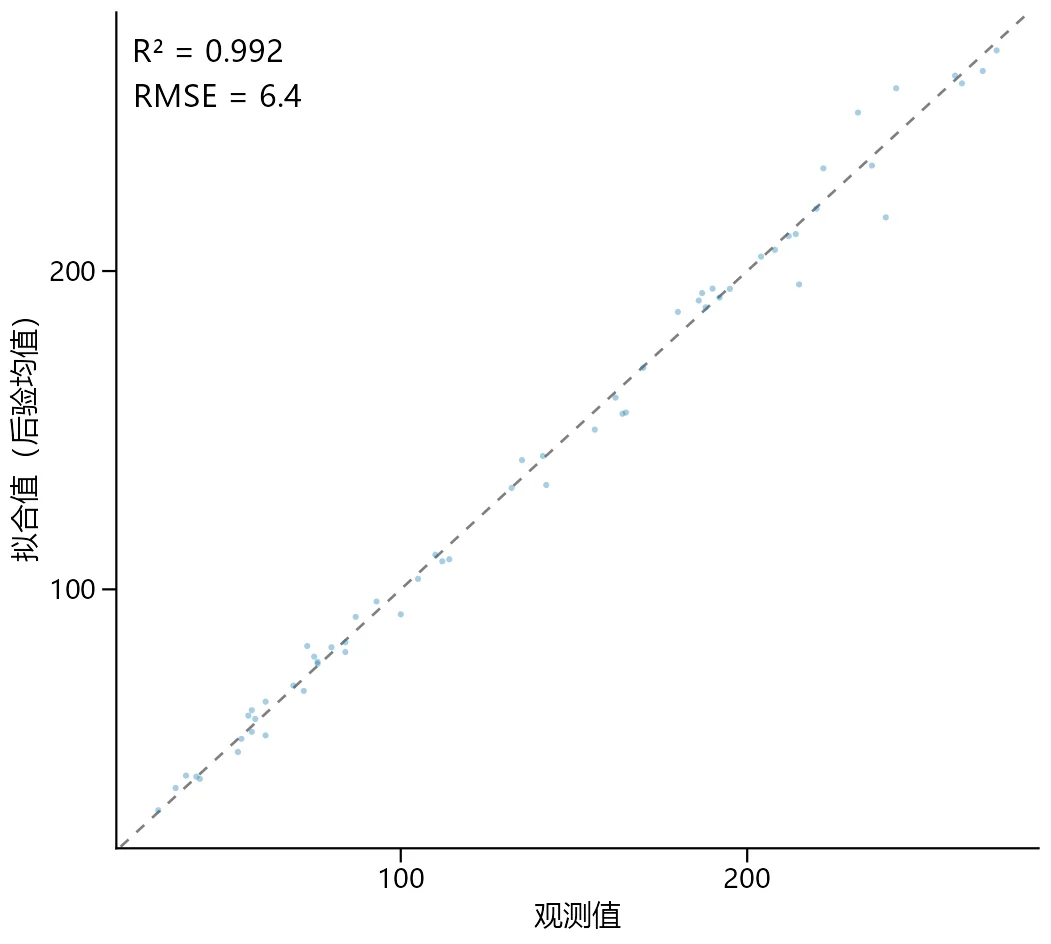
- 横轴观测值,纵轴模型拟合值;点越贴近虚线越好。
- R² 越接近 1 越好;RMSE 是平均误差的大小(和 Y 同单位)。
- R² = 0.992,RMSE = 6.40(60 个有观测的单元)。
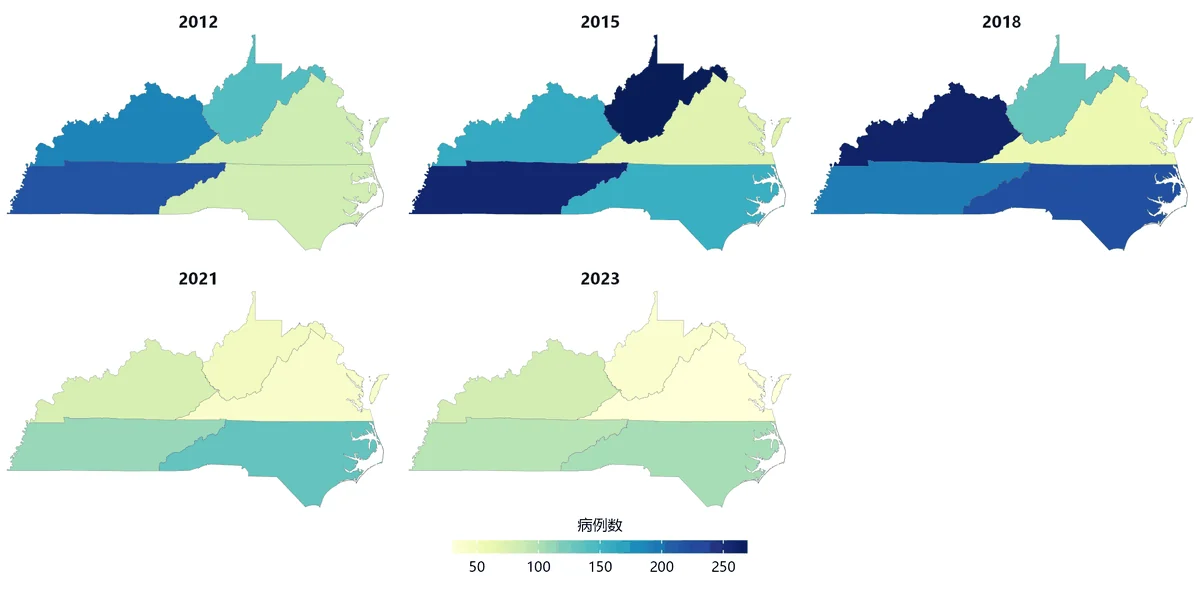
- 几个时点并排,共用同一色标:颜色的变化就是时间上的变化。
- 原数据里缺失的地区和年份也有拟合值,可用于补缺。
- 对比首末时点,看结局整体升降和空间格局有没有变。
想更深入地挖掘各地区的局部系数?本案例的全套类 SHAP 进阶图见第 14 章对应小节。
10 案例 4 · 美国自杀:同一面板的二分类(4a)与计数(4b)
10.1 案例卡:数据、来源与变量
| 项目 | 内容 |
|---|---|
| 文件夹 | Case-04-US-Suicide-Binary-and-Count |
| 表格 | us_suicide_panel_zh.csv:49 × 13 = 637 行,10 列,长表(另附宽表 us_suicide_wide_zh.csv 供练习数据转换) |
| 地图 | us_states_contiguous.*(5 个文件,字段 stusps、name) |
| 来源与许可 | 边界:美国人口普查局 2020 年 1:20m(公有领域)。死亡数:CDC NCHS “Leading Causes of Death”。药物中毒死亡率与人口:CDC NCHS。贫困率、家庭收入:人口普查局 SAIPE。CDC 公开数据(data.cdc.gov),使用前请核对其使用条款 |
| 空间 / 时间 | stusps(州邮政缩写)/ 年份 |
| Y(二选一) | (a) 高自杀率:年龄调整自杀率高于当年 49 个地区中位数 = 1(本手册派生,不是官方指标);(b) 自杀死亡数:计数,29–4,294 |
| X(4 个,无缺失) | 贫困率(%)、家庭收入中位数千美元、人口百万、药物中毒年龄调整死亡率(每 10 万人) |
| 设置 | (a) 二分类、(b) 计数,都用:检查后数据 · 标准化 = 是 · QUEEN-B · 线程 20 |
10.2 步骤 A、B:数据输入与检查(4a、4b 相同)
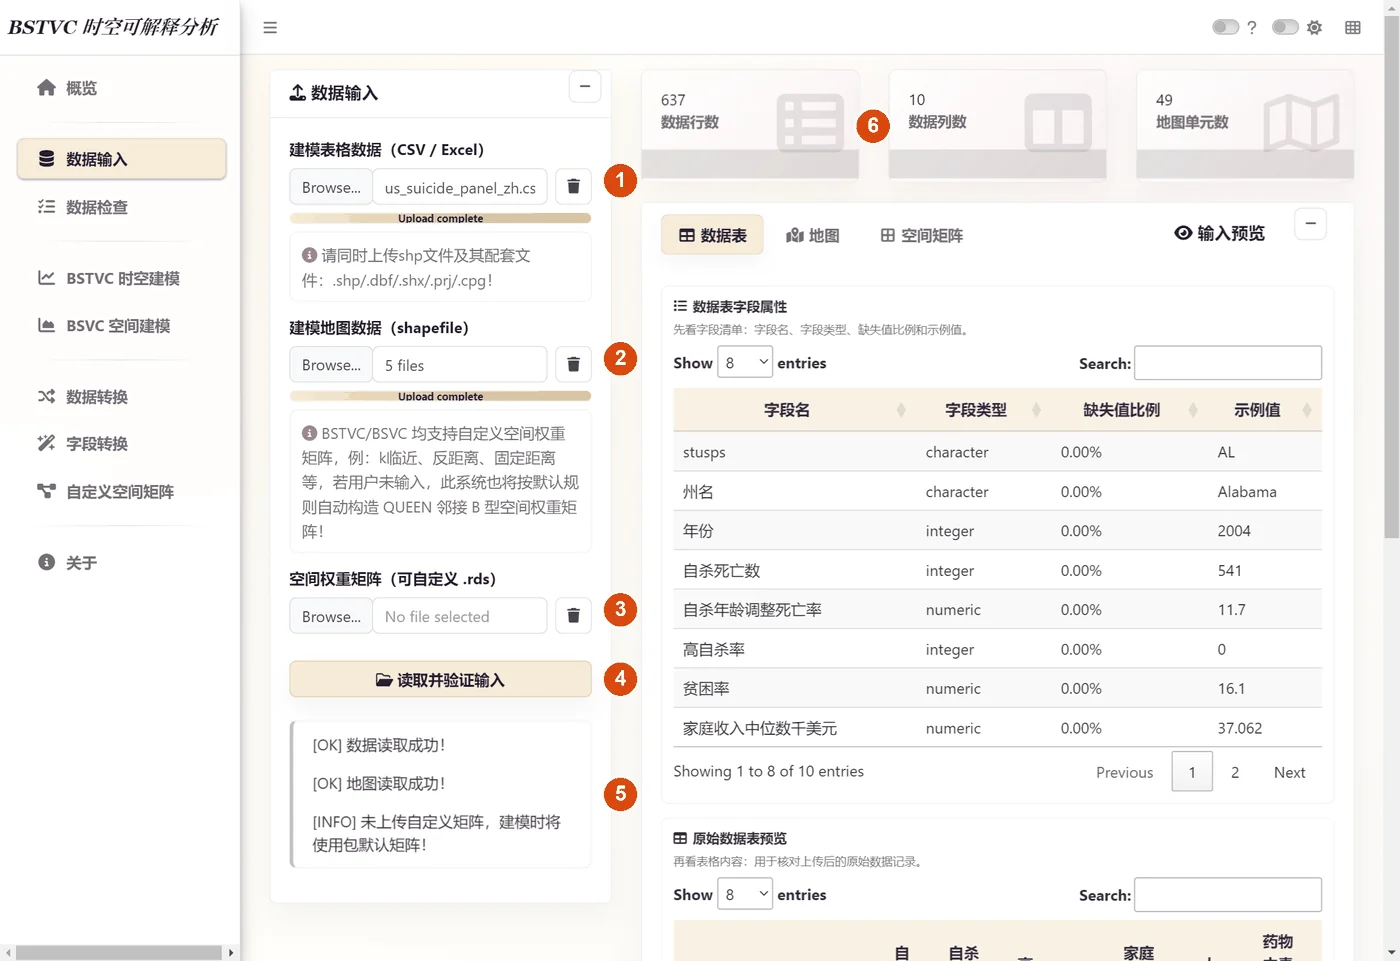
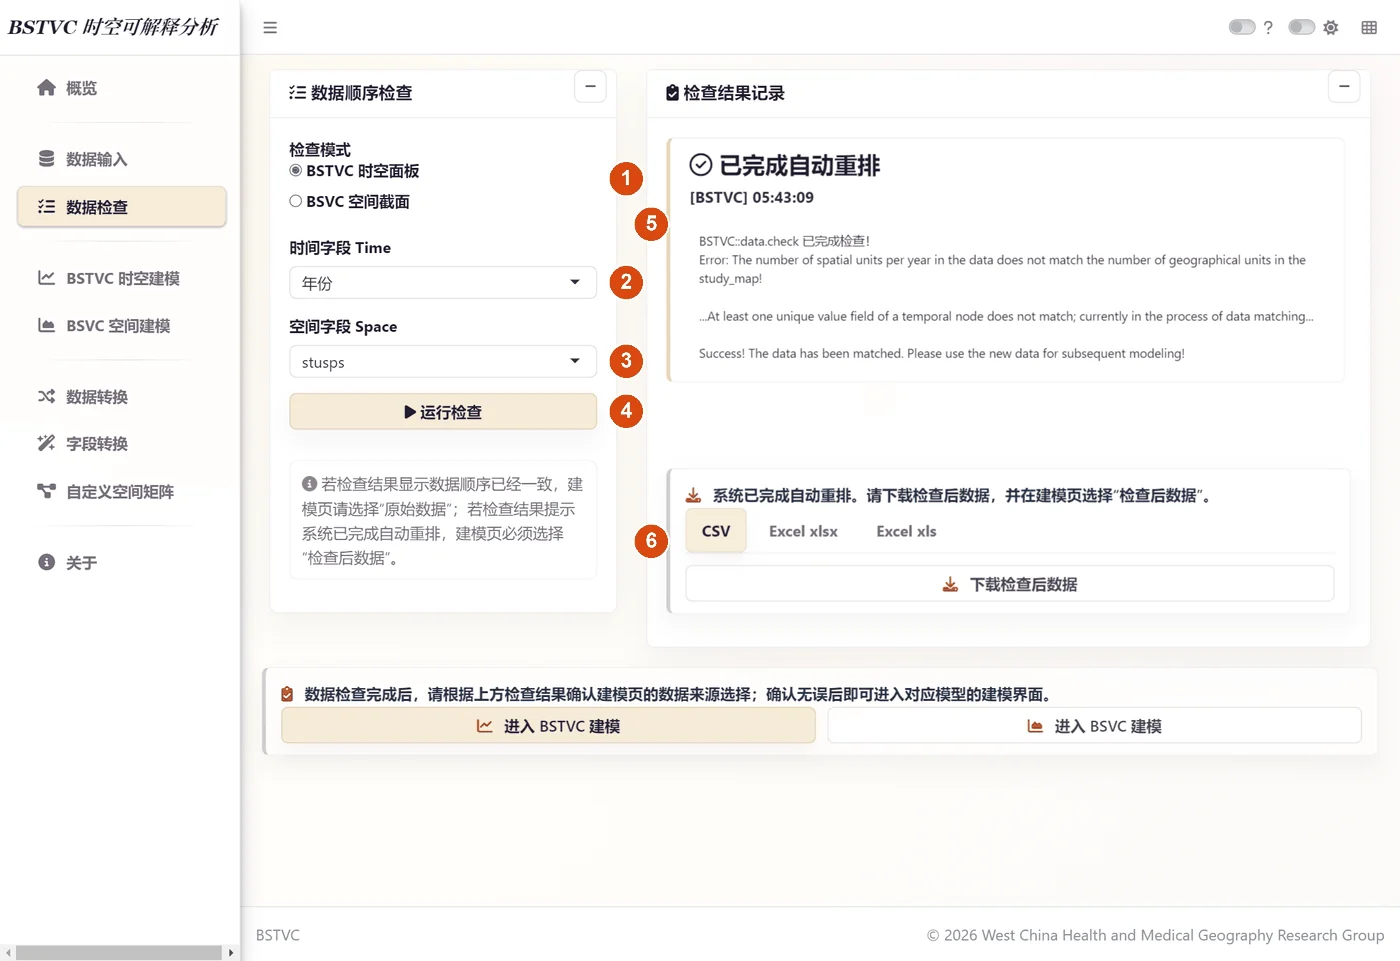
- 数据输入:表格
us_suicide_panel_zh.csv,地图us_states_contiguous的 5 个文件 → 读取并验证输入 → 核对 637 行、10 列、49 个地图单元。637 = 49 × 13。 - 数据检查:时间
年份、空间stusps→ 已完成自动重排 → 建模用“检查后数据”。
10.3 步骤 C(4a):二分类建模
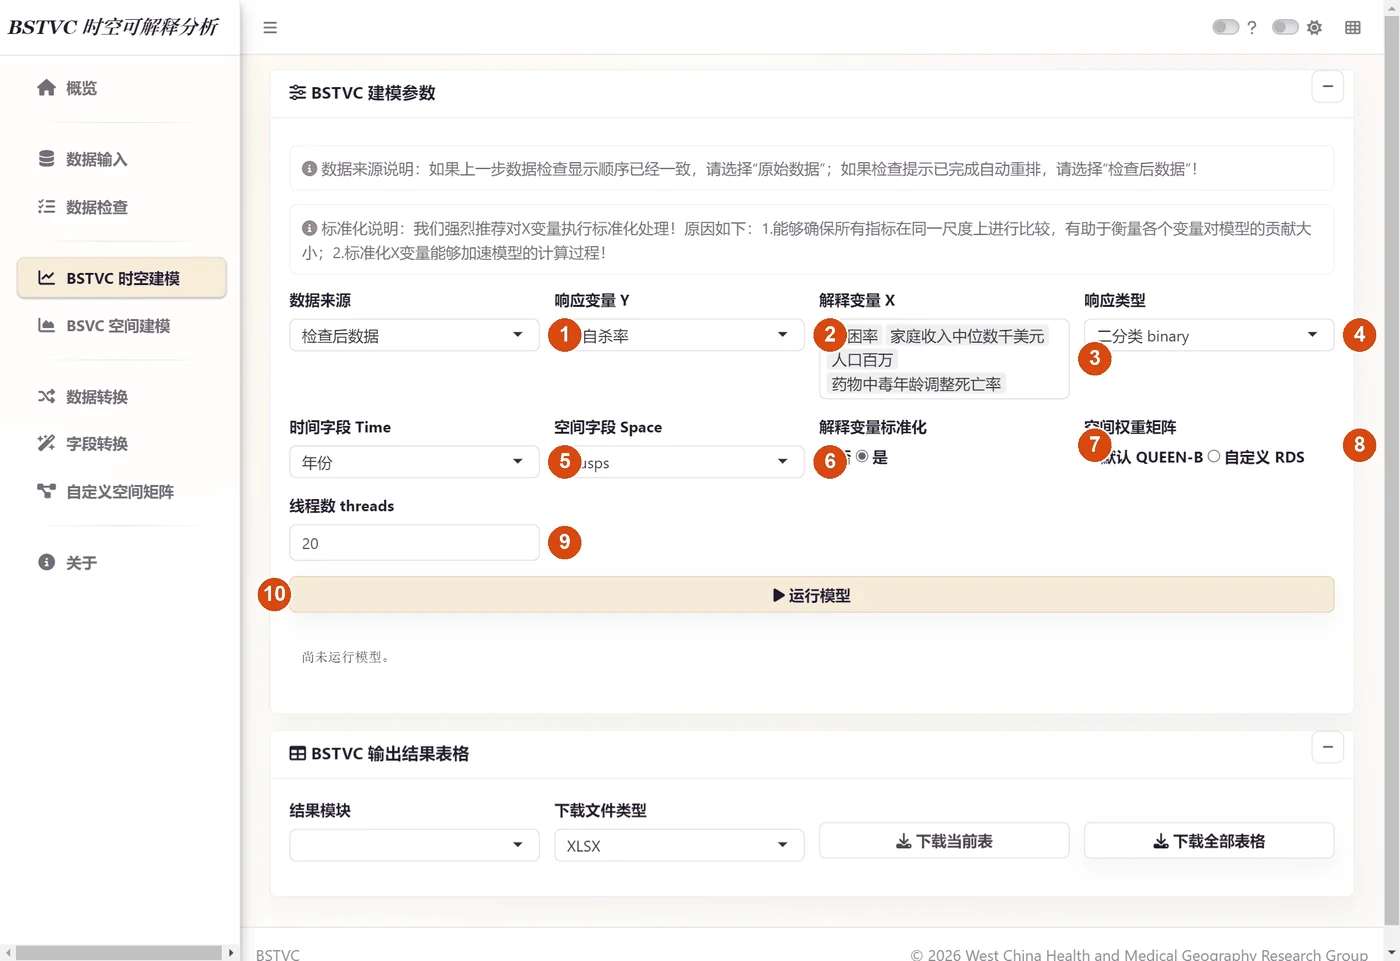
检查后数据;Y 高自杀率;X 贫困率、家庭收入中位数千美元、人口百万、药物中毒年龄调整死亡率;二分类 binary;时间 年份;空间 stusps;标准化 = 是;QUEEN-B;线程 20 → 运行模型(< 15 秒)→ 下载全部表格。
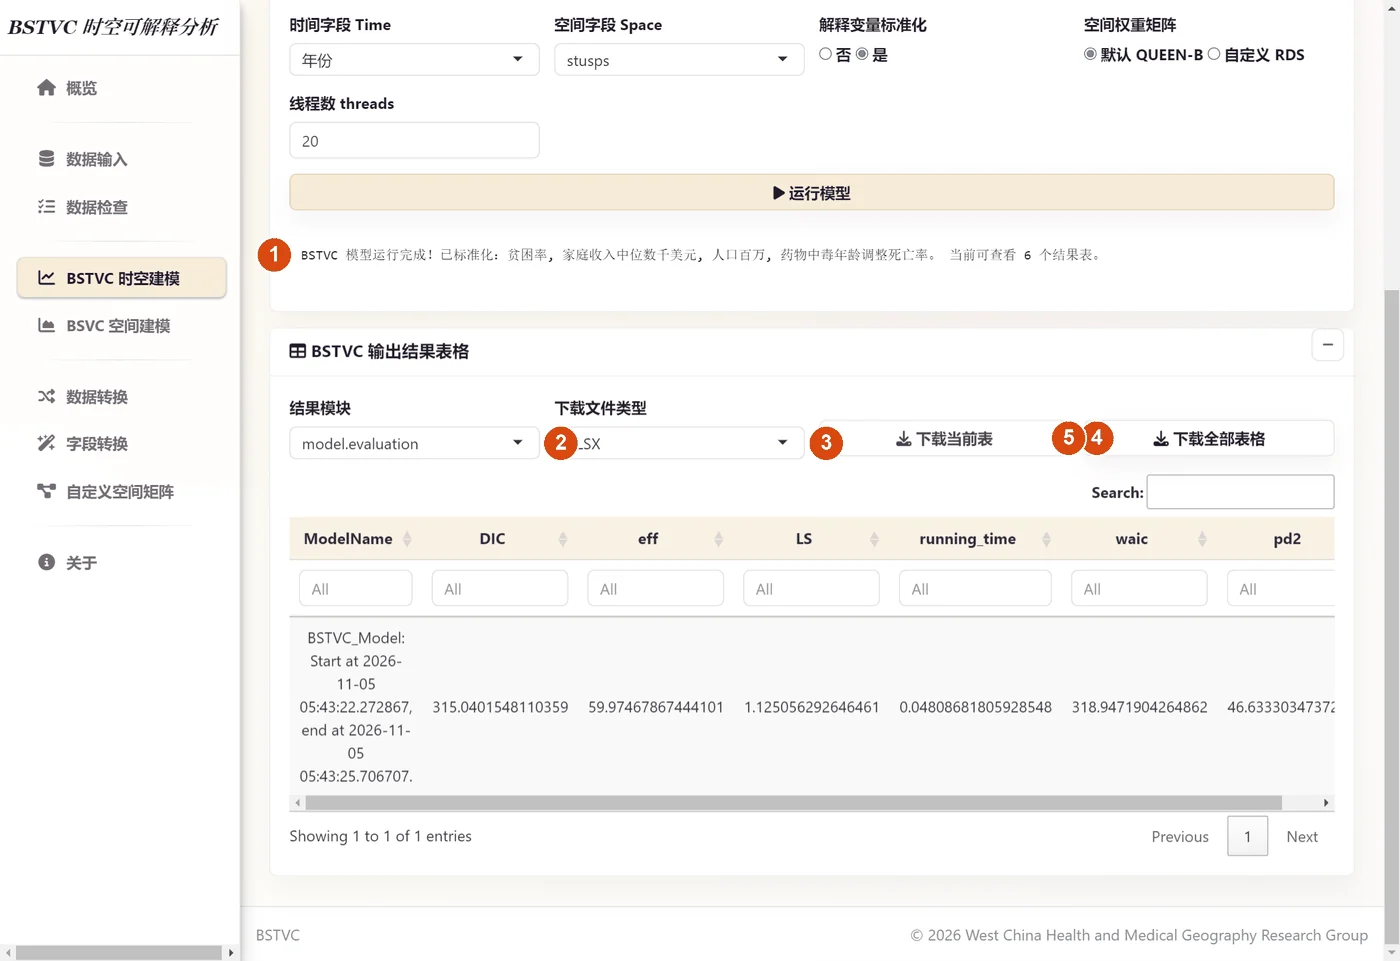
人口百万 49.5%、家庭收入中位数千美元 23.5%、贫困率 16.3%、药物中毒年龄调整死亡率 8.5%。解读:Y 是按“当年中位数”二分的,所以模型描述的是“哪些地区排在高的一半”,不是自杀率有多高。人口规模的 STVPI 最大,说明人口多少与“是否排在高的一半”的关联在地区之间差异最大。
先把每年 49 个地区分成“高”“低”两组,再看什么因素和“被分到高组”有关、这种关系在各州有什么不同。
10.4 4b:计数结局(标准化 = 是)——如实呈现模型评价
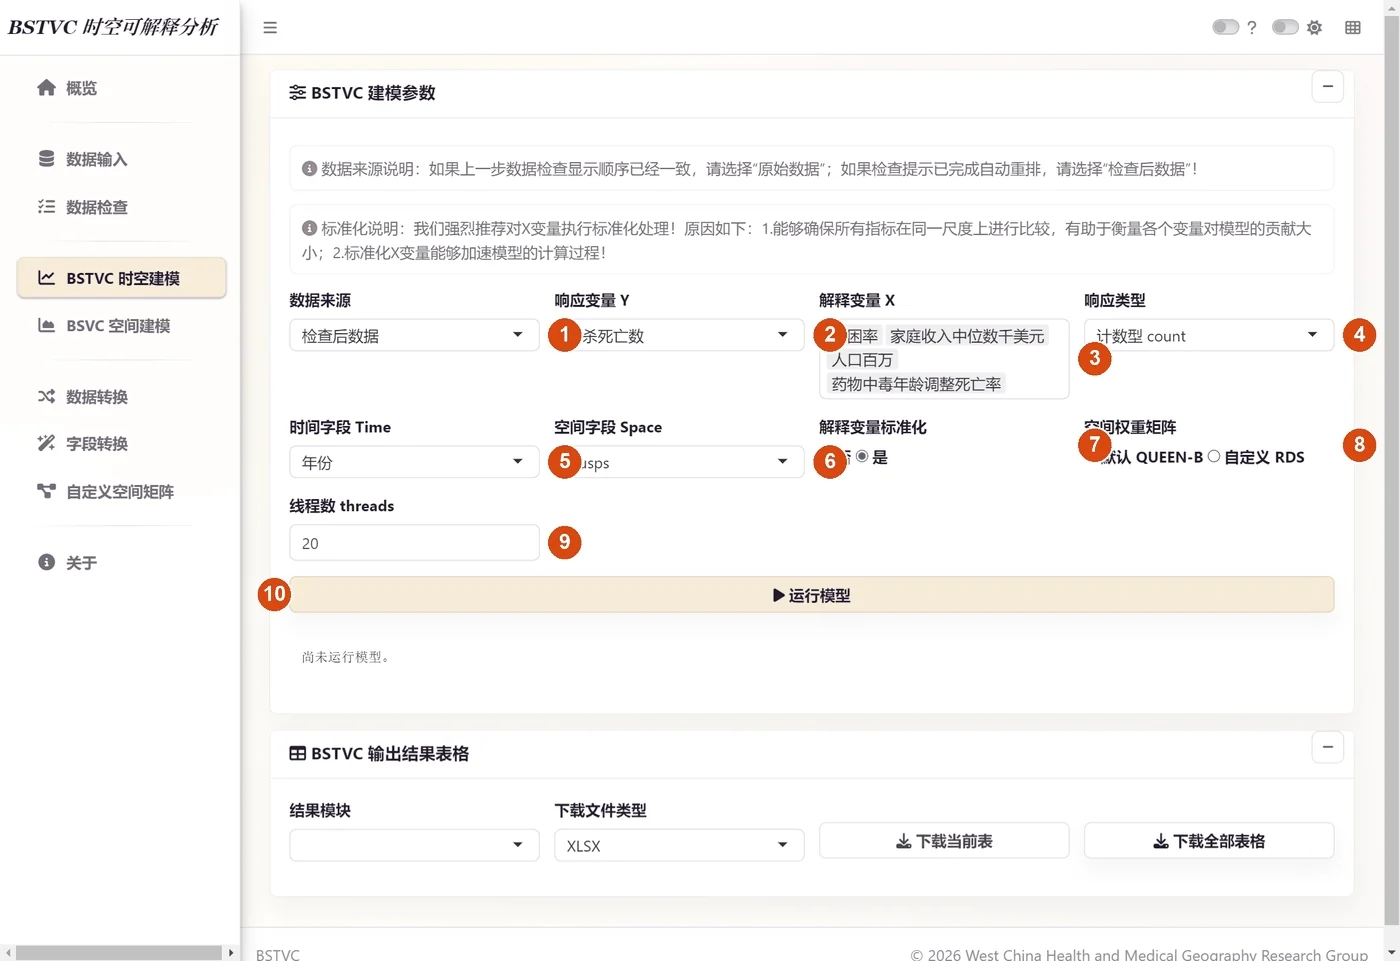
- 在同一页把 Y 换成
自杀死亡数,响应类型换成计数型 count(24)。死亡数是非负整数。 - 解释变量标准化 = 是(7)。只有把各 X 放到同一尺度上,STVPI 的“各因子贡献百分比”才能相互比较(见下面的对照)。
- 其余不变 → 运行模型(< 15 秒)→ 下载全部表格 → 打开
model.evaluation。
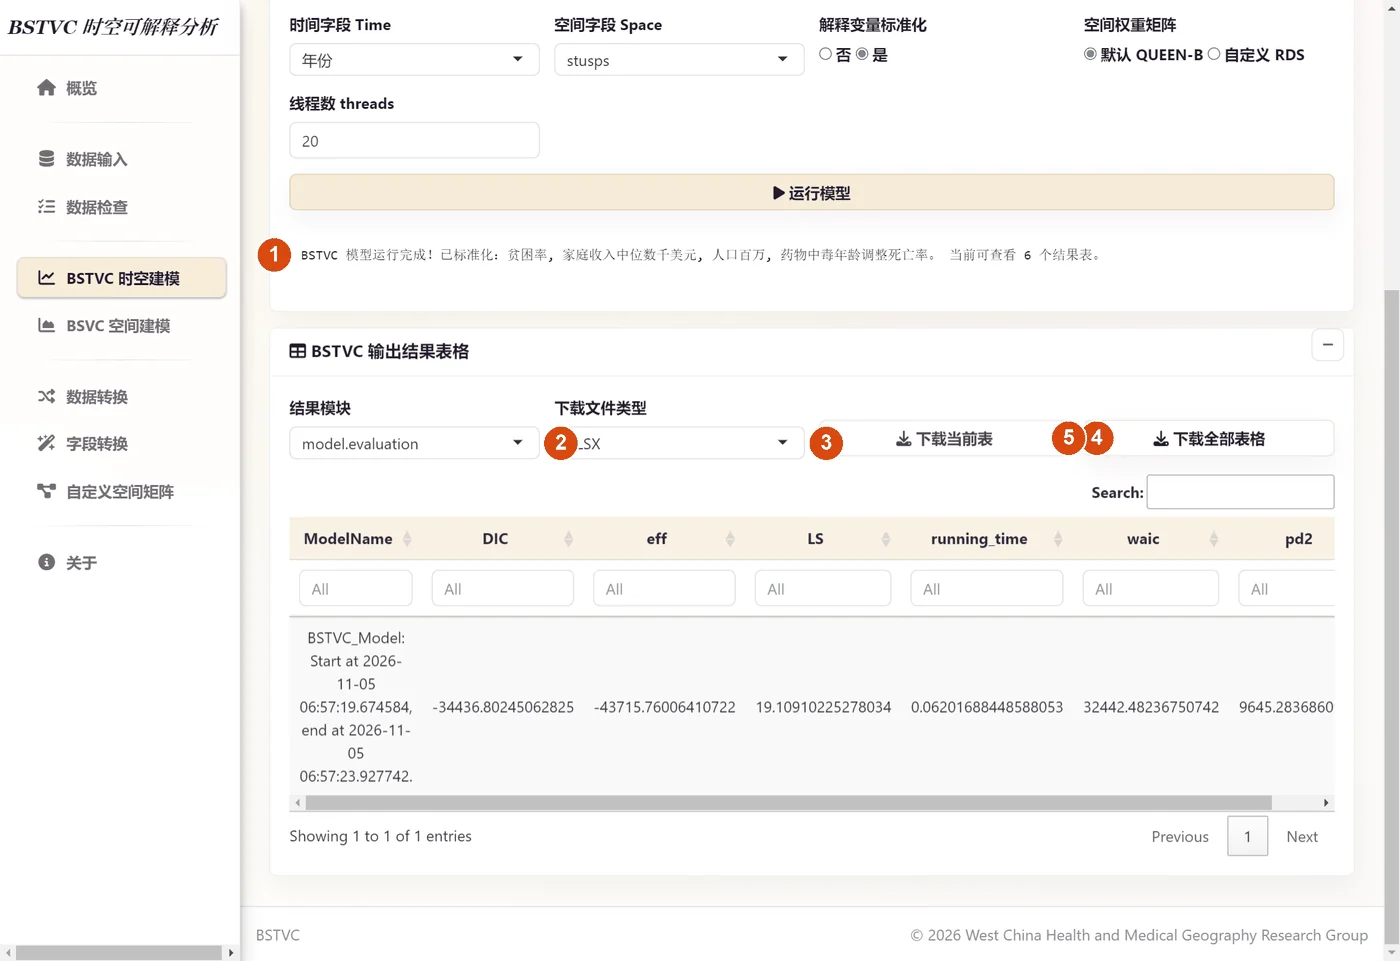
怎么读这组数:这次的 eff 和 DIC 是负数。eff 是软件给出的“模型复杂度”指标,在某些数据和设置下可能为负;WAIC 的复杂度指标 pd2 为正。这是本数据在该设置下的真实输出,本手册如实呈现;是否采用、如何解释,由使用者根据研究目的独立判断。
- 一句话
- DIC、WAIC 衡量“拟合得好又不过分复杂”,LS 衡量逐个留出时的预测得分,三者都是越小越好;eff、pd2 是两种算法各自给出的模型复杂度。
- 打个比方
- 两位老师用不同的评分细则给同一份卷子打分(DIC 与 WAIC),分数不同很正常。
- 为什么要看
- 它们一起描述这次拟合;在同一份数据、同一个 Y 上,可以用来比较几个模型。
- 怎么用
- DIC 对 DIC、WAIC 对 WAIC,不要拿 DIC 去比 WAIC;全部数字如实写进论文附表。
- 讲给别人听
- “DIC 和 WAIC 是两把尺子,各量各的;越小越好,只在同一份数据上比。”
10.4.1 对照:标准化与否,STVPI 会变
为说明标准化对“各因子贡献”的影响,下表把三个案例分别按“标准化 = 是 / 否”运行(其余设置相同),比较各因子的 STVPI(空间 + 时间合计):
| 案例 | 因子 | STVPI · 标准化 = 是 | STVPI · 标准化 = 否 |
|---|---|---|---|
| 案例1 连续型 | 城市人口比例 | 43.4% | 10.3% |
| 案例1 连续型 | PM25暴露 | 4.0% | 3.1% |
| 案例1 连续型 | 人口百万 | 51.4% | 77.7% |
| 案例4a 二分类 | 贫困率 | 16.2% | 16.7% |
| 案例4a 二分类 | 家庭收入中位数千美元 | 23.5% | 6.9% |
| 案例4a 二分类 | 人口百万 | 49.5% | 45.2% |
| 案例4a 二分类 | 药物中毒年龄调整死亡率 | 8.5% | 27.0% |
| 案例4b 计数 | 药物中毒年龄调整死亡率 | 6.6% | 3.6% |
| 案例4b 计数 | 人口百万 | 80.0% | 81.1% |
| 案例4b 计数 | 家庭收入中位数千美元 | 7.9% | 5.9% |
| 案例4b 计数 | 贫困率 | 5.4% | 9.4% |
STVPI 为空间 + 时间合计的后验均值;红色 = 两种设置相差超过 5 个百分点。案例 4b“标准化 = 是”一栏来自 eff 为负的拟合。其余设置相同。
结果:STVPI 随 X 的量纲改变(案例 1 城市人口比例 43% → 10%,案例 4a 药物中毒死亡率 9% → 27%),未标准化时连模型拟合本身也不同。因此比较不同 X 的相对贡献,必须先标准化;未标准化时,只能分别解读每个变量自己的系数格局。案例 4b 在“标准化 = 否”时 eff = 172.8、DIC = 6,341.4,但此时不同 X 的 STVPI 不能相互比较。
贡献百分比像“把总分按科目分配”。各科如果用的是不同的计分尺度(米和厘米混用),分出来的比例就不对;标准化就是先把尺度统一。
10.5 可视化与解读:4a 二分类
结果工作簿可以直接画成论文图。代码和画好的图(中文、英文两套,300 dpi PNG + 矢量 PDF)都在 Case-04-US-Suicide-Binary-and-Count\visualization\:把 R 的工作目录设为该案例文件夹,运行 source("visualization/Case4a_US_suicide_binary.R")。
本例的 R 代码(点开可复制)
# ==========================================================================================
#  怎么运行 / How to run
#  1. 安装一次 R 包 / install once:
#     install.packages(c("readxl","dplyr","tidyr","ggplot2","sf","patchwork","scales","RColorBrewer","classInt","ragg","systemfonts"))
#  2. 把工作目录设为本案例文件夹(纯英文路径)/ set the working directory to this case folder (ASCII path):
#     setwd("D:/BSTVC_data/Case-04-US-Suicide-Binary-and-Count")
#  3. source("visualization/Case4a_US_suicide_binary.R")
#  图写到 visualization/outputs/<中文 zh | 英文 en>/;进阶模块的图在其中的 local_coef_module/。
#  换成你自己的结果:改下面 cfg 里的文件名、空间字段 key、结局类型和变量中英对照 var_en 即可。
# ==========================================================================================
# 案例 4a:美国 49 个地区 2004–2016 年高自杀率状态(二分类,派生)
# Case 4a: high suicide-rate status in 49 US areas, 2004-2016 (binary, derived)
source("visualization/R/bstvc_plot_functions.R"); source("visualization/R/run_case.R")
source("visualization/R/bstvc_local_coef_functions.R"); source("visualization/R/run_local_coef.R")
cfg <- list(
  id = "Case4a_US_suicide_binary", title = "案例 4a 美国高自杀率", title_en = "Case 4a US high suicide rate",
  xlsx = "reference_results_V2/Case4a_binary_V2_all_result_tables.xlsx", shp = "us_states_contiguous.shp", outdir = "visualization/outputs", key = "stusps",
  data = "us_suicide_panel_zh.csv",
  type = "binary", standardized = TRUE, label_field = "name",
  t0 = 2004, tlab = "年份", tlab_en = "Year", time_col = "年份", pred_times = c(2004, 2010, 2016),
  pred_label = "预测概率", pred_label_en = "Fitted probability",
  var_en = c("贫困率" = "Poverty rate", "家庭收入中位数千美元" = "Median household income", "人口百万" = "Population",
             "药物中毒年龄调整死亡率" = "Drug overdose mortality"))

for (lang in c("zh", "en")) {
  run_case(modifyList(cfg, list(lang = lang)))          # 核心图 / core figures
  run_local_coef(modifyList(cfg, list(lang = lang)))    # 进阶模块(可选)/ optional SHAP-style module
}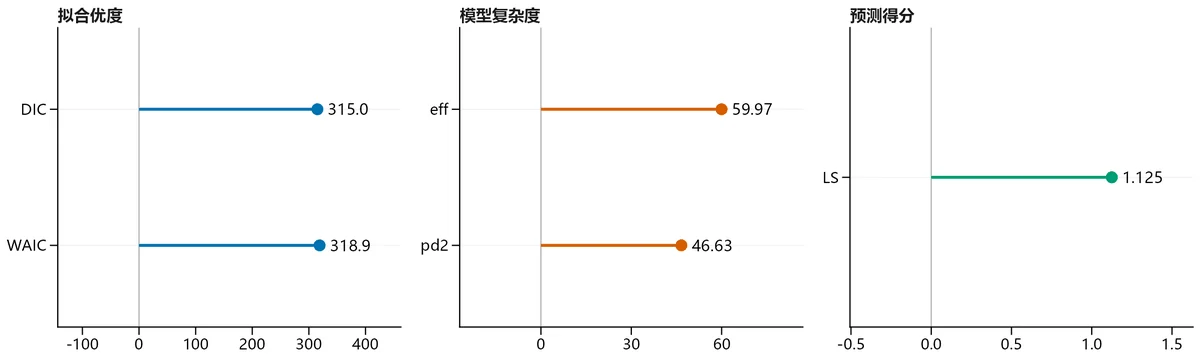
- 三组数字:拟合优度(DIC、WAIC)、模型复杂度(eff、pd2)、预测得分(LS)。
- DIC、WAIC、LS 越小越好,只在同一份数据、同一个 Y 的几个模型之间比较;DIC 和 WAIC 是两种算法,数值不同属正常。
- DIC 315.0,WAIC 318.9,LS 1.125;eff 60.0,pd2 46.6。
- 拟合值与观测值的一致程度:AUC = 0.990。
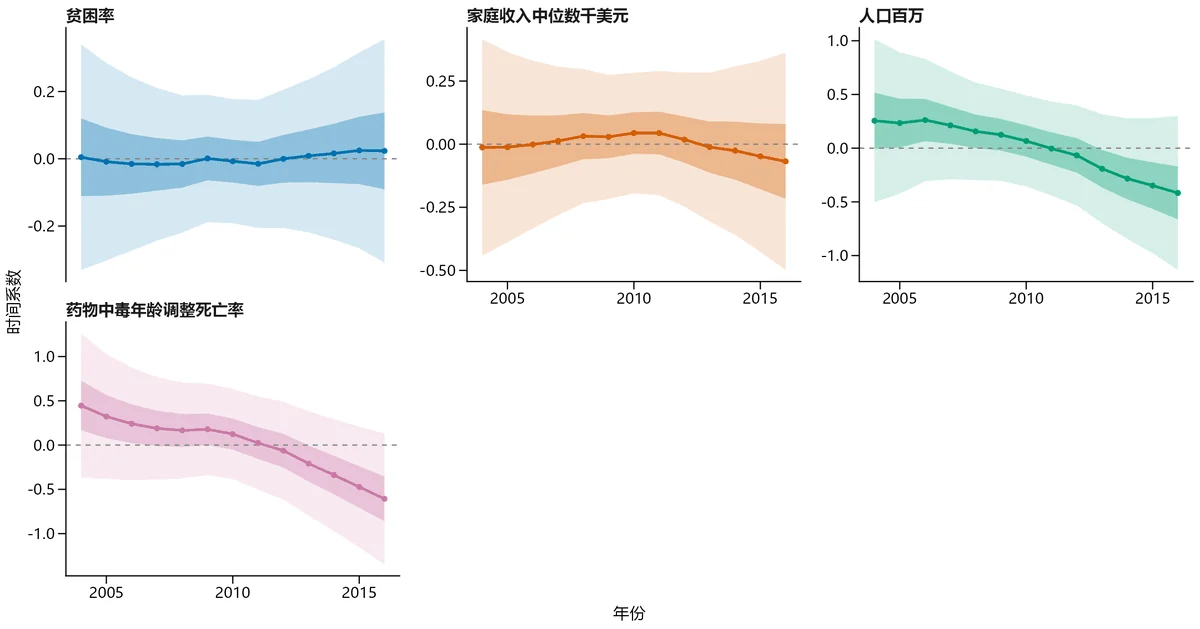
- 每个小图一个因素;横轴是时间,0 线 = 整个研究时期的平均水平。
- 曲线在 0 以上:这个时点作用比平时更强(更正向);在 0 以下:更弱(更负向)。
- 深色带 = 50%、浅色带 = 95% 可信区间:带子越窄,越有把握。各小图纵轴刻度不同。
- 药物中毒年龄调整死亡率:从 0.446 到 −0.607,总体下降;最强在 2004 年,最弱在 2016 年。
- 人口百万:从 0.256 到 −0.417,总体下降;最强在 2006 年,最弱在 2016 年。
- 家庭收入中位数千美元:从 −0.013 到 −0.068,总体下降;最强在 2010 年,最弱在 2016 年。
- 贫困率:从 0.005 到 0.023,总体上升;最强在 2015 年,最弱在 2007 年。
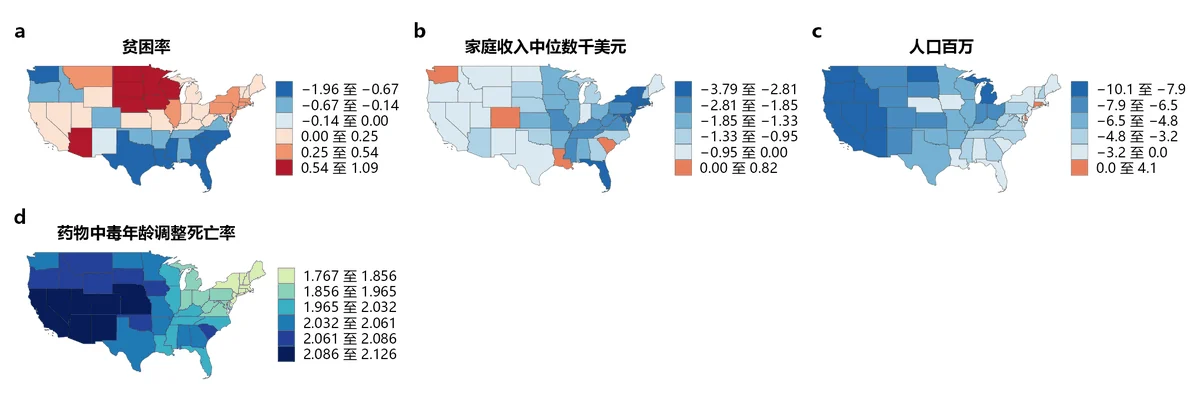
- 每幅地图一个因素,颜色 = 这个地区的空间系数:红 = 推高结局,蓝 = 拉低结局,颜色越深作用越强。
- 每幅地图各自分级,比较大小要看图例上的数值。
- 空间系数 = 这个地区在整个研究时期的平均作用;某地某时的完整作用 = 空间系数 + 该时点的时间系数。
- 人口百万:从 −10.10(Oregon)到 4.09(Rhode Island)。
- 家庭收入中位数千美元:从 −3.79(Delaware)到 0.82(Washington)。
- 贫困率:从 −1.96(Louisiana)到 1.09(Iowa)。
- 药物中毒年龄调整死亡率:从 1.77(Rhode Island)到 2.13(Nebraska)。
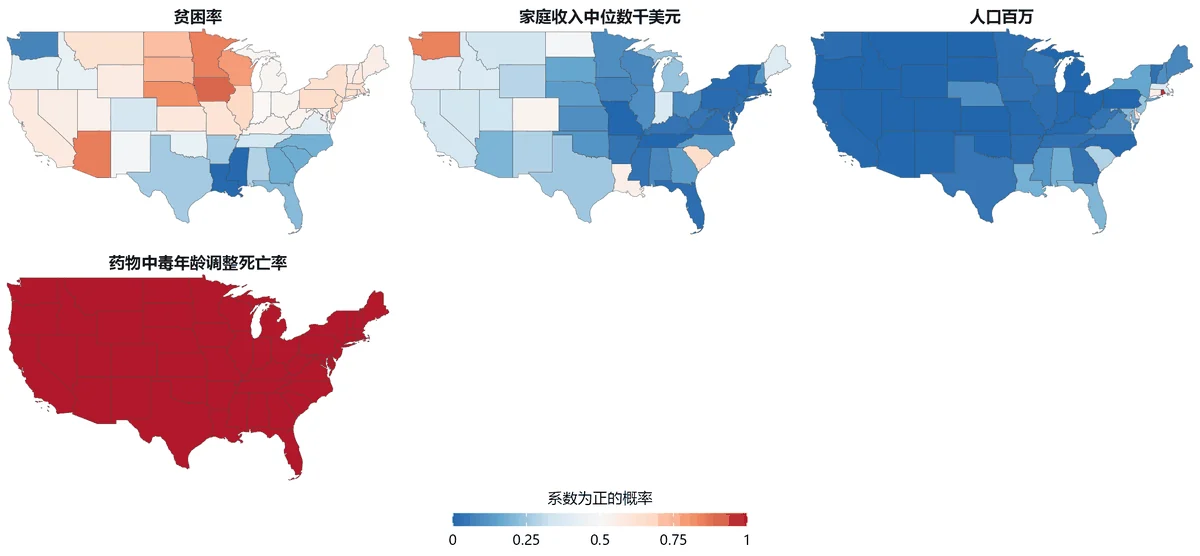
- 颜色 = 这个地区“作用为正”的概率,0 到 1 连续变化:越红越有把握“推高”,越蓝越有把握“拉低”,接近白色 = 方向还说不准。
- 和图 3 搭配看:图 3 看“作用多大”,图 3b 看“方向有几成把握”。
- 药物中毒年龄调整死亡率:100% 的地区“作用为正”的把握在八成以上,0% 的地区“作用为负”的把握在八成以上。
- 人口百万:2% 的地区“作用为正”的把握在八成以上,82% 的地区“作用为负”的把握在八成以上。
- 家庭收入中位数千美元:2% 的地区“作用为正”的把握在八成以上,65% 的地区“作用为负”的把握在八成以上。
- 贫困率:8% 的地区“作用为正”的把握在八成以上,12% 的地区“作用为负”的把握在八成以上。
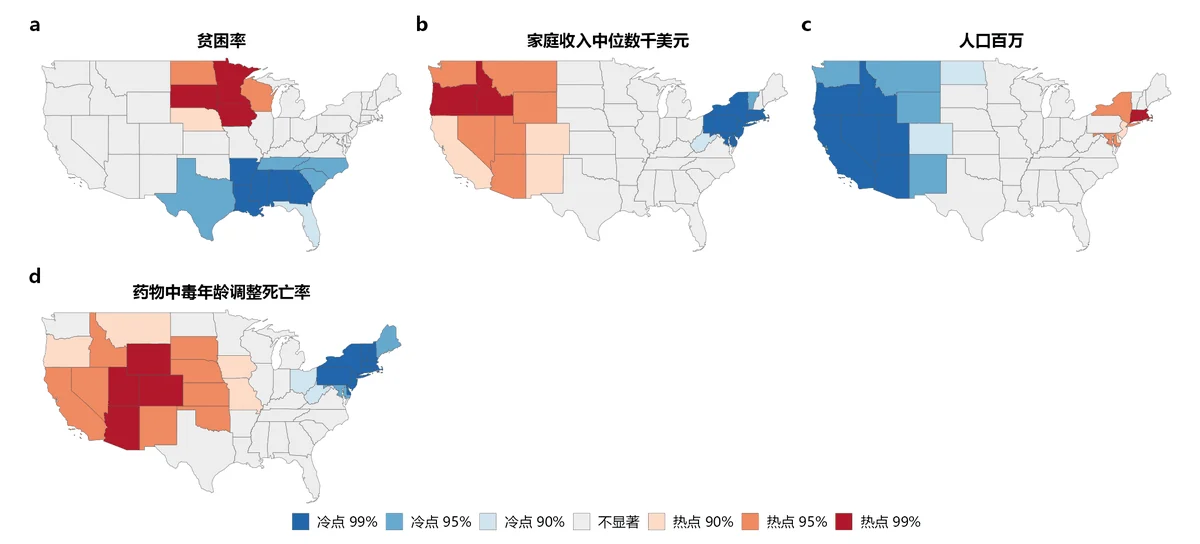
- 找出空间系数“成片偏高”(热点,红色)和“成片偏低”(冷点,蓝色)的区域;灰色 = 没有成片。
- 用来回答:作用特别强(或特别弱)的地区是不是连在一起,适合划定重点区域。
- 贫困率:热点 5 个(如 South Dakota、Iowa、Minnesota),冷点 9 个(如 Louisiana、Mississippi、Arkansas)。
- 家庭收入中位数千美元:热点 8 个(如 Idaho、Oregon、Utah),冷点 9 个(如 New York、Massachusetts、Connecticut)。
- 人口百万:热点 6 个(如 Rhode Island、Connecticut、Massachusetts),冷点 10 个(如 Idaho、Nevada、Oregon)。
- 药物中毒年龄调整死亡率:热点 12 个(如 Colorado、Utah、Arizona),冷点 11 个(如 Massachusetts、New York、Connecticut)。
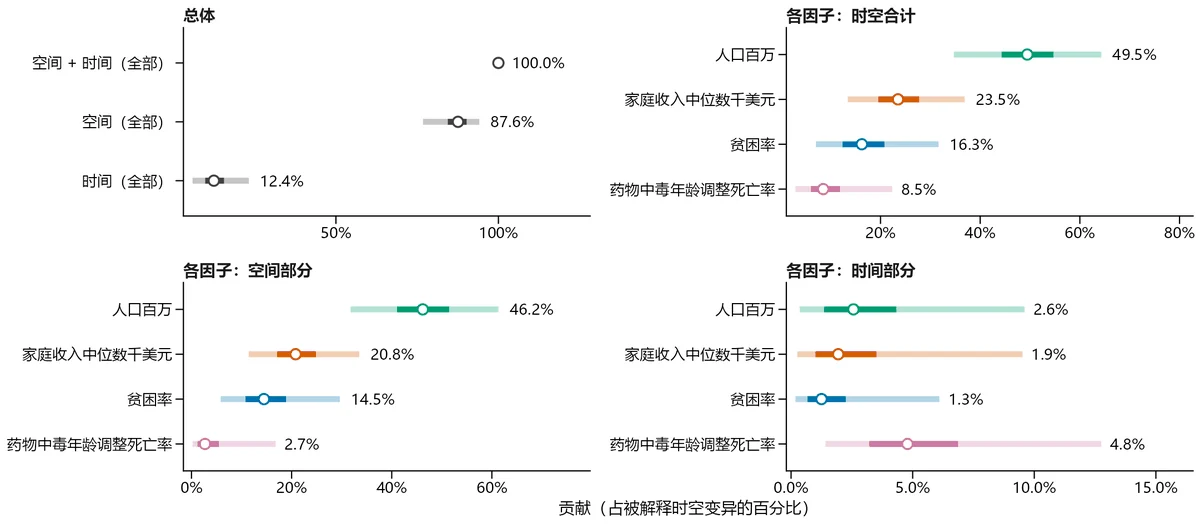
- 左上“总体”:结局的时空差异里,空间部分、时间部分各占多少。
- 其余面板:每个因素的贡献(时空合计、空间部分、时间部分);圆圈 = 估计值,粗、细条 = 50%、95% 可信区间。
- 只有解释变量标准化后,不同因素的百分比才能互相比较。
- 各因素(空间 + 时间合计):
人口百万49.5%、家庭收入中位数千美元23.5%、贫困率16.3%、药物中毒年龄调整死亡率8.5%。 - 区间重叠很多的因素,排名不要说得太死。
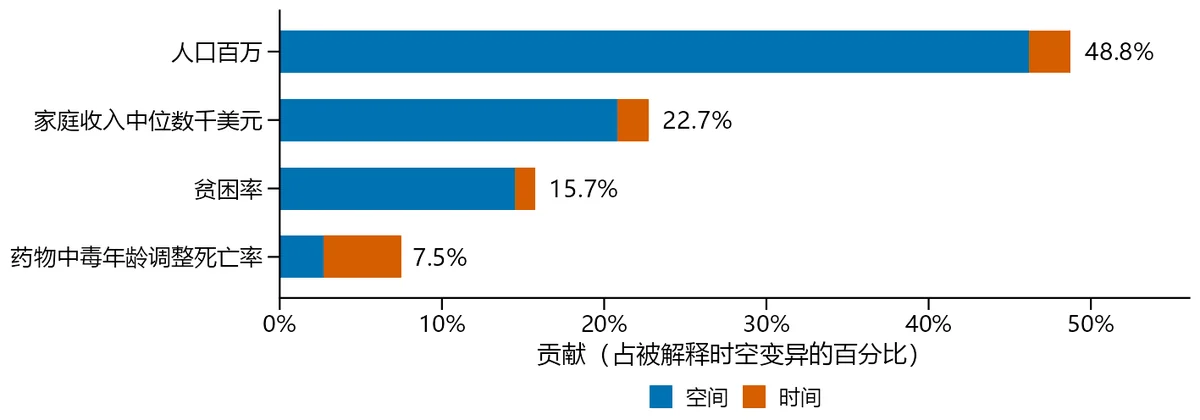
- 一根条 = 一个因素,条长 = 它的总贡献;两段颜色 = 空间部分和时间部分。
- 条最长的因素是本研究的关键因素候选;空间段占绝大部分 → “因地制宜”;时间段明显 → 还要“因时制宜”。
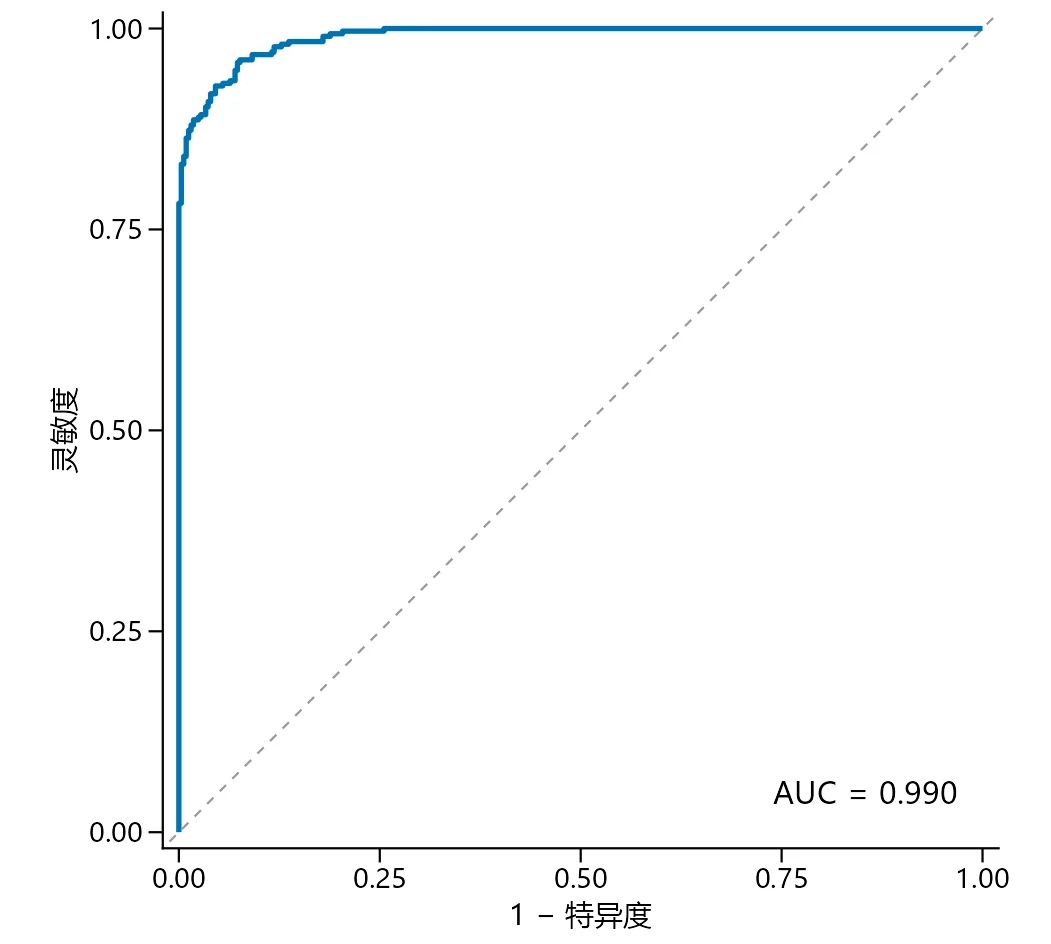
- ROC 曲线越靠近左上角越好;AUC 0.5 = 瞎猜,1 = 完全分得开。
- 这是在同一份数据上的拟合,不等于对新数据的预测能力。
- AUC = 0.990(637 个观测)。
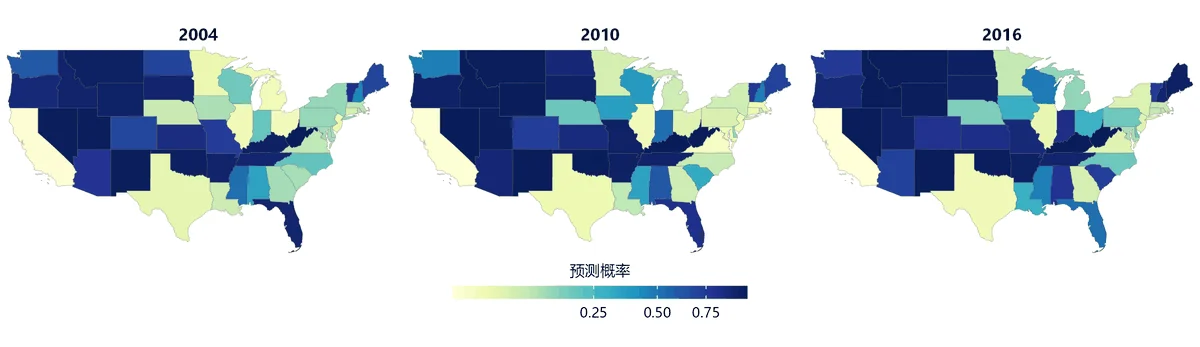
- 几个时点并排,共用同一色标:颜色的变化就是时间上的变化。
- 原数据里缺失的地区和年份也有拟合值,可用于补缺。
- 对比首末时点,看结局整体升降和空间格局有没有变。
想更深入地挖掘各地区的局部系数?本案例的全套类 SHAP 进阶图见第 14 章对应小节。
10.6 可视化与解读:4b 计数
结果工作簿可以直接画成论文图。代码和画好的图(中文、英文两套,300 dpi PNG + 矢量 PDF)都在 Case-04-US-Suicide-Binary-and-Count\visualization\:把 R 的工作目录设为该案例文件夹,运行 source("visualization/Case4b_US_suicide_count.R")。
本例的 R 代码(点开可复制)
# ==========================================================================================
#  怎么运行 / How to run
#  1. 安装一次 R 包 / install once:
#     install.packages(c("readxl","dplyr","tidyr","ggplot2","sf","patchwork","scales","RColorBrewer","classInt","ragg","systemfonts"))
#  2. 把工作目录设为本案例文件夹(纯英文路径)/ set the working directory to this case folder (ASCII path):
#     setwd("D:/BSTVC_data/Case-04-US-Suicide-Binary-and-Count")
#  3. source("visualization/Case4b_US_suicide_count.R")
#  图写到 visualization/outputs/<中文 zh | 英文 en>/;进阶模块的图在其中的 local_coef_module/。
#  换成你自己的结果:改下面 cfg 里的文件名、空间字段 key、结局类型和变量中英对照 var_en 即可。
# ==========================================================================================
# 案例 4b:美国 49 个地区 2004–2016 年自杀死亡数(计数型,标准化 = 是)
# Case 4b: suicide deaths in 49 US areas, 2004-2016 (count, standardized)
source("visualization/R/bstvc_plot_functions.R"); source("visualization/R/run_case.R")
source("visualization/R/bstvc_local_coef_functions.R"); source("visualization/R/run_local_coef.R")
cfg <- list(
  id = "Case4b_US_suicide_count", title = "案例 4b 美国自杀死亡数", title_en = "Case 4b US suicide deaths",
  xlsx = "reference_results_V2/Case4b_count_StandardizeYes_V2_all_result_tables.xlsx", shp = "us_states_contiguous.shp", outdir = "visualization/outputs", key = "stusps",
  data = "us_suicide_panel_zh.csv",
  type = "count", standardized = TRUE, logaxes = TRUE, label_field = "name",
  t0 = 2004, tlab = "年份", tlab_en = "Year", time_col = "年份", pred_times = c(2004, 2010, 2016),
  pred_label = "死亡数", pred_label_en = "Deaths",
  var_en = c("贫困率" = "Poverty rate", "家庭收入中位数千美元" = "Median household income", "人口百万" = "Population",
             "药物中毒年龄调整死亡率" = "Drug overdose mortality"))

for (lang in c("zh", "en")) {
  run_case(modifyList(cfg, list(lang = lang)))          # 核心图 / core figures
  run_local_coef(modifyList(cfg, list(lang = lang)))    # 进阶模块(可选)/ optional SHAP-style module
}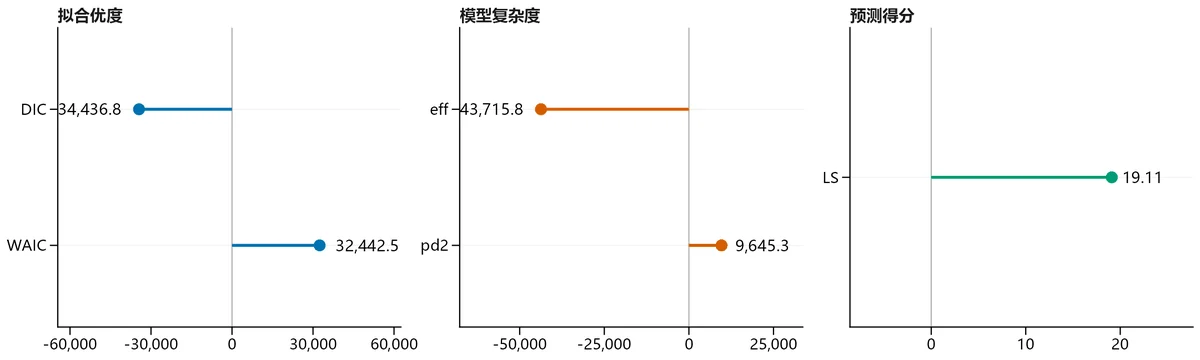
- 三组数字:拟合优度(DIC、WAIC)、模型复杂度(eff、pd2)、预测得分(LS)。
- DIC、WAIC、LS 越小越好,只在同一份数据、同一个 Y 的几个模型之间比较;DIC 和 WAIC 是两种算法,数值不同属正常。
- DIC −34,436.8,WAIC 32,442.5,LS 19.109;eff −43,715.8,pd2 9,645.3。
- 拟合值与观测值的一致程度:R² = 0.925。
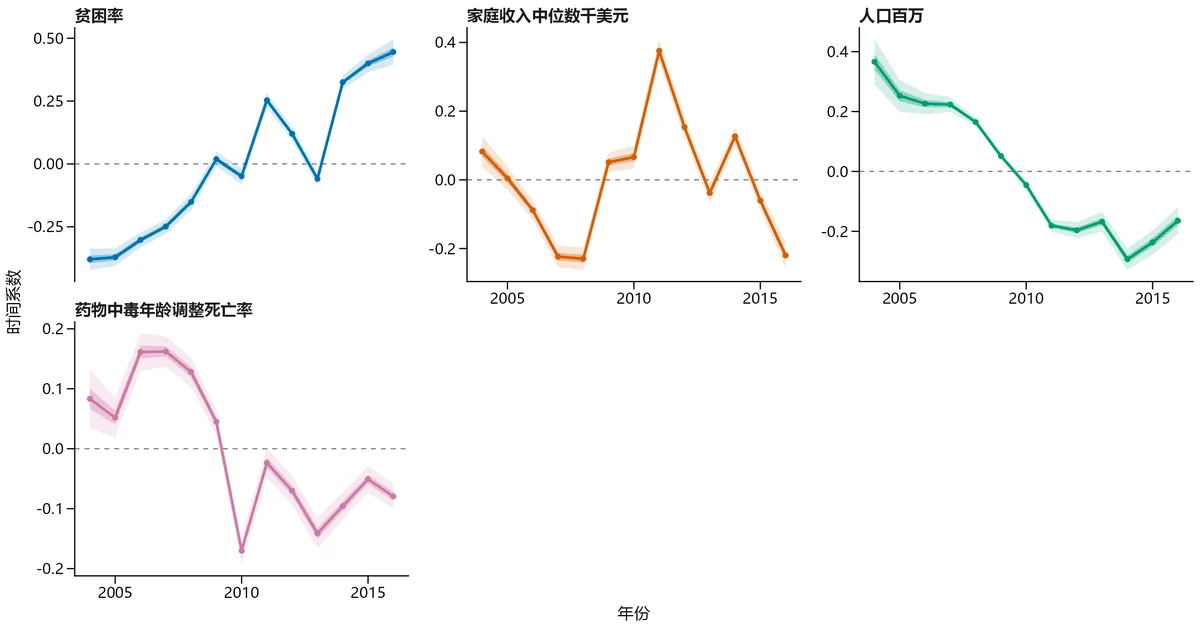
- 每个小图一个因素;横轴是时间,0 线 = 整个研究时期的平均水平。
- 曲线在 0 以上:这个时点作用比平时更强(更正向);在 0 以下:更弱(更负向)。
- 深色带 = 50%、浅色带 = 95% 可信区间:带子越窄,越有把握。各小图纵轴刻度不同。
- 贫困率:从 −0.379 到 0.445,总体上升;最强在 2016 年,最弱在 2004 年。
- 人口百万:从 0.366 到 −0.165,总体下降;最强在 2004 年,最弱在 2014 年。
- 家庭收入中位数千美元:从 0.082 到 −0.220,总体上升;最强在 2011 年,最弱在 2008 年。
- 药物中毒年龄调整死亡率:从 0.083 到 −0.080,总体下降;最强在 2007 年,最弱在 2010 年。
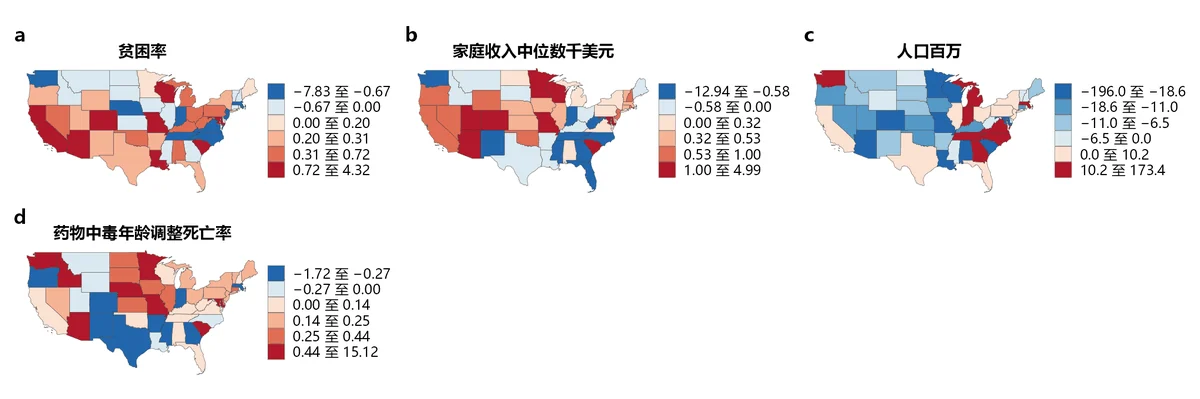
- 每幅地图一个因素,颜色 = 这个地区的空间系数:红 = 推高结局,蓝 = 拉低结局,颜色越深作用越强。
- 每幅地图各自分级,比较大小要看图例上的数值。
- 空间系数 = 这个地区在整个研究时期的平均作用;某地某时的完整作用 = 空间系数 + 该时点的时间系数。
- 人口百万:从 −196.02(Missouri)到 173.37(Washington)。
- 家庭收入中位数千美元:从 −12.94(Washington)到 4.99(Missouri)。
- 药物中毒年龄调整死亡率:从 −1.72(Georgia)到 15.12(Arizona)。
- 贫困率:从 −7.83(Washington)到 4.32(Missouri)。
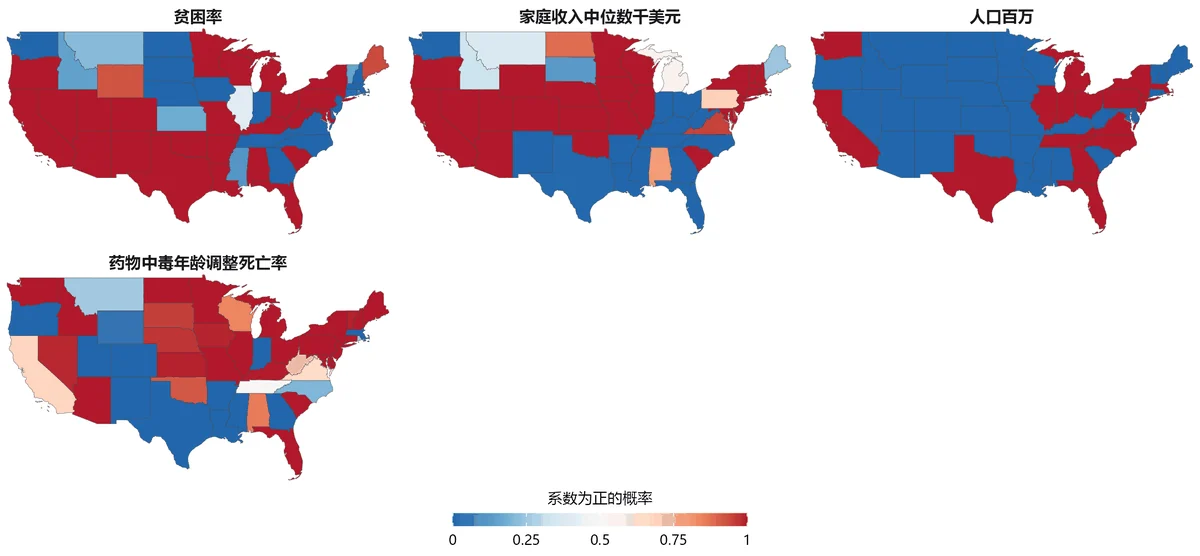
- 颜色 = 这个地区“作用为正”的概率,0 到 1 连续变化:越红越有把握“推高”,越蓝越有把握“拉低”,接近白色 = 方向还说不准。
- 和图 3 搭配看:图 3 看“作用多大”,图 3b 看“方向有几成把握”。
- 人口百万:33% 的地区“作用为正”的把握在八成以上,67% 的地区“作用为负”的把握在八成以上。
- 贫困率:53% 的地区“作用为正”的把握在八成以上,43% 的地区“作用为负”的把握在八成以上。
- 家庭收入中位数千美元:55% 的地区“作用为正”的把握在八成以上,33% 的地区“作用为负”的把握在八成以上。
- 药物中毒年龄调整死亡率:61% 的地区“作用为正”的把握在八成以上,24% 的地区“作用为负”的把握在八成以上。
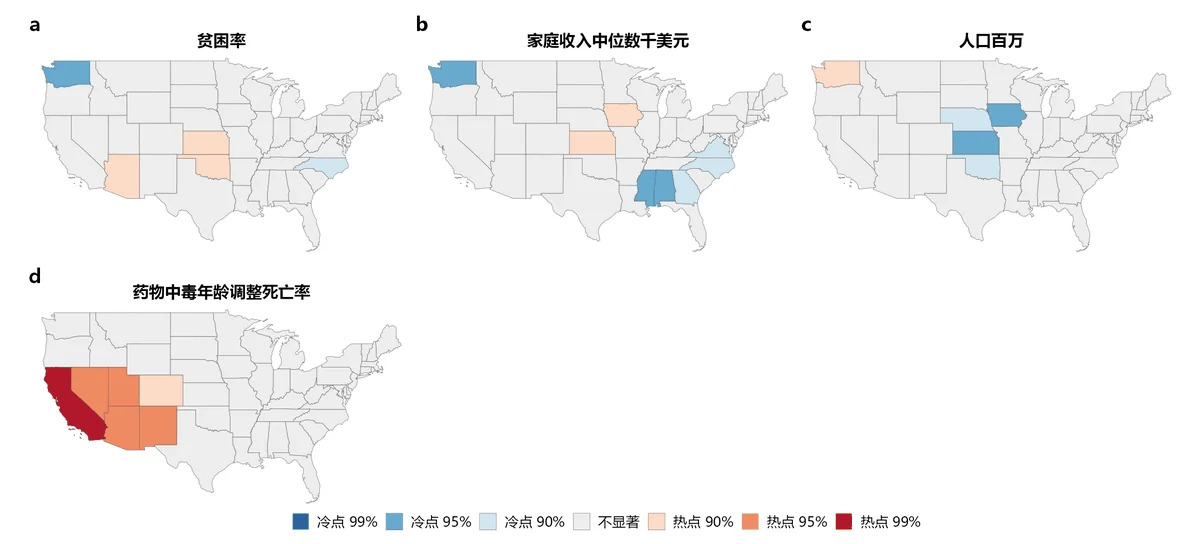
- 找出空间系数“成片偏高”(热点,红色)和“成片偏低”(冷点,蓝色)的区域;灰色 = 没有成片。
- 用来回答:作用特别强(或特别弱)的地区是不是连在一起,适合划定重点区域。
- 贫困率:热点 0 个,冷点 1 个(如 Washington)。
- 家庭收入中位数千美元:热点 0 个,冷点 3 个(如 Washington、Alabama、Mississippi)。
- 人口百万:热点 0 个,冷点 2 个(如 Iowa、Kansas)。
- 药物中毒年龄调整死亡率:热点 5 个(如 California、Nevada、Arizona),冷点 0 个。
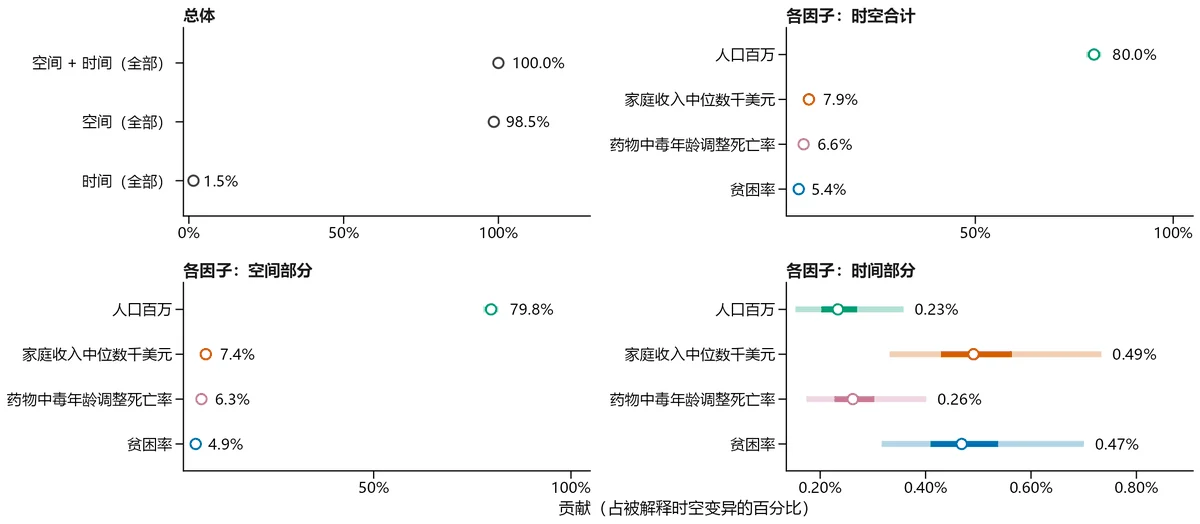
- 左上“总体”:结局的时空差异里,空间部分、时间部分各占多少。
- 其余面板:每个因素的贡献(时空合计、空间部分、时间部分);圆圈 = 估计值,粗、细条 = 50%、95% 可信区间。
- 只有解释变量标准化后,不同因素的百分比才能互相比较。
- 各因素(空间 + 时间合计):
人口百万80.0%、家庭收入中位数千美元7.9%、药物中毒年龄调整死亡率6.6%、贫困率5.4%。 - 区间重叠很多的因素,排名不要说得太死。
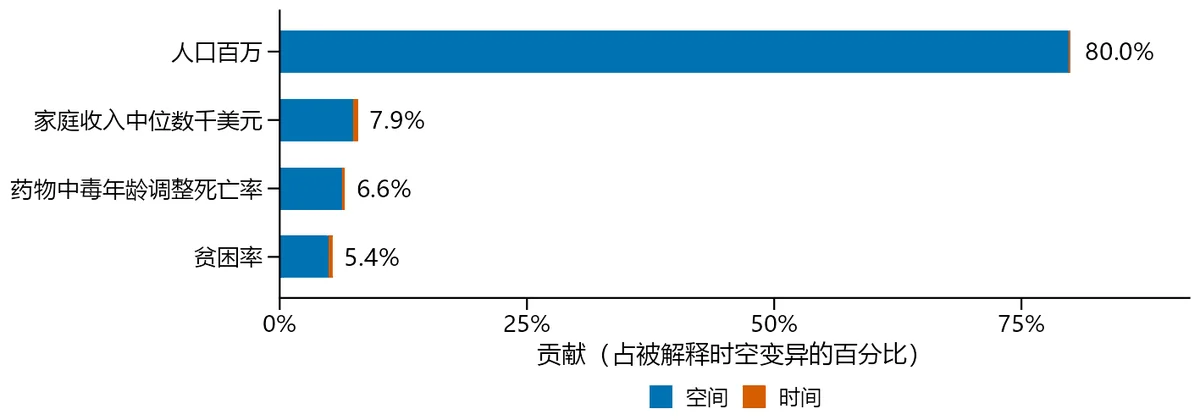
- 一根条 = 一个因素,条长 = 它的总贡献;两段颜色 = 空间部分和时间部分。
- 条最长的因素是本研究的关键因素候选;空间段占绝大部分 → “因地制宜”;时间段明显 → 还要“因时制宜”。
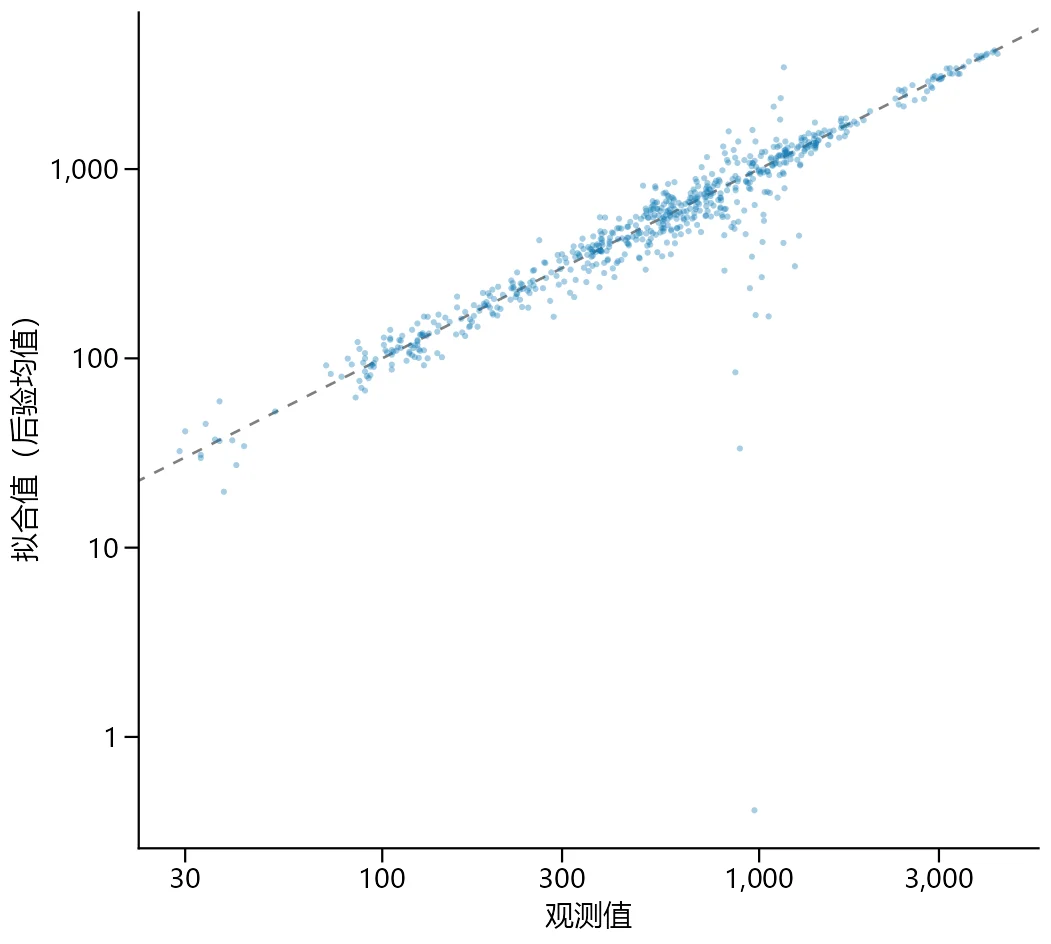
- 横轴观测值,纵轴模型拟合值;点越贴近虚线越好。
- R² 越接近 1 越好;RMSE 是平均误差的大小(和 Y 同单位)。
- R² = 0.925,RMSE = 203.63(637 个有观测的单元)。
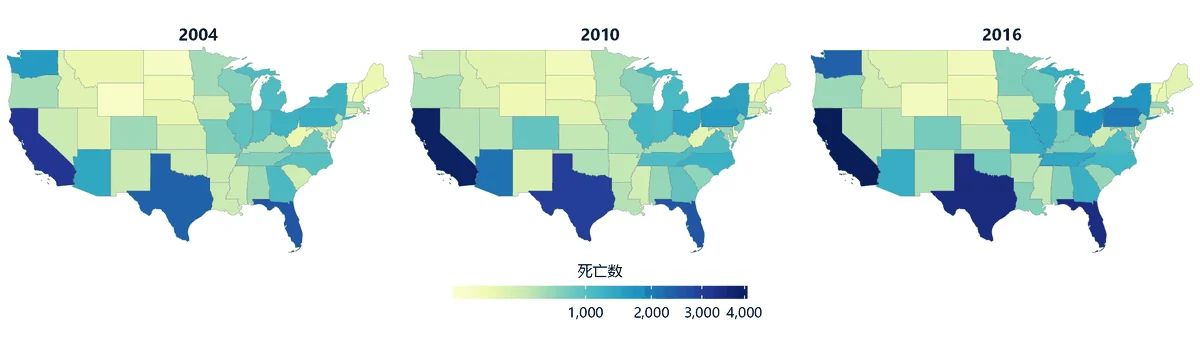
- 几个时点并排,共用同一色标:颜色的变化就是时间上的变化。
- 原数据里缺失的地区和年份也有拟合值,可用于补缺。
- 对比首末时点,看结局整体升降和空间格局有没有变。
想更深入地挖掘各地区的局部系数?本案例的全套类 SHAP 进阶图见第 14 章对应小节。
11 案例 5 · 仅空间模型 BSVC:美国 49 个地区 2016 年高自杀率状态
11.1 案例卡
| 表格 | US_suicide_2016_cross_section_zh.csv:案例 4 面板中“年份 = 2016”的 49 行,每个地区只出现一次,没有时间字段 |
| 地图 | us_states_contiguous.*(同案例 4) |
| Y / X | 高自杀率(0/1)/ 案例 4 的四个 X |
| 设置 | BSVC 空间建模 · 二分类 · 检查后数据 · 标准化 = 是 · QUEEN-B · 线程 20 |
- 一句话
- BSVC 只让系数随地区变(一个时点);BSTVC 让系数同时随地区和时间变(多个时点)。
- 打个比方
- BSVC 是一张照片,BSTVC 是一段录像。
- 为什么要用
- 很多数据只有一次普查或一年的截面,这时用 BSVC;硬套 BSTVC 没有时间信息可用。
- 怎么用
- 数据检查选“BSVC 空间截面”(只填空间字段)→ 左侧点“BSVC 空间建模” → 参数里没有时间字段 → 结果 5 张表(没有 time.coefficients)。
- 讲给别人听
- “只有一年的数据用 BSVC,看的是各地区的差别。”
11.2 步骤 A、B:数据输入与“截面”检查
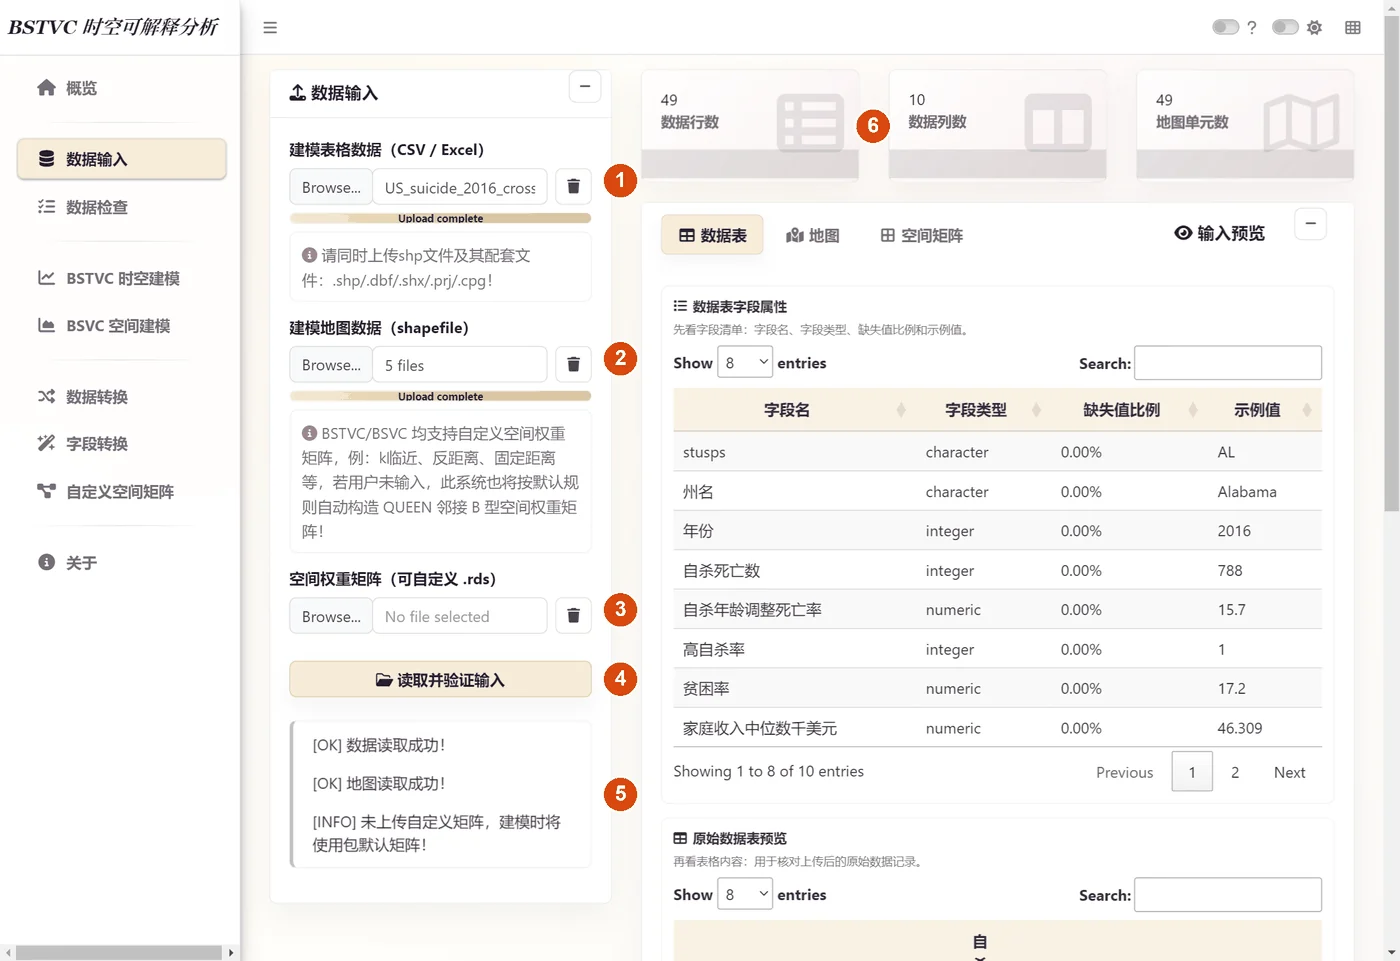
- 数据输入:载入截面表格和地图 → 核对 49 行、10 列、49 个地图单元。
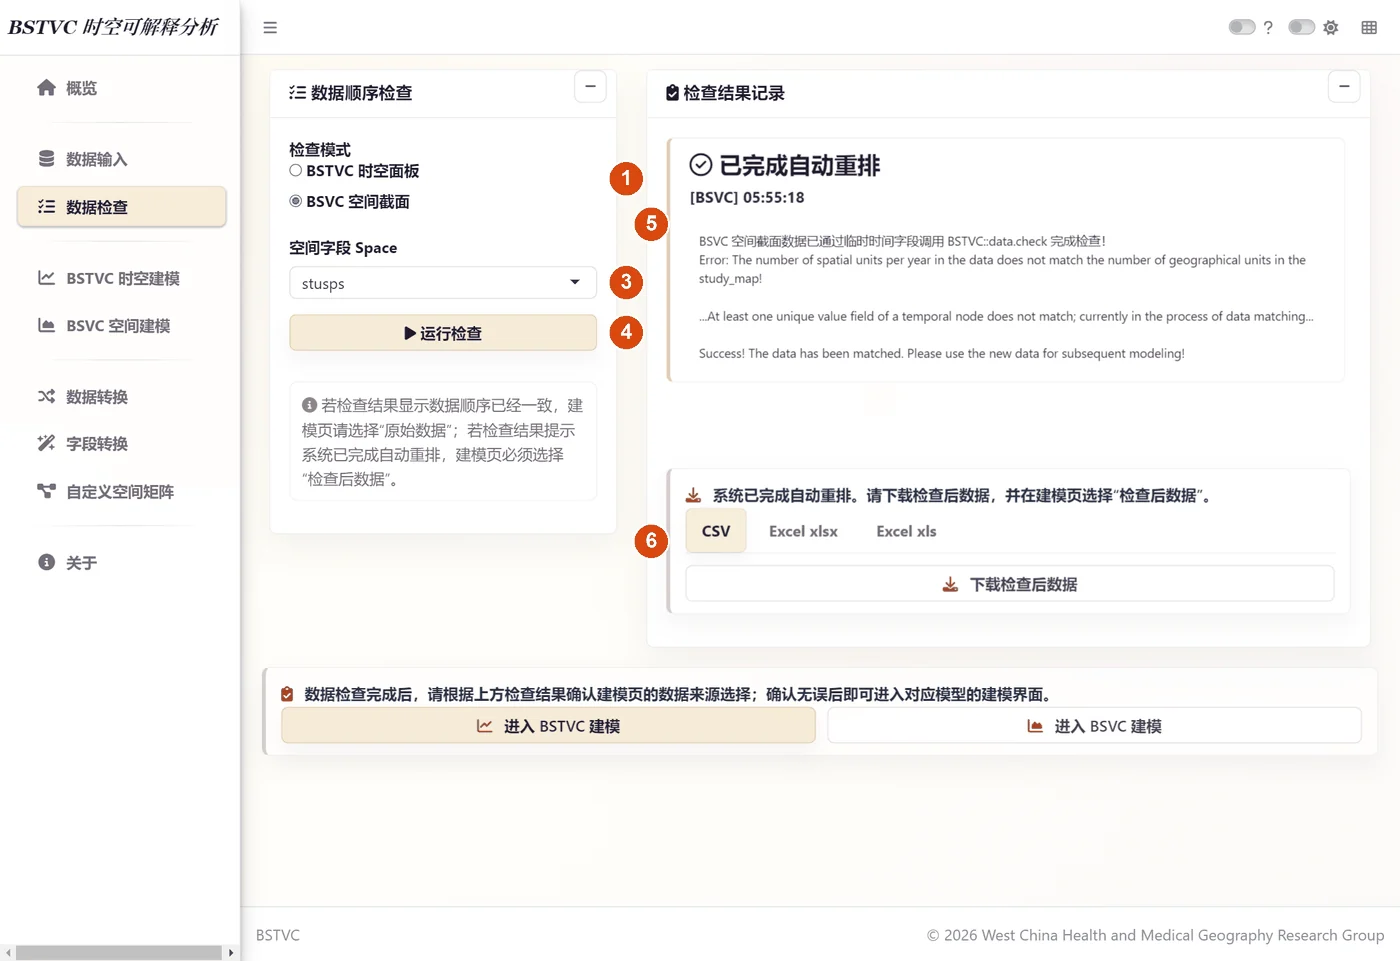
- 数据检查:检查模式选 BSVC 空间截面(1),时间字段框消失;空间字段
stusps(3)→ 运行检查(4)→ 已完成自动重排(5)。
11.3 步骤 C:BSVC 建模
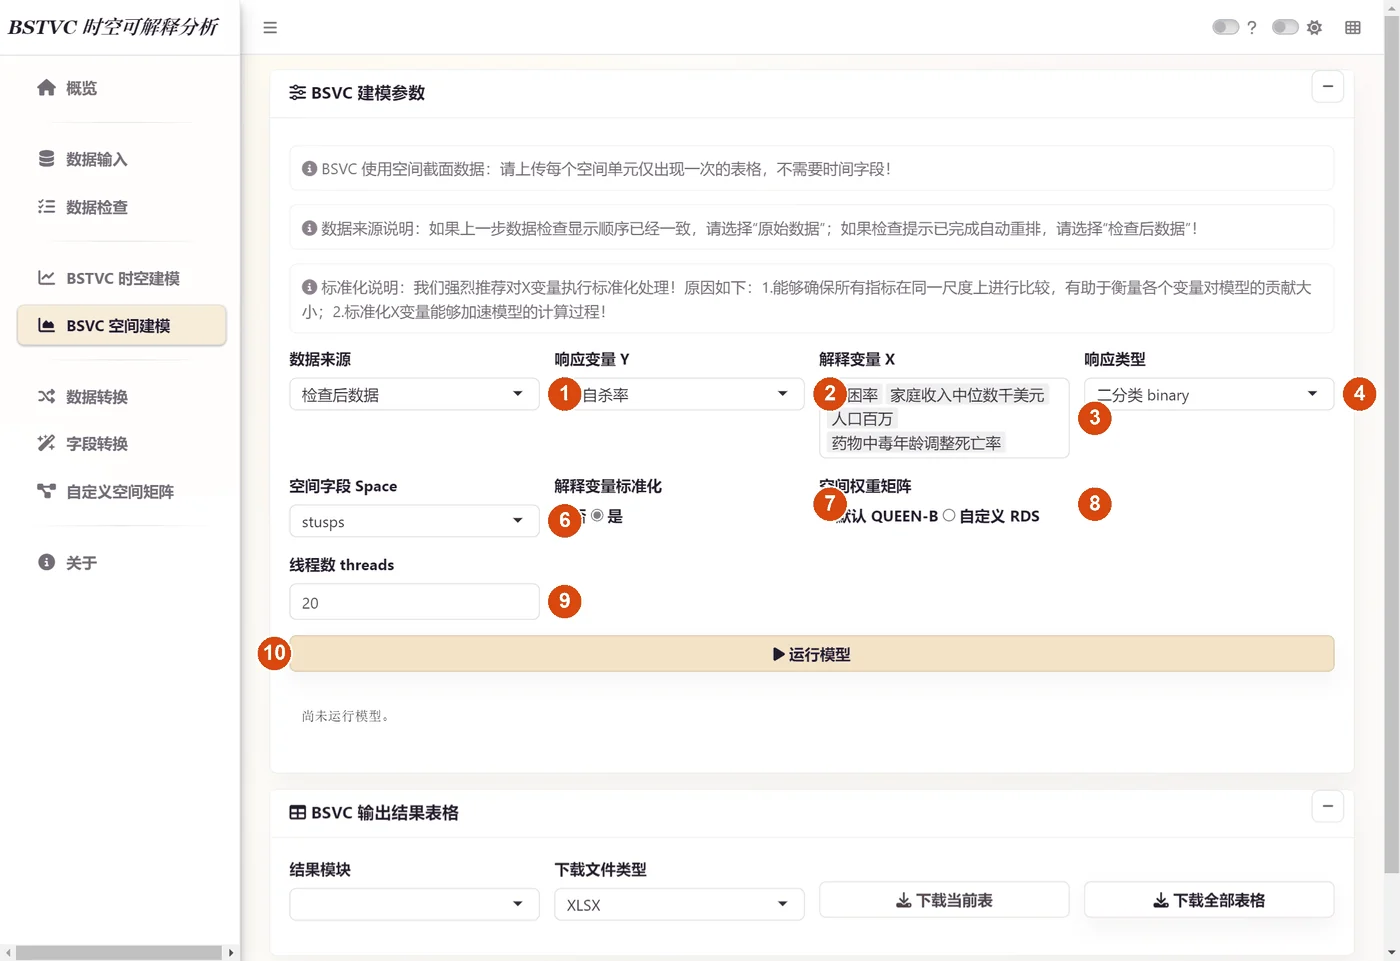
点左侧 BSVC 空间建模:检查后数据(1)· Y 高自杀率(2)· 四个 X(3)· 二分类(4)· 空间 stusps(6)· 标准化 = 是(7)· QUEEN-B(8)· 线程 20(9)→ 运行模型(10),< 15 秒 完成。
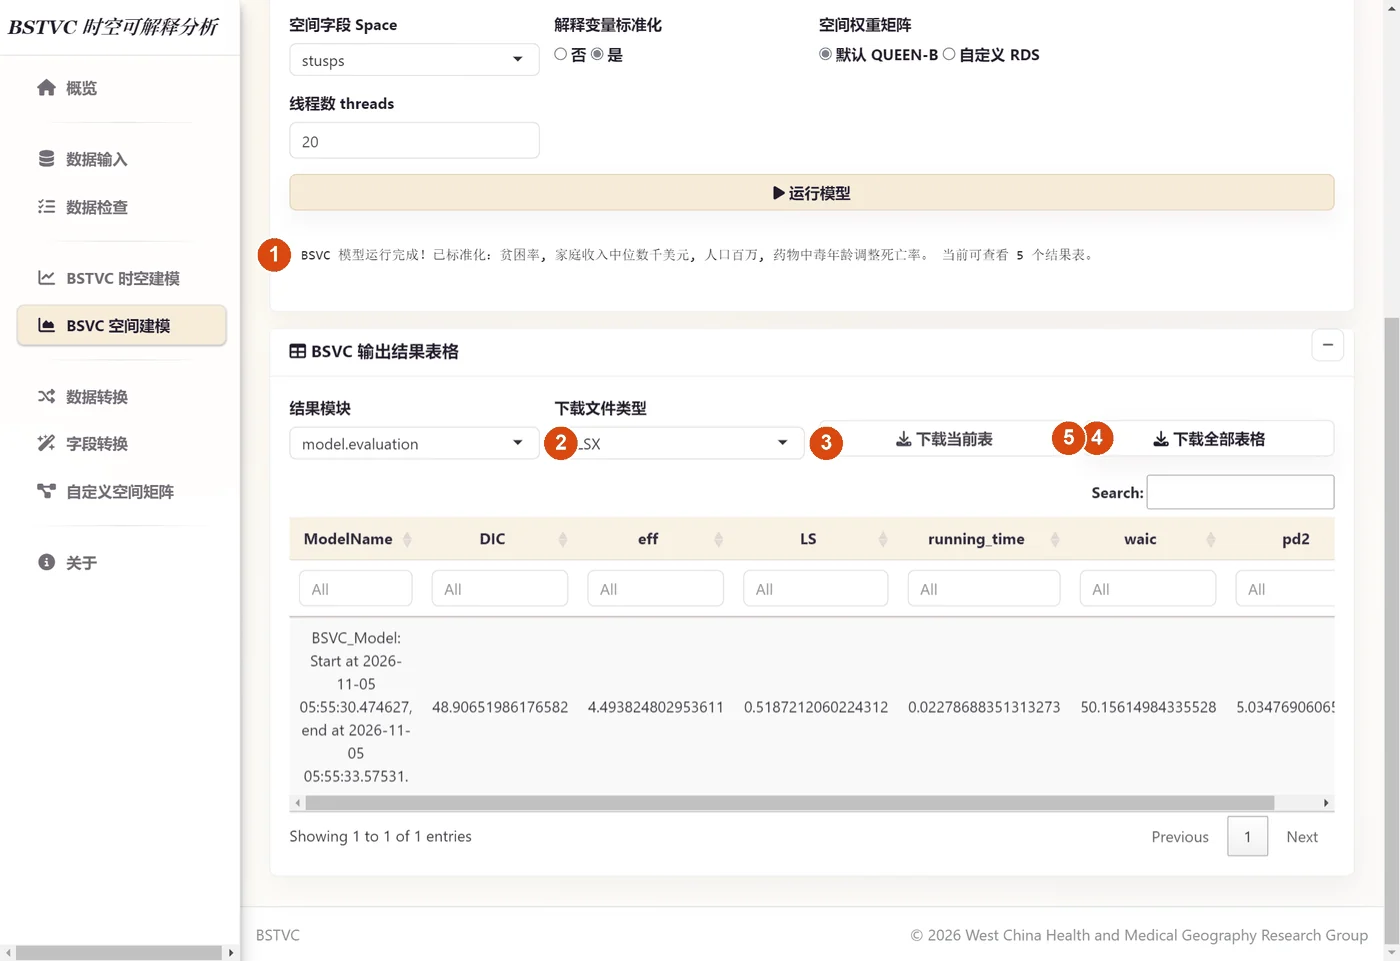
药物中毒年龄调整死亡率 22.7%、贫困率 21.0%、人口百万 18.5%、家庭收入中位数千美元 18.3%。11.4 结果解读
- BSVC 没有时间系数,这次 V2 更新不涉及它;本例 V1 与 V2 的结果几乎相同(DIC 相差 0.00)。
- 每个地区只有一个 0/1 观测,四个因子的 STVPI 区间都很宽(约 2–75%),不能据此给因子排名;AUC 说明模型能较好地区分高、低两组地区。
只有一年、每州一个“高或不高”的标签,模型能看出大致的地区差异,但说不准哪个因素最重要。
11.5 可视化与解读
结果工作簿可以直接画成论文图。代码和画好的图(中文、英文两套,300 dpi PNG + 矢量 PDF)都在 Case-05-BSVC-US-Suicide-2016\visualization\:把 R 的工作目录设为该案例文件夹,运行 source("visualization/Case5_BSVC_US_suicide_2016.R")。
本例的 R 代码(点开可复制)
# ==========================================================================================
#  怎么运行 / How to run
#  1. 安装一次 R 包 / install once:
#     install.packages(c("readxl","dplyr","tidyr","ggplot2","sf","patchwork","scales","RColorBrewer","classInt","ragg","systemfonts"))
#  2. 把工作目录设为本案例文件夹(纯英文路径)/ set the working directory to this case folder (ASCII path):
#     setwd("D:/BSTVC_data/Case-05-BSVC-US-Suicide-2016")
#  3. source("visualization/Case5_BSVC_US_suicide_2016.R")
#  图写到 visualization/outputs/<中文 zh | 英文 en>/;进阶模块的图在其中的 local_coef_module/。
#  换成你自己的结果:改下面 cfg 里的文件名、空间字段 key、结局类型和变量中英对照 var_en 即可。
# ==========================================================================================
# 案例 5:BSVC 空间模型,2016 年美国 49 个地区高自杀率状态(二分类,只有空间系数)
# Case 5: BSVC spatial model, high suicide-rate status in 49 US areas, 2016 (binary)
source("visualization/R/bstvc_plot_functions.R"); source("visualization/R/run_case.R")
source("visualization/R/bstvc_local_coef_functions.R"); source("visualization/R/run_local_coef.R")
cfg <- list(
  id = "Case5_BSVC_US_suicide_2016", title = "案例 5 BSVC 美国 2016", title_en = "Case 5 BSVC US 2016",
  xlsx = "reference_results_V2/Case5_BSVC_V2_all_result_tables.xlsx", shp = "us_states_contiguous.shp", outdir = "visualization/outputs", key = "stusps",
  data = "US_suicide_2016_cross_section_zh.csv",
  type = "binary", model = "bsvc", standardized = TRUE, label_field = "name",
  pred_label = "预测概率", pred_label_en = "Fitted probability",
  var_en = c("贫困率" = "Poverty rate", "家庭收入中位数千美元" = "Median household income", "人口百万" = "Population",
             "药物中毒年龄调整死亡率" = "Drug overdose mortality"))

for (lang in c("zh", "en")) {
  run_case(modifyList(cfg, list(lang = lang)))          # 核心图 / core figures
  run_local_coef(modifyList(cfg, list(lang = lang)))    # 进阶模块(可选)/ optional SHAP-style module
}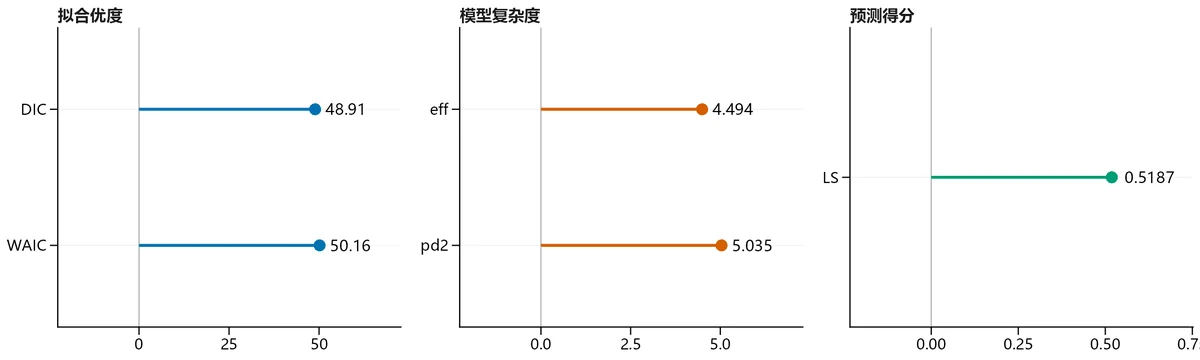
- 三组数字:拟合优度(DIC、WAIC)、模型复杂度(eff、pd2)、预测得分(LS)。
- DIC、WAIC、LS 越小越好,只在同一份数据、同一个 Y 的几个模型之间比较;DIC 和 WAIC 是两种算法,数值不同属正常。
- DIC 48.9,WAIC 50.2,LS 0.519;eff 4.5,pd2 5.0。
- 拟合值与观测值的一致程度:AUC = 0.898。
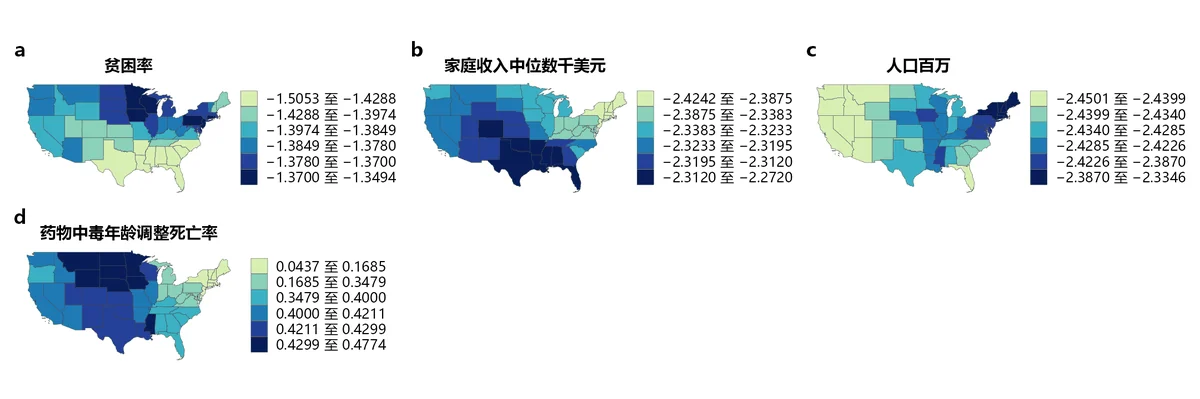
- 每幅地图一个因素,颜色 = 这个地区的空间系数:红 = 推高结局,蓝 = 拉低结局,颜色越深作用越强。
- 每幅地图各自分级,比较大小要看图例上的数值。
- 空间系数 = 这个地区在整个研究时期的平均作用;某地某时的完整作用 = 空间系数 + 该时点的时间系数。
- 药物中毒年龄调整死亡率:从 0.04(Rhode Island)到 0.48(Nebraska)。
- 贫困率:从 −1.51(Louisiana)到 −1.35(Minnesota)。
- 家庭收入中位数千美元:从 −2.42(Rhode Island)到 −2.27(Louisiana)。
- 人口百万:从 −2.45(Oregon)到 −2.33(Rhode Island)。
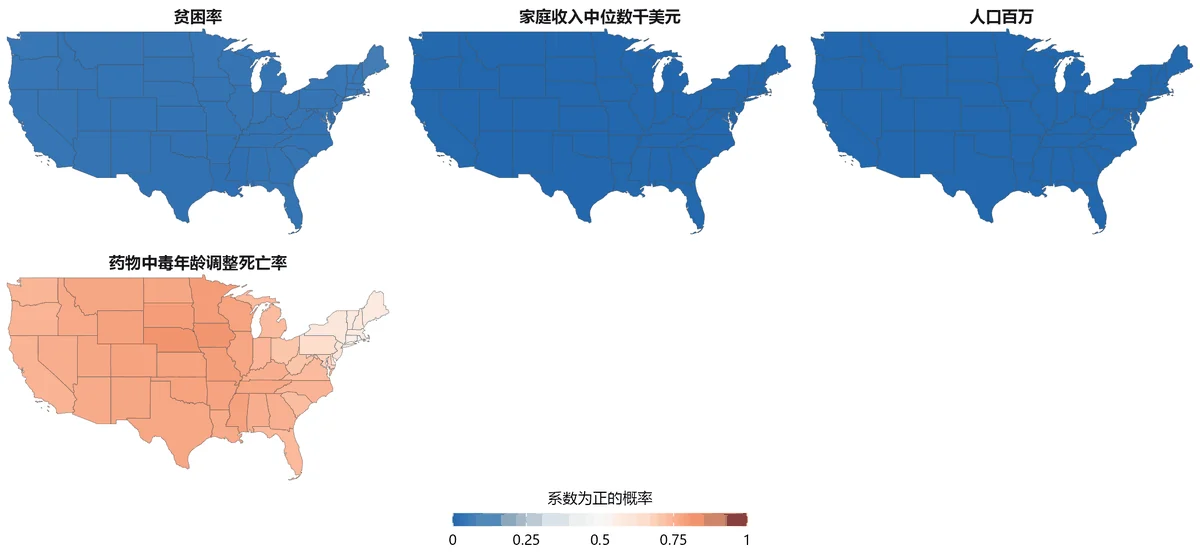
- 颜色 = 这个地区“作用为正”的概率,0 到 1 连续变化:越红越有把握“推高”,越蓝越有把握“拉低”,接近白色 = 方向还说不准。
- 和图 3 搭配看:图 3 看“作用多大”,图 3b 看“方向有几成把握”。
- 贫困率:0% 的地区“作用为正”的把握在八成以上,100% 的地区“作用为负”的把握在八成以上。
- 家庭收入中位数千美元:0% 的地区“作用为正”的把握在八成以上,100% 的地区“作用为负”的把握在八成以上。
- 人口百万:0% 的地区“作用为正”的把握在八成以上,100% 的地区“作用为负”的把握在八成以上。
- 药物中毒年龄调整死亡率:4% 的地区“作用为正”的把握在八成以上,0% 的地区“作用为负”的把握在八成以上。
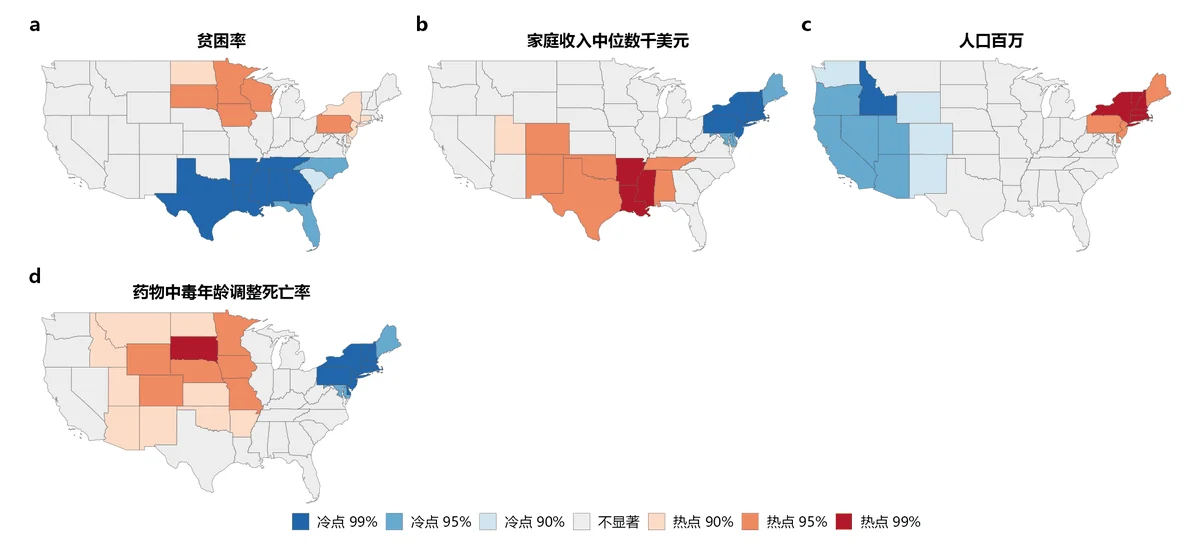
- 找出空间系数“成片偏高”(热点,红色)和“成片偏低”(冷点,蓝色)的区域;灰色 = 没有成片。
- 用来回答:作用特别强(或特别弱)的地区是不是连在一起,适合划定重点区域。
- 贫困率:热点 5 个(如 Minnesota、Iowa、Wisconsin),冷点 9 个(如 Mississippi、Louisiana、Arkansas)。
- 家庭收入中位数千美元:热点 9 个(如 Arkansas、Louisiana、Mississippi),冷点 11 个(如 Massachusetts、New York、Connecticut)。
- 人口百万:热点 10 个(如 Massachusetts、Connecticut、Rhode Island),冷点 6 个(如 Idaho、Nevada、Oregon)。
- 药物中毒年龄调整死亡率:热点 7 个(如 South Dakota、Iowa、Nebraska),冷点 11 个(如 Massachusetts、New York、Connecticut)。
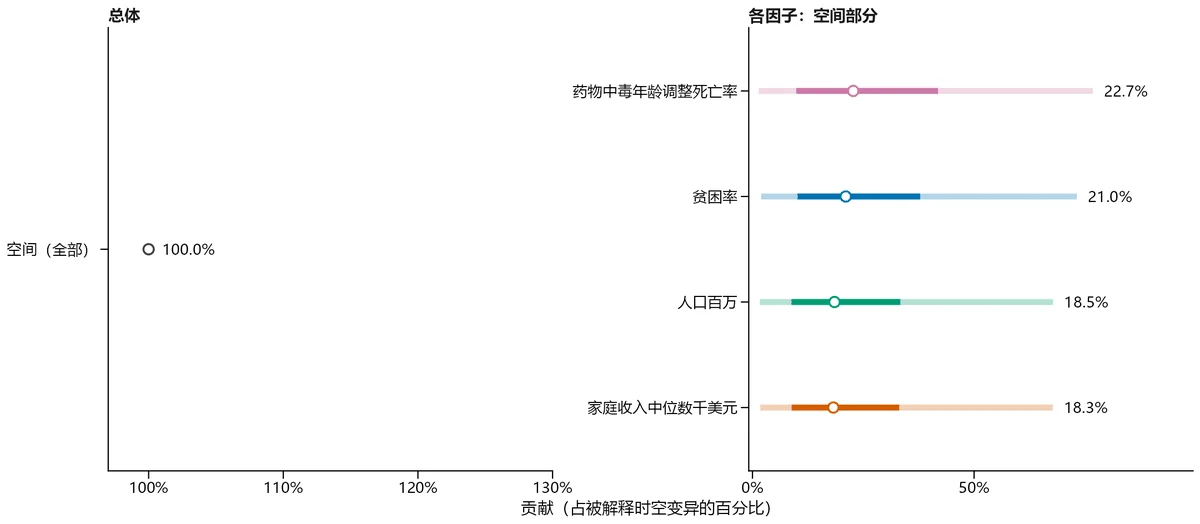
- 左上“总体”:结局的时空差异里,空间部分、时间部分各占多少。
- 其余面板:每个因素的贡献(时空合计、空间部分、时间部分);圆圈 = 估计值,粗、细条 = 50%、95% 可信区间。
- 只有解释变量标准化后,不同因素的百分比才能互相比较。
- 各因素(空间 + 时间合计):
药物中毒年龄调整死亡率22.7%、贫困率21.0%、人口百万18.5%、家庭收入中位数千美元18.3%。 - 区间重叠很多的因素,排名不要说得太死。
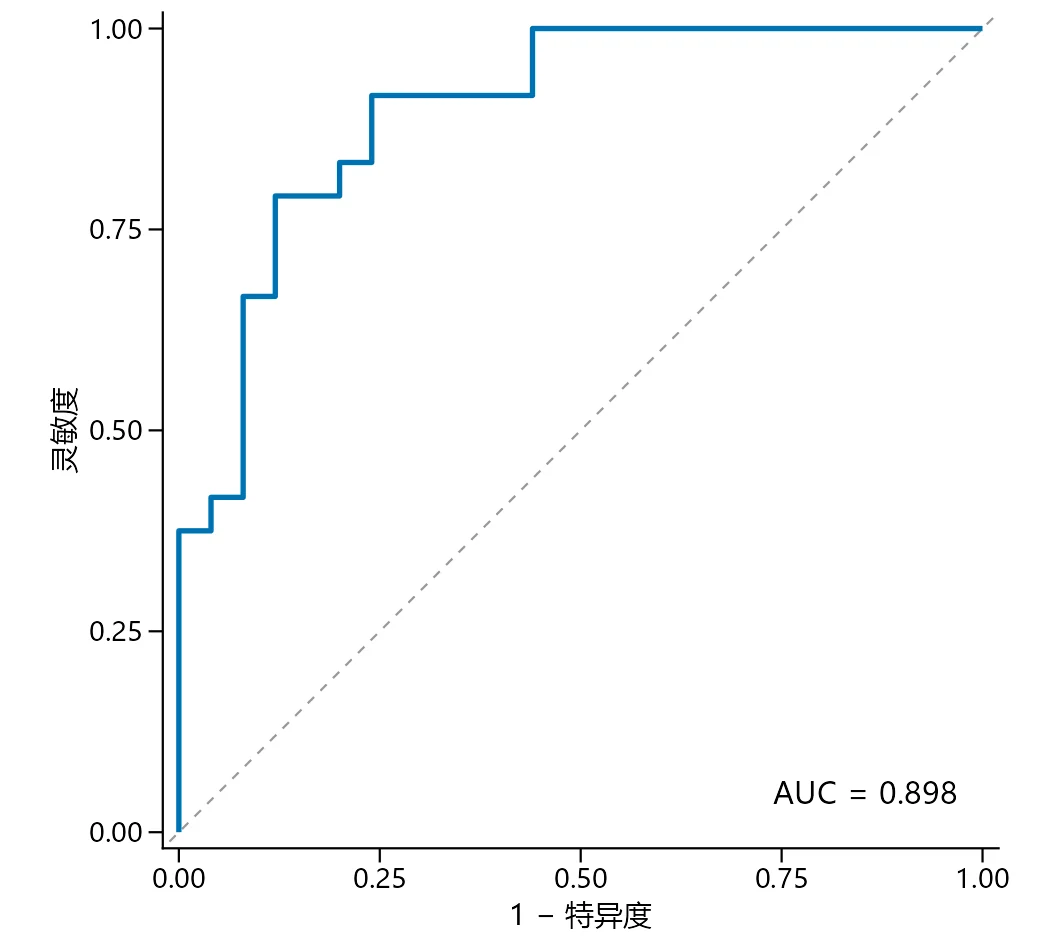
- ROC 曲线越靠近左上角越好;AUC 0.5 = 瞎猜,1 = 完全分得开。
- 这是在同一份数据上的拟合,不等于对新数据的预测能力。
- AUC = 0.898(49 个观测)。
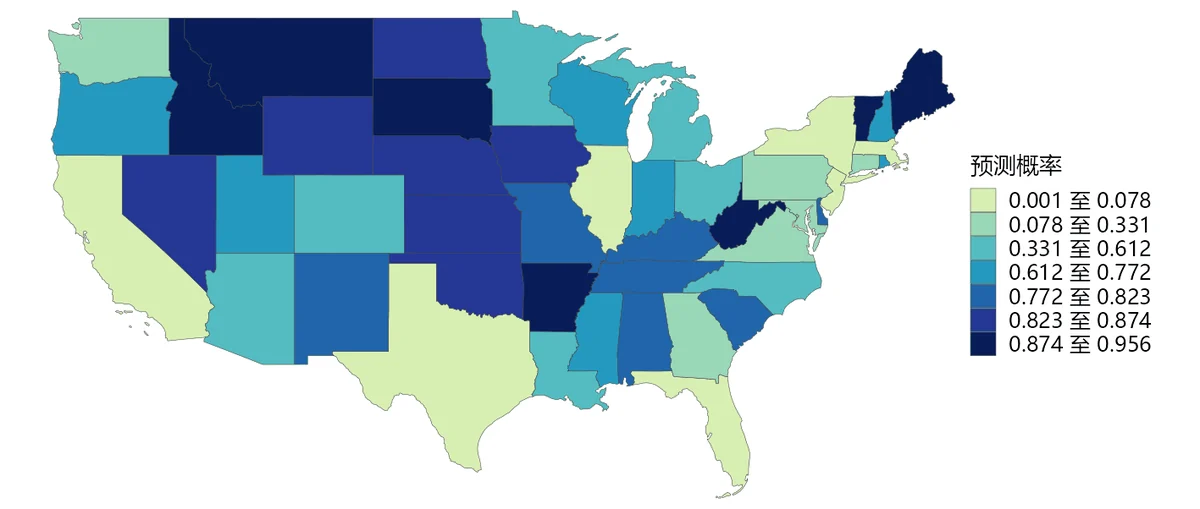
- 颜色 = 每个地区的拟合概率。
- 只有一年,只看空间格局。
想更深入地挖掘各地区的局部系数?本案例的全套类 SHAP 进阶图见第 14 章对应小节。
12 案例 6 · 最大的案例:全球 177 个国家和地区健康调整预期寿命(12 个 X)
12.1 案例卡:数据、来源与变量
| 项目 | 内容 |
|---|---|
| 文件夹 | Case-06-Continuous-Global-HALE(官方示例数据;只保留官方手册有明确含义的变量,变量名为中文) |
| 表格 | HALE_global_panel_zh.csv:177 × 21 = 3,717 行,15 列,长表 |
| 地图 | TestMap_Continuous.*(5 个文件,空间 ID ISO_A3) |
| 来源 | 全球疾病负担研究 GBD、世界银行、GIOVANNI、全球空气质量数据(官方中文手册表 4.1) |
| Y | 健康调整预期寿命(岁),缺失 7.3% |
| X(12 个) | 官方原文件中除孕产妇死亡率、PM25年均浓度外,其余 10 个 X 已是标准化值(z 分数),原始单位未提供。孕产妇死亡率、高酒精使用、高体质指数、维生素A缺乏、女性就业人口比、城市人口比例、人均国民收入、卫生支出占GDP比重、每千人医师数、高温暴露、归一化植被指数、PM25年均浓度(女性就业人口比缺 45%、每千人医师数缺 44%) |
| 设置 | 连续型 · 检查后数据 · 标准化 = 是 · QUEEN-B · 线程 20 |
12.2 步骤 A:数据输入
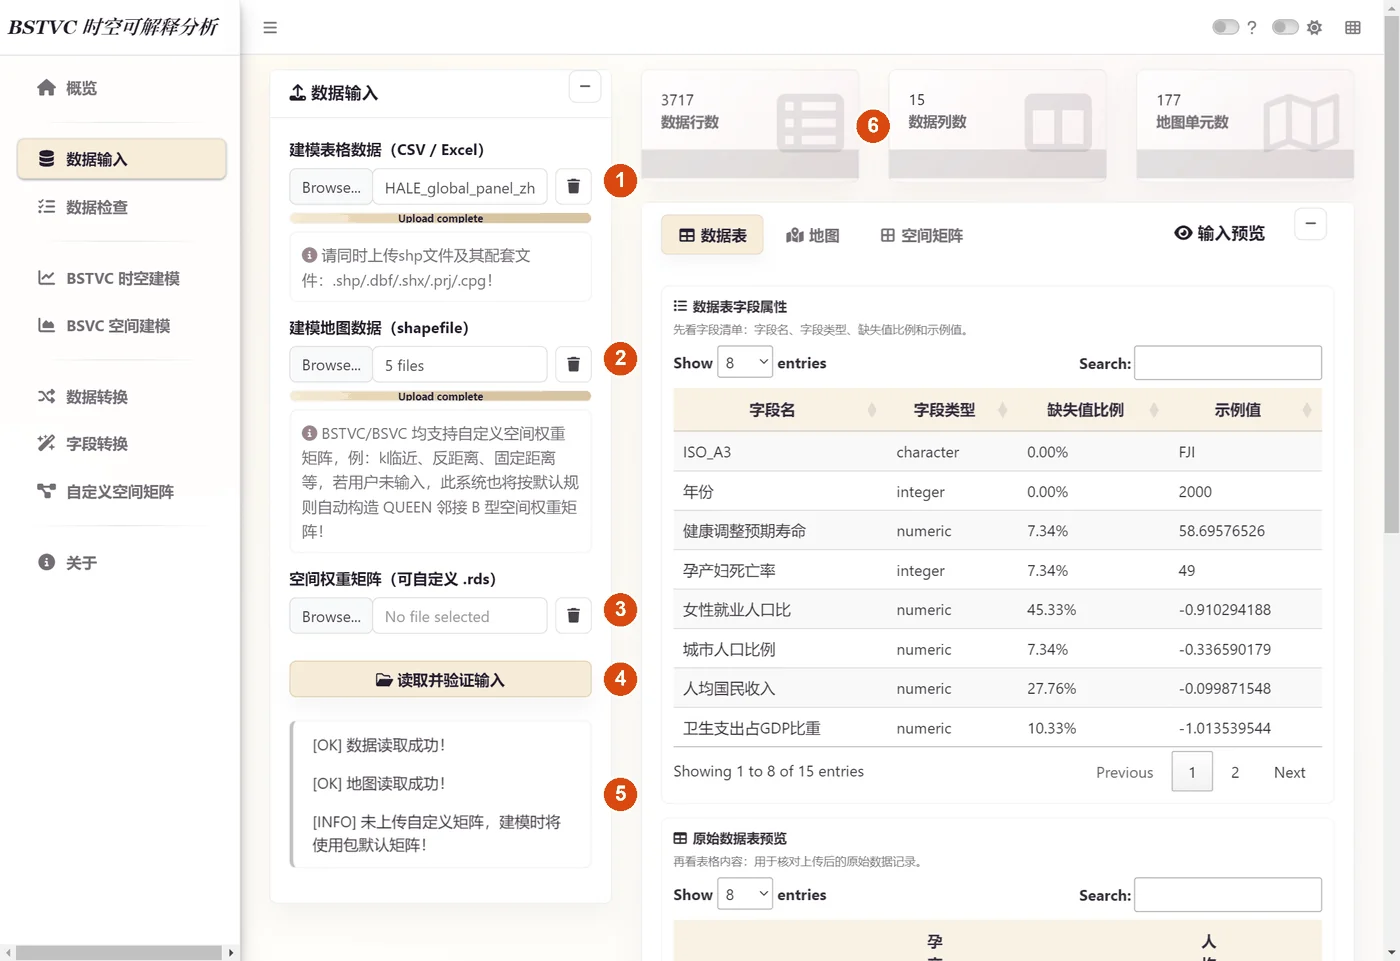
- Browse… 时可以在 Windows 文件对话框的“文件名”框里直接粘贴完整路径,回车(1)。
- 地图选
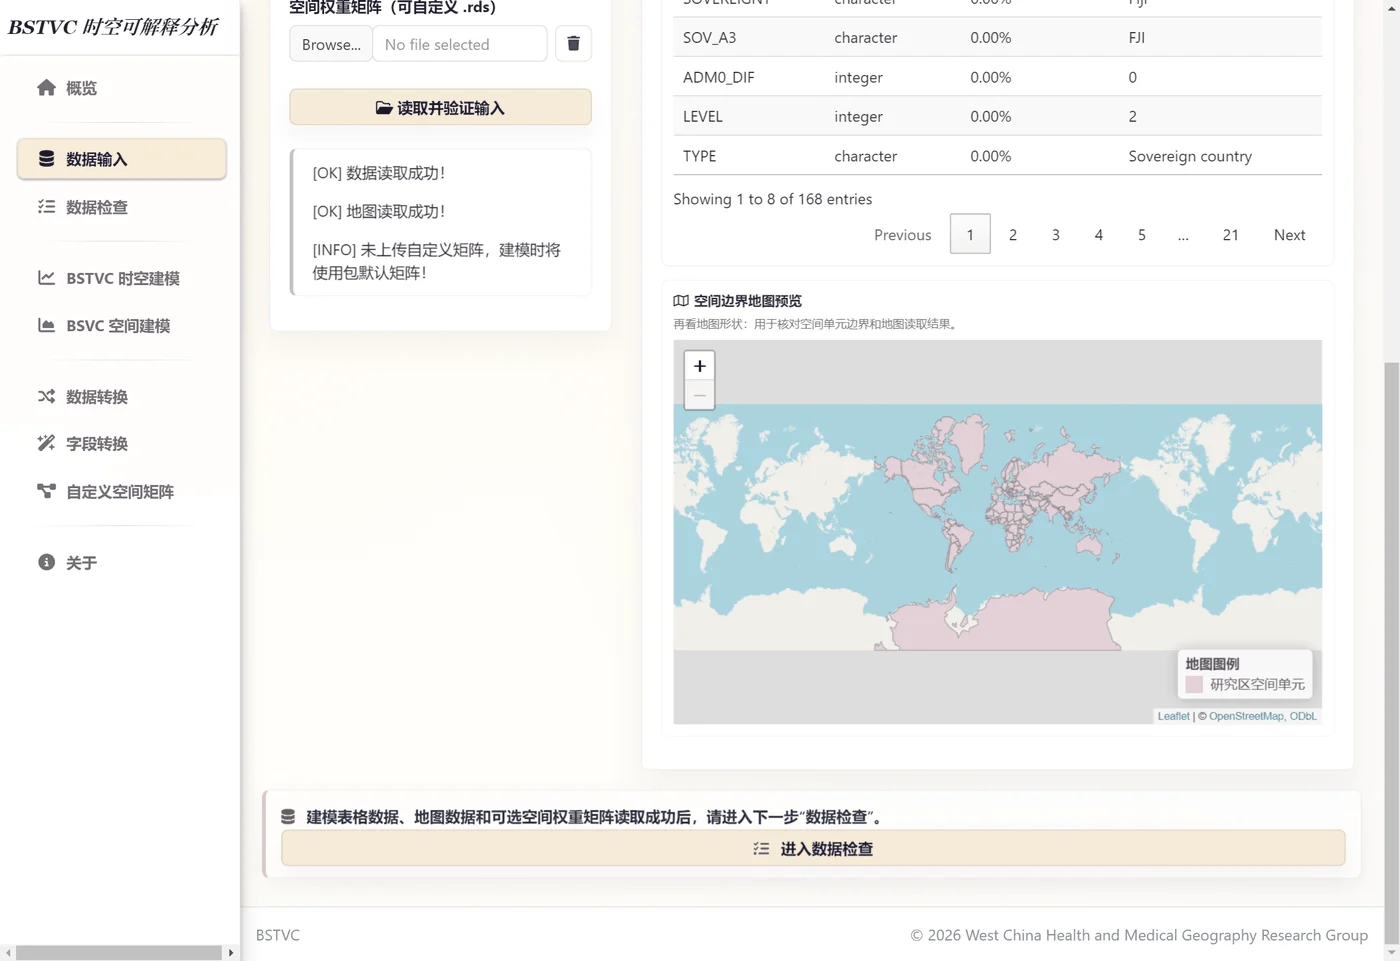
TestMap_Continuous的全部 5 个文件(2),框里显示“5 files”。 - 读取并验证输入(4)→ 核对 3717 行、15 列、177 个地图单元(6)。在“数据表”标签里能看到各字段缺失比例。
12.3 步骤 B:数据检查
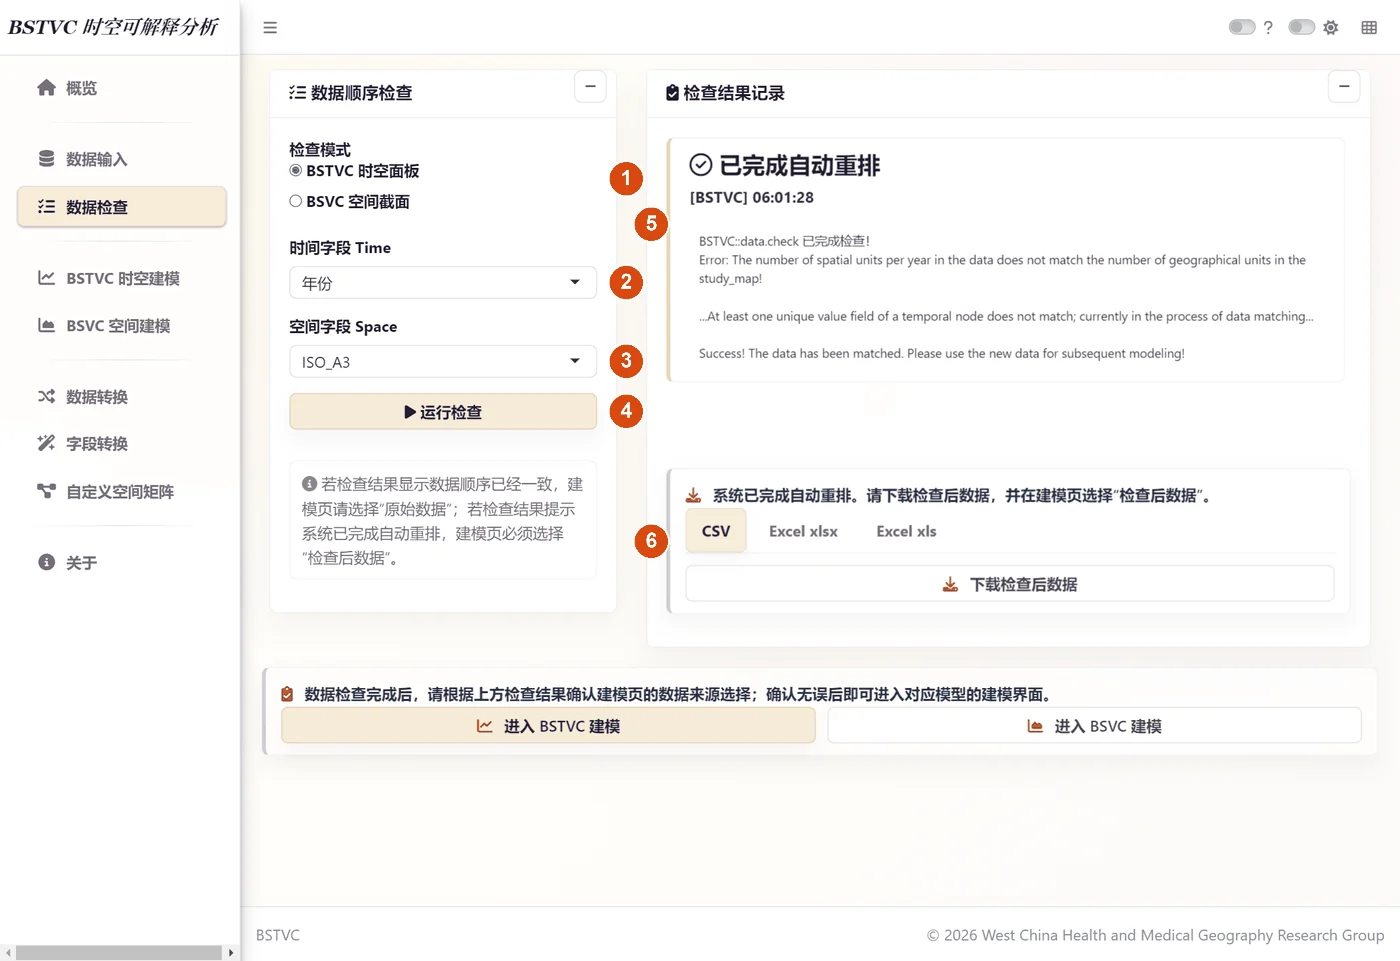
时间 年份、空间 ISO_A3 → 运行检查 → 已完成自动重排。
12.4 步骤 C:建模——这是最耗资源的一步
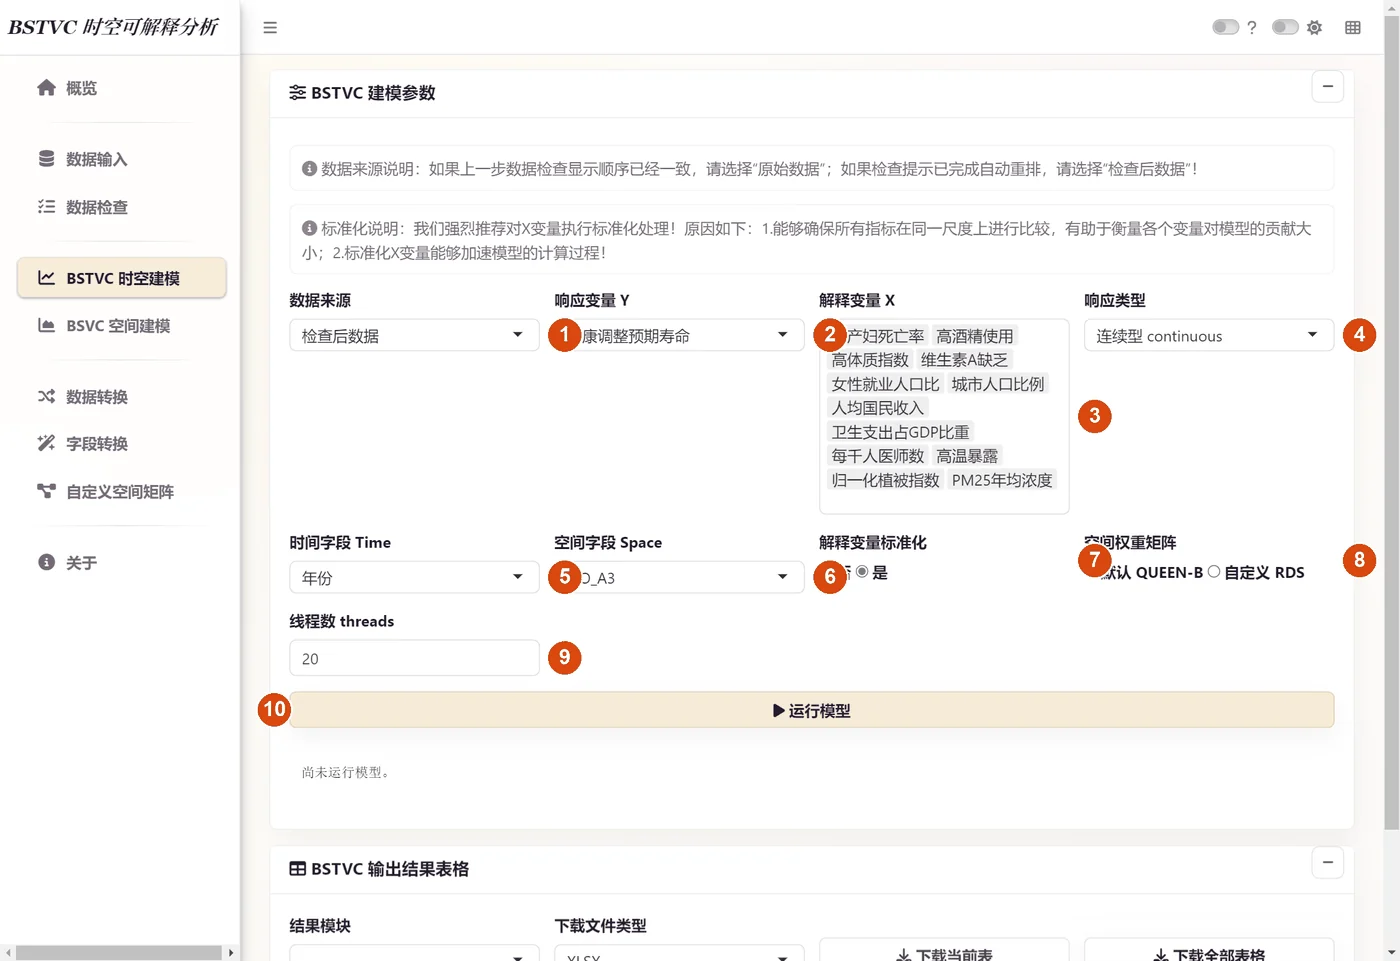
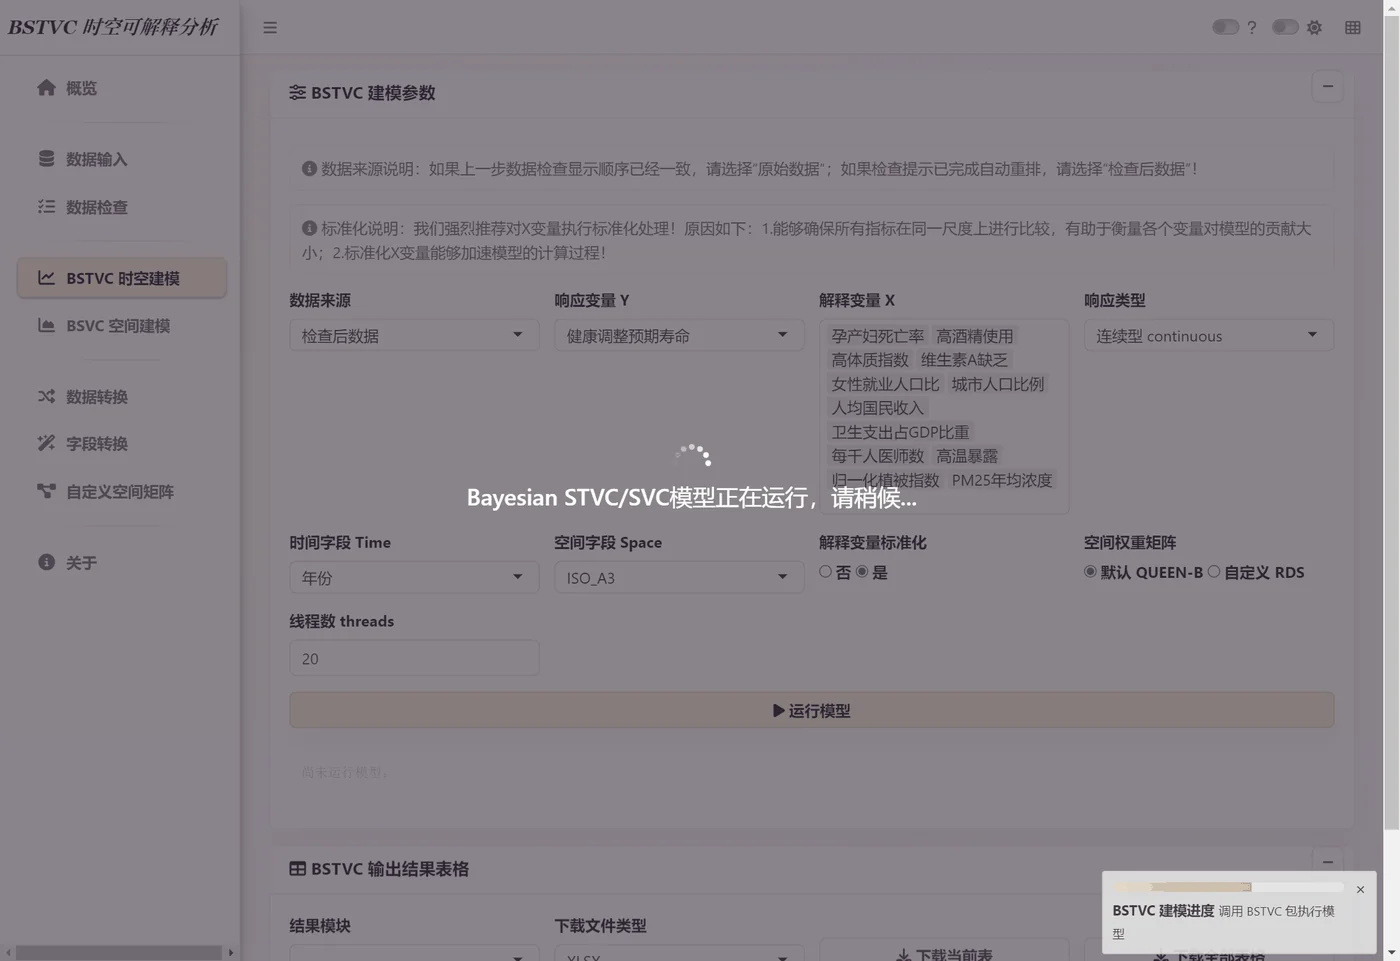
- 检查后数据;Y
健康调整预期寿命;X:在框里逐个输入 12 个变量名并回车(3)。打字搜索比在长列表里滚动快,也不容易选错。 - 连续型;时间
年份;空间ISO_A3;标准化 = 是;QUEEN-B。 - 线程数 20(9)。默认 6 会慢很多;超过约 20 不再加速。
- 运行模型。本例 ≈ 17 分钟;期间页面一直是灰的,右下角有进度提示。
12.5 步骤 D:结果与下载
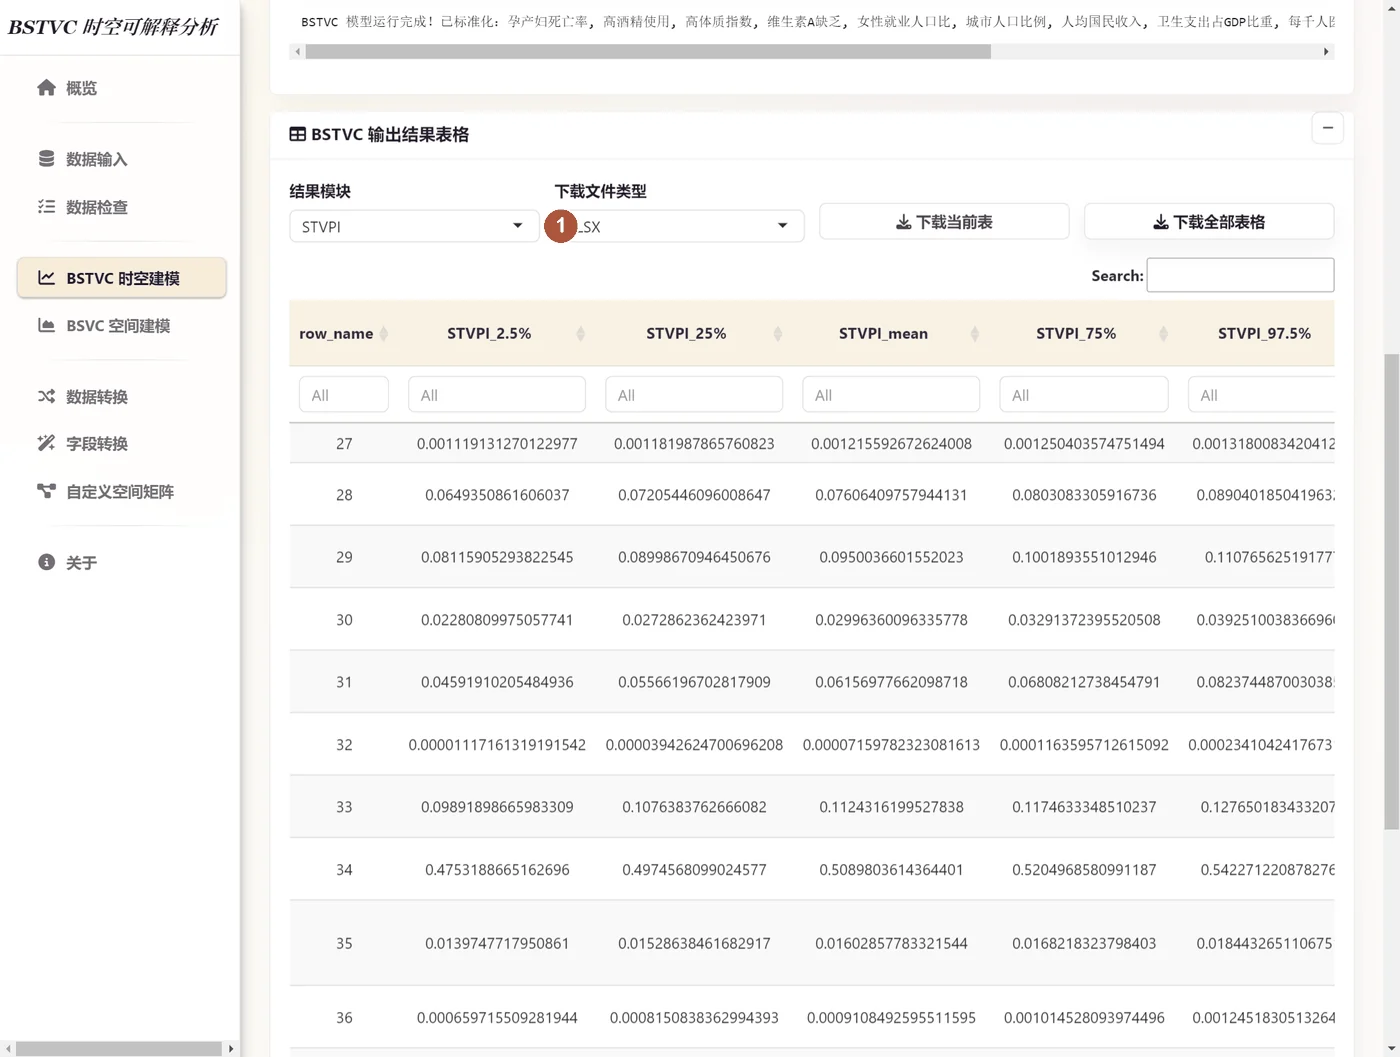
人均国民收入 51.0%、城市人口比例 11.3%、高酒精使用 9.5%、高温暴露 8.7%、孕产妇死亡率 7.7%、维生素A缺乏 6.2%、高体质指数 3.0%、卫生支出占GDP比重 1.6%、PM25年均浓度 0.3%、每千人医师数 0.1%、归一化植被指数 0.1%、女性就业人口比 0.0%。- 一句话
- 把模型解释的“时空变异”按因子、按“空间部分 / 时间部分”分成百分比,看谁贡献最大。
- 打个比方
- 一个班成绩的高低差异,有多少来自“学校不同”(空间)、多少来自“学期不同”(时间),又各由哪门课贡献。
- 为什么要用
- 系数告诉你“作用多大”,STVPI 告诉你“这个因素在整体格局里占多重”,用来识别关键驱动因素。
- 怎么用
- 看
space.time.X(因子合计)排序;再看它主要来自space.X还是time.X。二分类和计数模型没有残差项,百分比只在协变量之间分配。 - 讲给别人听
- “STVPI 说的是‘谁是主角’,以及它主要是在地区之间起作用,还是在时间上起作用。”
12.6 结果解读
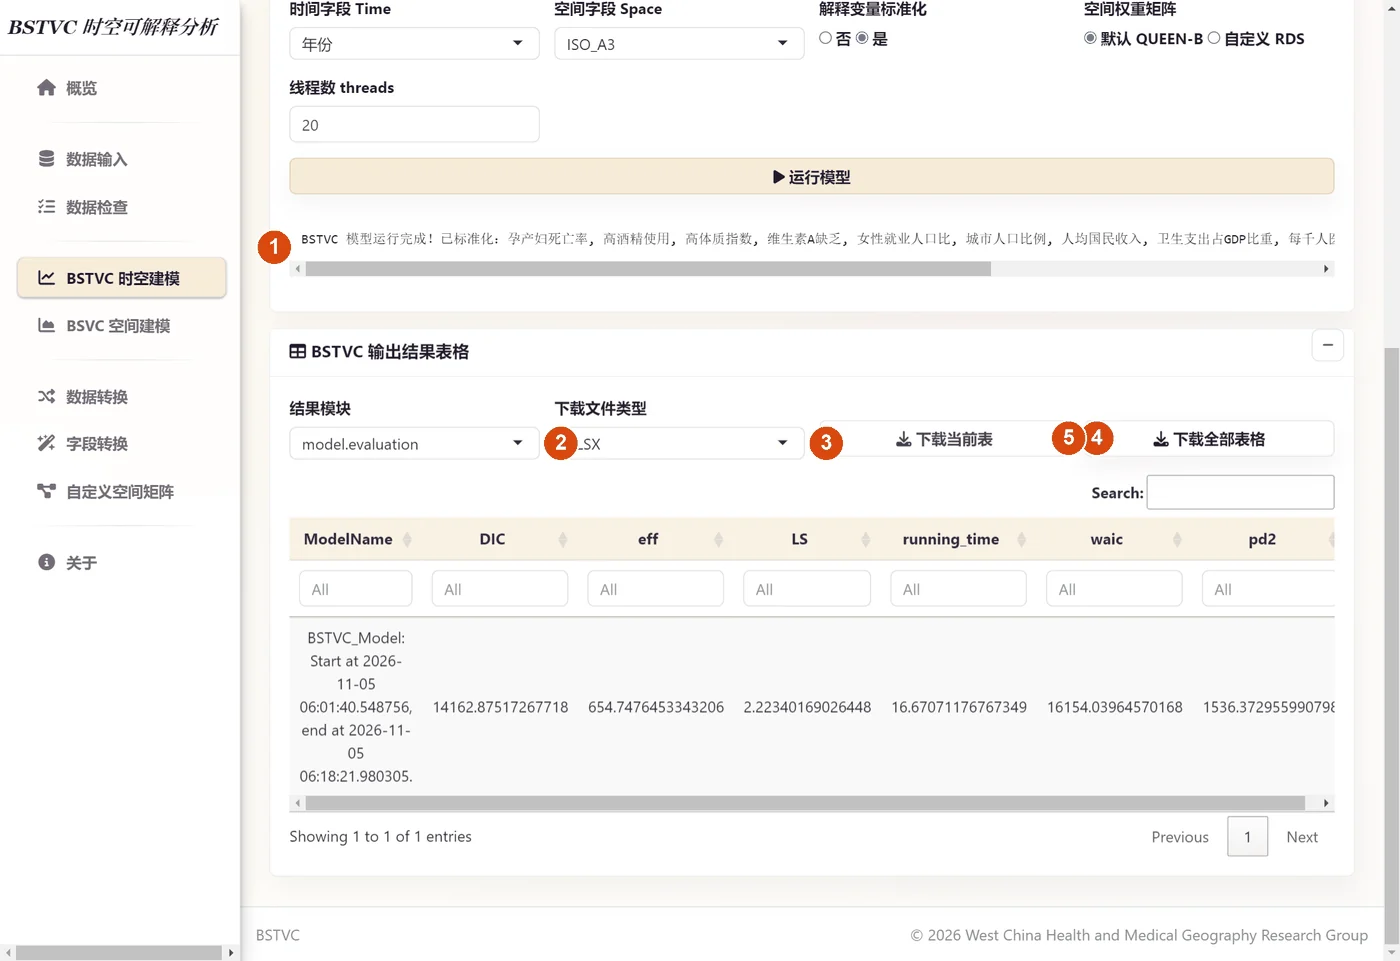
- 评价:DIC 14,163、WAIC 16,154(两种算法,数值不同属正常),R² = 0.967。
- 谁更重要:人均国民收入 的贡献最大;空间部分占 99.4%:因素的作用主要体现在国家之间,21 年里变化很小。
- 岛国:地图上有很多没有邻居的岛国和小连通块,它们借不到邻居的信息,解读时单独说明。
各国健康寿命的差别,主要来自国与国之间的差别;在这个模型里,收入、城市化等因素的作用在各国差异很大,但 20 年间变化不大。
12.7 为什么要用 12 个变量:少变量试跑与正式运行
| 运行 | X 个数 | 用时 | DIC | R² |
|---|---|---|---|---|
| 少变量试跑 | 6(孕产妇死亡率、归一化植被指数、高体质指数、维生素A缺乏、PM25年均浓度、城市人口比例) | ≈ 54 秒 | 22,284 | 0.575 |
| 正式运行 | 12 | ≈ 17 分钟 | 14,163 | 0.967 |
变量太少时,模型解释不了各国的水平差异,R² 明显偏低。经验法则:先用少量 X 快速确认流程能跑通,正式运行用全部有研究意义的 X、线程 20。R² 是同一数据上的拟合,不等于对新数据的预测能力。
- 一句话
- R² = 1 − 误差平方和 / 总平方和:模型比“直接用平均值猜”好多少。
- 打个比方
- 猜全班身高,什么都不知道就猜平均身高;R² 衡量你的方法比这个“傻办法”好多少。比傻办法还差,R² 就是负的。
- 为什么要用
- 直观地检查预测值和观测值吻不吻合。
- 怎么用
- 在有观测的单元上,用
local.prediction的predict_y对y计算;出图脚本的图 7 自动画出。 - 讲给别人听
- “R² 0.97 表示模型复现了 97% 的差异;但这是对已有数据的拟合,不是对未来的预测。”
12.8 可视化与解读
结果工作簿可以直接画成论文图。代码和画好的图(中文、英文两套,300 dpi PNG + 矢量 PDF)都在 Case-06-Continuous-Global-HALE\visualization\:把 R 的工作目录设为该案例文件夹,运行 source("visualization/Case6_HALE_global.R")。
本例的 R 代码(点开可复制)
# ==========================================================================================
#  怎么运行 / How to run
#  1. 安装一次 R 包 / install once:
#     install.packages(c("readxl","dplyr","tidyr","ggplot2","sf","patchwork","scales","RColorBrewer","classInt","ragg","systemfonts"))
#  2. 把工作目录设为本案例文件夹(纯英文路径)/ set the working directory to this case folder (ASCII path):
#     setwd("D:/BSTVC_data/Case-06-Continuous-Global-HALE")
#  3. source("visualization/Case6_HALE_global.R")
#  图写到 visualization/outputs/<中文 zh | 英文 en>/;进阶模块的图在其中的 local_coef_module/。
#  换成你自己的结果:改下面 cfg 里的文件名、空间字段 key、结局类型和变量中英对照 var_en 即可。
# ==========================================================================================
# 案例 6:177 个国家 2000–2020 年健康调整预期寿命(连续型,12 个解释变量)
# Case 6: healthy life expectancy in 177 countries, 2000-2020 (continuous, 12 covariates)
source("visualization/R/bstvc_plot_functions.R"); source("visualization/R/run_case.R")
source("visualization/R/bstvc_local_coef_functions.R"); source("visualization/R/run_local_coef.R")
cfg <- list(
  id = "Case6_HALE_global", title = "案例 6 全球健康调整预期寿命", title_en = "Case 6 global HALE",
  xlsx = "reference_results_V2/Case6_HALE_12X_V2_all_result_tables.xlsx", shp = "TestMap_Continuous.shp", outdir = "visualization/outputs", key = "ISO_A3", drop = "ATA",
  data = "HALE_global_panel_zh.csv",
  type = "continuous", standardized = TRUE,
  t0 = 2000, tlab = "年份", tlab_en = "Year", time_col = "年份", pred_times = c(2000, 2010, 2020),
  pred_label = "健康调整预期寿命(岁)", pred_label_en = "HALE (years)",
  var_en = c("孕产妇死亡率" = "Maternal mortality", "高酒精使用" = "High alcohol use", "高体质指数" = "High BMI",
             "维生素A缺乏" = "Vitamin A deficiency", "女性就业人口比" = "Female employment", "城市人口比例" = "Urban population",
             "人均国民收入" = "GNI per capita", "卫生支出占GDP比重" = "Health expenditure", "每千人医师数" = "Physicians per 1,000",
             "高温暴露" = "Heat exposure", "归一化植被指数" = "NDVI", "PM25年均浓度" = "PM2.5"))

for (lang in c("zh", "en")) {
  run_case(modifyList(cfg, list(lang = lang)))          # 核心图 / core figures
  run_local_coef(modifyList(cfg, list(lang = lang)))    # 进阶模块(可选)/ optional SHAP-style module
}
- 三组数字:拟合优度(DIC、WAIC)、模型复杂度(eff、pd2)、预测得分(LS)。
- DIC、WAIC、LS 越小越好,只在同一份数据、同一个 Y 的几个模型之间比较;DIC 和 WAIC 是两种算法,数值不同属正常。
- DIC 14,162.9,WAIC 16,154.0,LS 2.223;eff 654.7,pd2 1,536.4。
- 拟合值与观测值的一致程度:R² = 0.967。
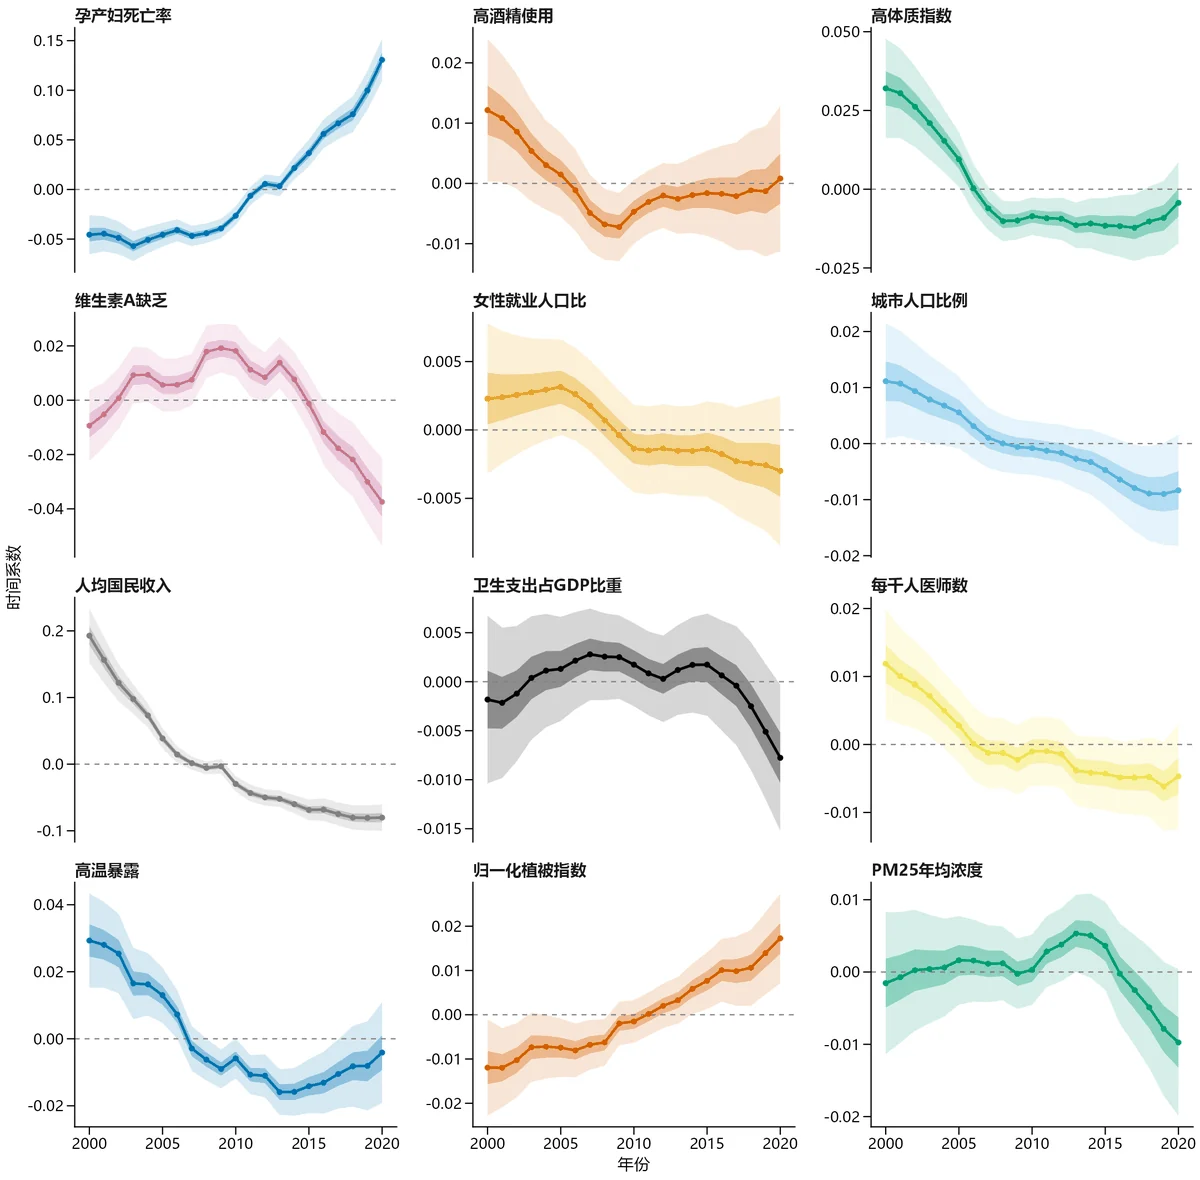
- 每个小图一个因素;横轴是时间,0 线 = 整个研究时期的平均水平。
- 曲线在 0 以上:这个时点作用比平时更强(更正向);在 0 以下:更弱(更负向)。
- 深色带 = 50%、浅色带 = 95% 可信区间:带子越窄,越有把握。各小图纵轴刻度不同。
- 人均国民收入:从 0.193 到 −0.080,总体下降;最强在 2000 年,最弱在 2019 年。
- 孕产妇死亡率:从 −0.046 到 0.131,总体上升;最强在 2020 年,最弱在 2003 年。
- 维生素A缺乏:从 −0.009 到 −0.037,总体下降;最强在 2009 年,最弱在 2020 年。
- 高温暴露:从 0.029 到 −0.004,总体下降;最强在 2000 年,最弱在 2013 年。
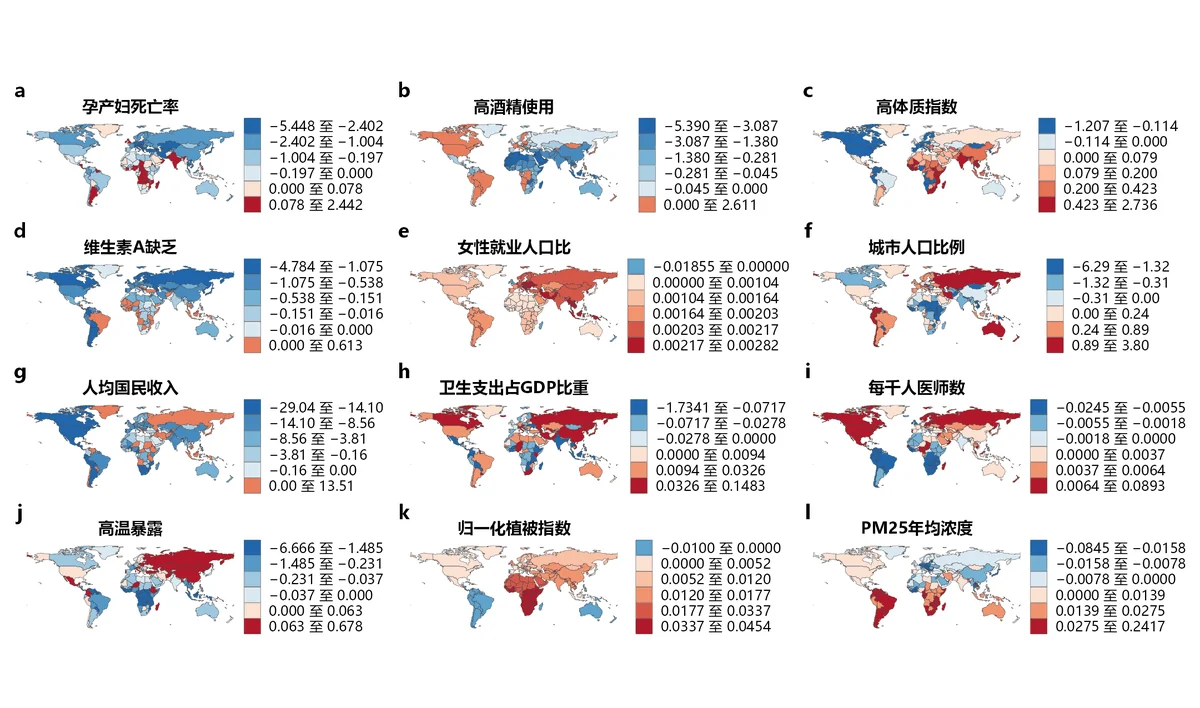
- 每幅地图一个因素,颜色 = 这个地区的空间系数:红 = 推高结局,蓝 = 拉低结局,颜色越深作用越强。
- 每幅地图各自分级,比较大小要看图例上的数值。
- 空间系数 = 这个地区在整个研究时期的平均作用;某地某时的完整作用 = 空间系数 + 该时点的时间系数。
- 人均国民收入:从 −29.04(eSwatini)到 13.51(United Republic of Tanzania)。
- 城市人口比例:从 −6.29(Ivory Coast)到 3.80(Gambia)。
- 高酒精使用:从 −5.39(Lesotho)到 2.61(Mongolia)。
- 孕产妇死亡率:从 −5.45(Montenegro)到 2.44(Gambia)。
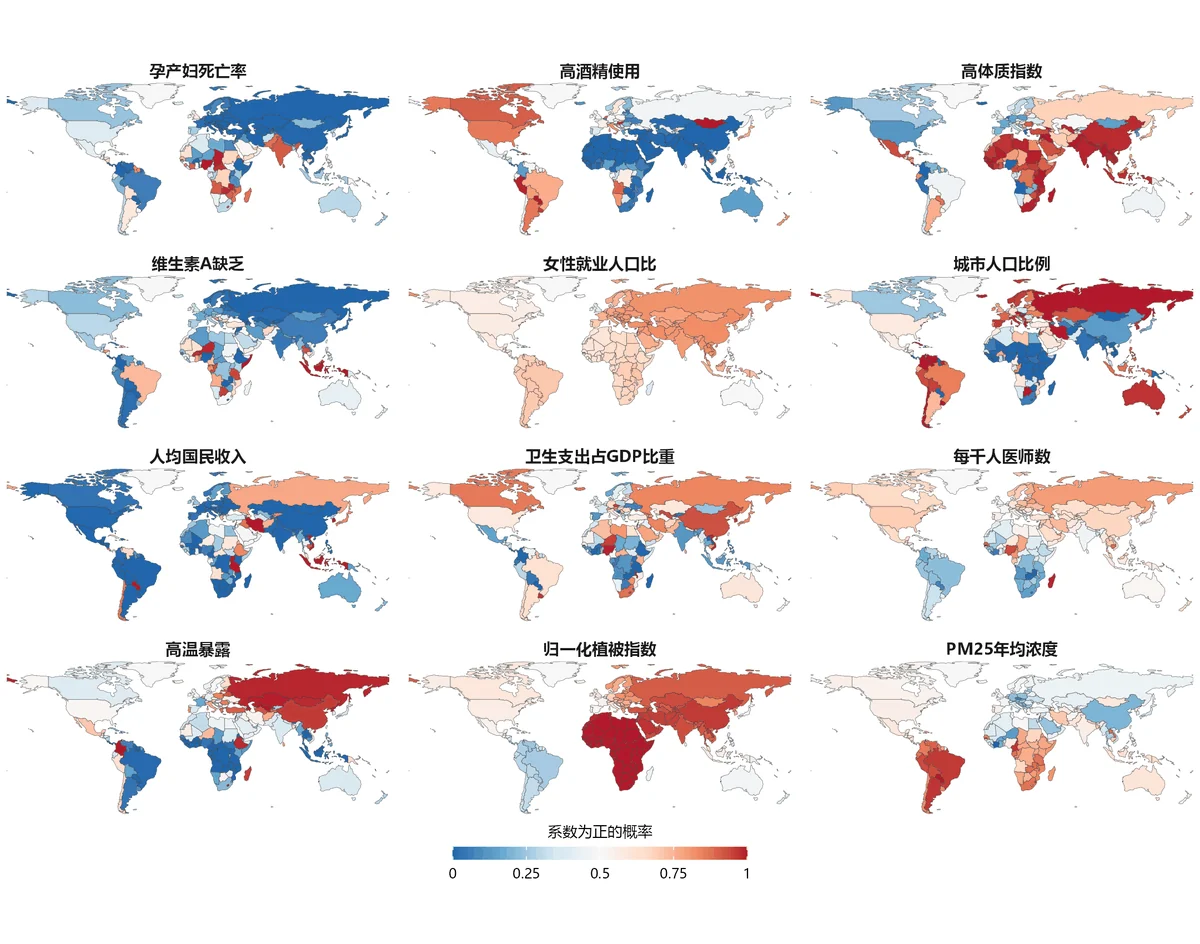
- 颜色 = 这个地区“作用为正”的概率,0 到 1 连续变化:越红越有把握“推高”,越蓝越有把握“拉低”,接近白色 = 方向还说不准。
- 和图 3 搭配看:图 3 看“作用多大”,图 3b 看“方向有几成把握”。
- 高酒精使用:10% 的地区“作用为正”的把握在八成以上,51% 的地区“作用为负”的把握在八成以上。
- 城市人口比例:28% 的地区“作用为正”的把握在八成以上,32% 的地区“作用为负”的把握在八成以上。
- 人均国民收入:8% 的地区“作用为正”的把握在八成以上,51% 的地区“作用为负”的把握在八成以上。
- 孕产妇死亡率:11% 的地区“作用为正”的把握在八成以上,44% 的地区“作用为负”的把握在八成以上。
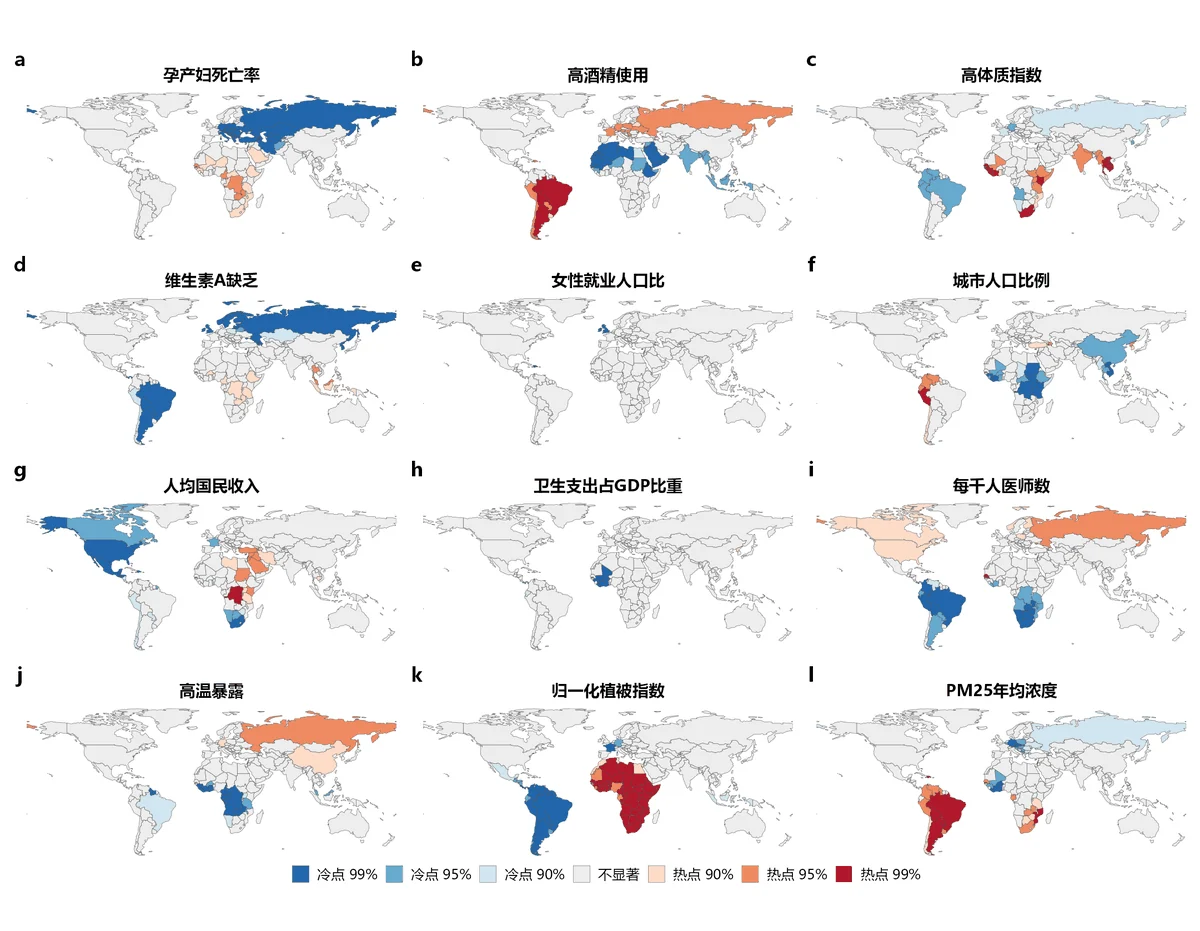
- 找出空间系数“成片偏高”(热点,红色)和“成片偏低”(冷点,蓝色)的区域;灰色 = 没有成片。
- 用来回答:作用特别强(或特别弱)的地区是不是连在一起,适合划定重点区域。
- 孕产妇死亡率:热点 4 个(如 Senegal、Zambia、Gambia),冷点 30 个(如 Republic of Serbia、Montenegro、Croatia)。
- 高酒精使用:热点 16 个(如 Brazil、Bolivia、Argentina),冷点 30 个(如 Saudi Arabia、Algeria、Oman)。
- 高体质指数:热点 22 个(如 Lesotho、Guinea、Cambodia),冷点 8 个(如 Colombia、Angola、Germany)。
- 维生素A缺乏:热点 2 个(如 Malaysia、Thailand),冷点 20 个(如 Russia、Norway、Finland)。
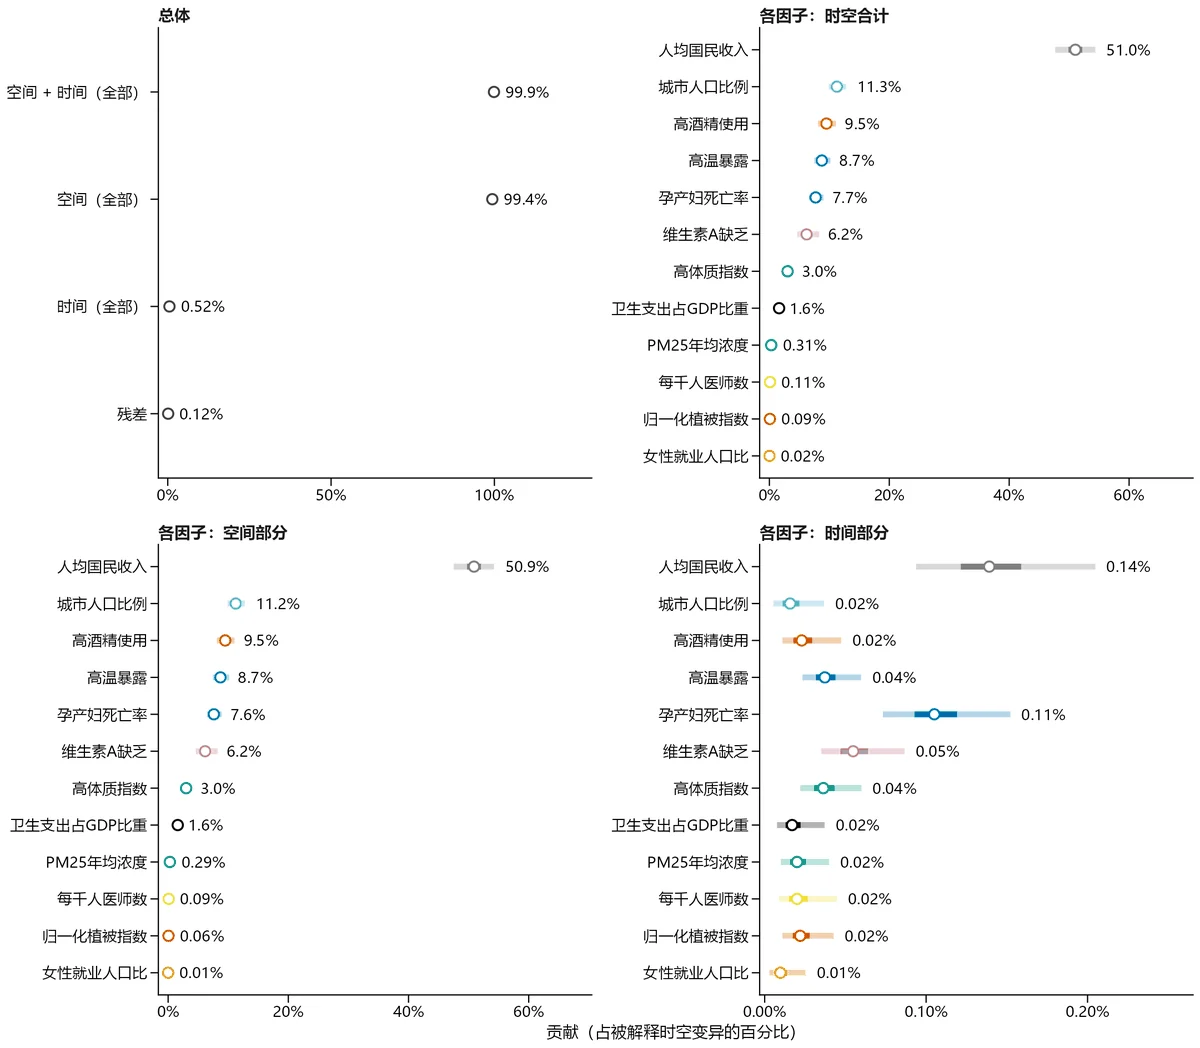
- 左上“总体”:结局的时空差异里,空间部分、时间部分各占多少。
- 其余面板:每个因素的贡献(时空合计、空间部分、时间部分);圆圈 = 估计值,粗、细条 = 50%、95% 可信区间。
- 只有解释变量标准化后,不同因素的百分比才能互相比较。
- 各因素(空间 + 时间合计):
人均国民收入51.0%、城市人口比例11.3%、高酒精使用9.5%、高温暴露8.7%、孕产妇死亡率7.7%、维生素A缺乏6.2%、高体质指数3.0%、卫生支出占GDP比重1.6%、PM25年均浓度0.3%、每千人医师数0.1%、归一化植被指数0.1%、女性就业人口比0.0%。 - 区间重叠很多的因素,排名不要说得太死。
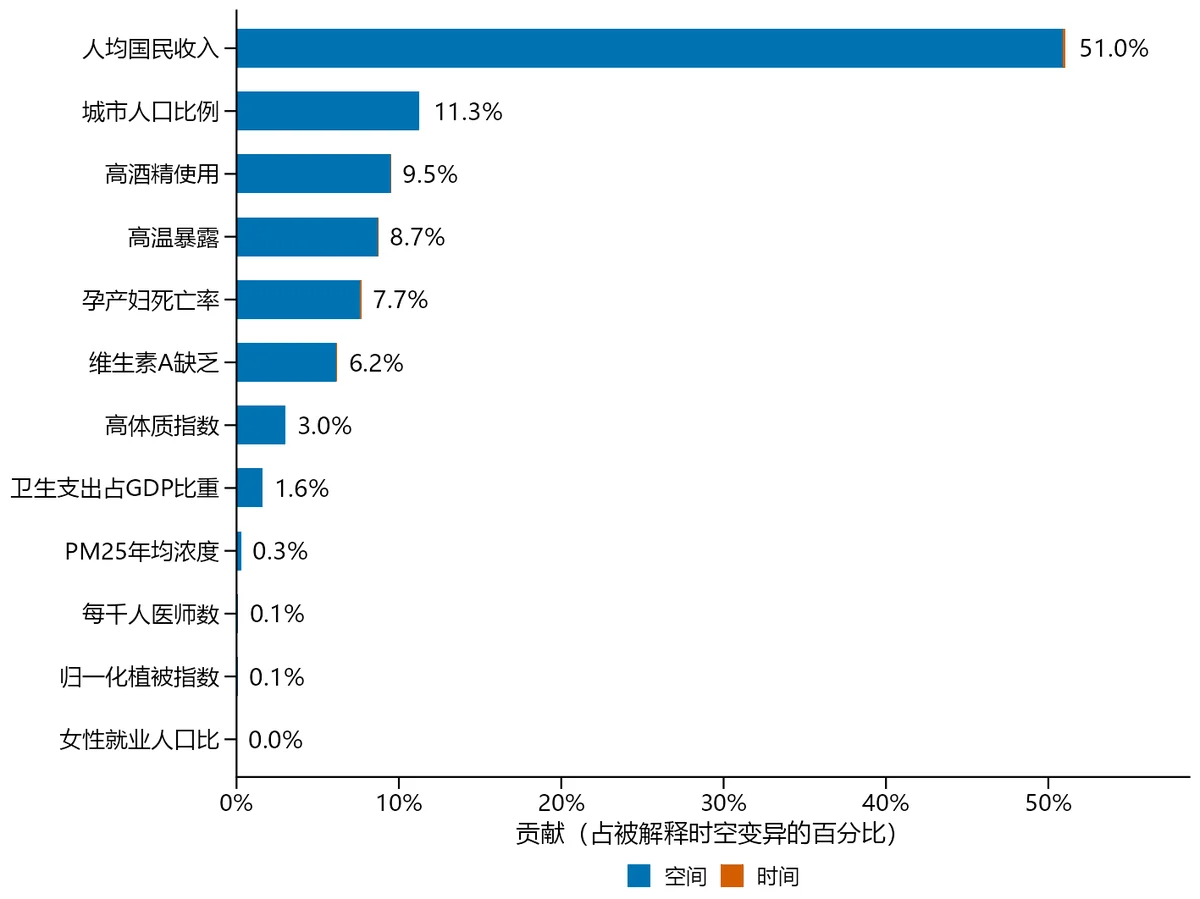
- 一根条 = 一个因素,条长 = 它的总贡献;两段颜色 = 空间部分和时间部分。
- 条最长的因素是本研究的关键因素候选;空间段占绝大部分 → “因地制宜”;时间段明显 → 还要“因时制宜”。
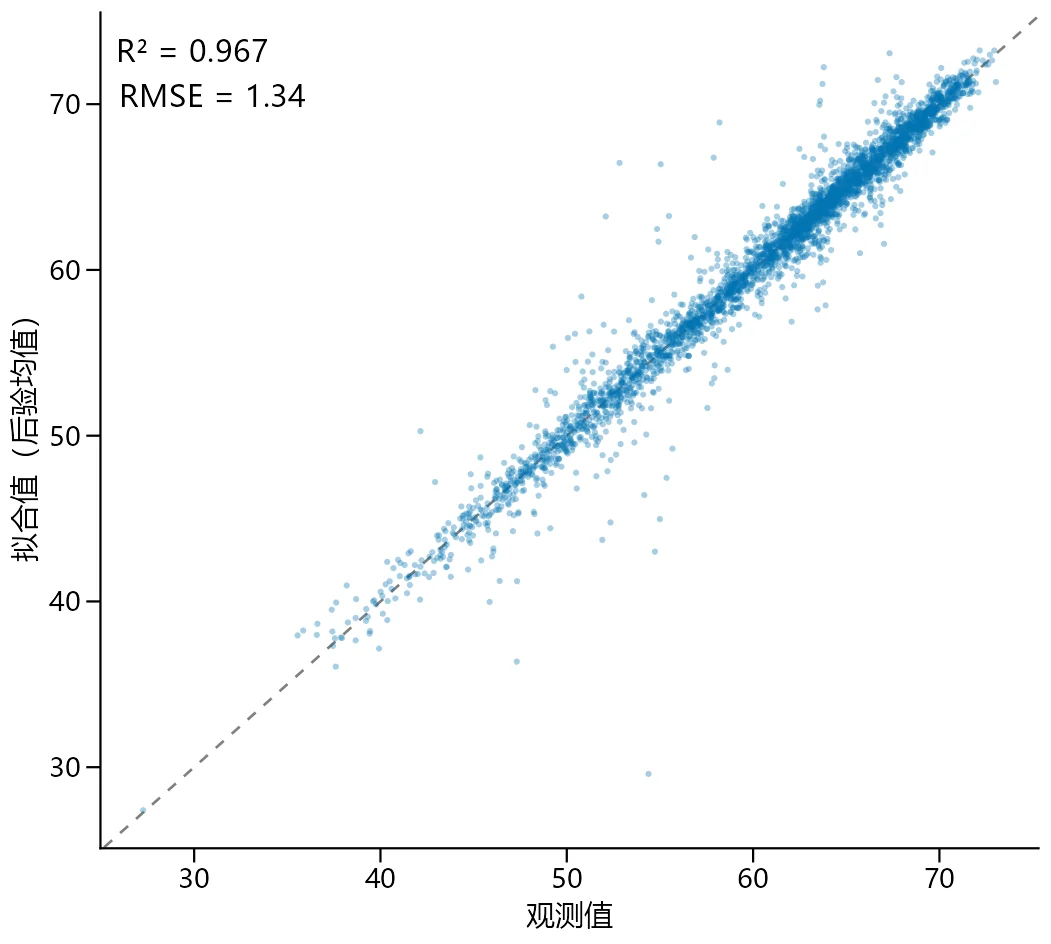
- 横轴观测值,纵轴模型拟合值;点越贴近虚线越好。
- R² 越接近 1 越好;RMSE 是平均误差的大小(和 Y 同单位)。
- R² = 0.967,RMSE = 1.34(3444 个有观测的单元)。
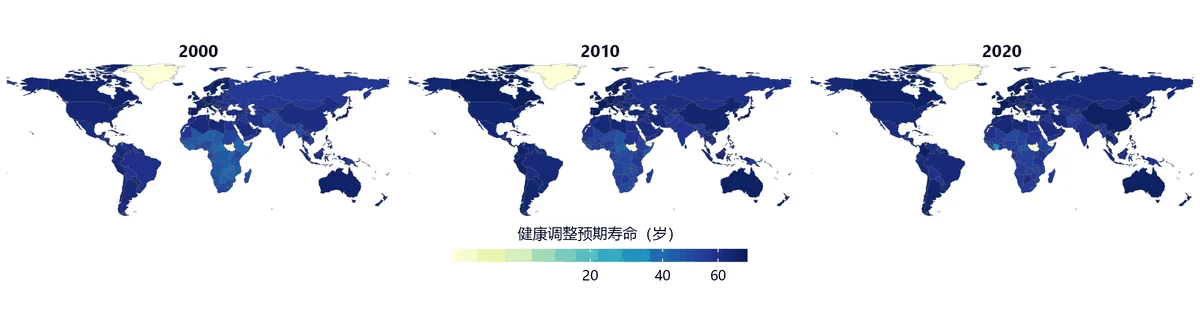
- 几个时点并排,共用同一色标:颜色的变化就是时间上的变化。
- 原数据里缺失的地区和年份也有拟合值,可用于补缺。
- 对比首末时点,看结局整体升降和空间格局有没有变。
想更深入地挖掘各地区的局部系数?本案例的全套类 SHAP 进阶图见第 14 章对应小节。
13 读图与出图:从结果表到可投稿的论文图
软件导出六张结果表。每个案例都附了现成的 R 脚本,一次运行就画出中文、英文两套论文图(300 dpi PNG + 矢量 PDF),换成你自己的结果只需改几个文件名。
13.1 读图顺序:先整体,后局部
- 图 1 模型评价:这次拟合的整体情况。
- 图 5、6 STVPI:谁是主角?主要在“地区之间”还是“时间上”起作用?决定后面重点看空间图还是时间图。
- 图 2 时间系数:哪些时点作用比平时强、哪些弱。
- 图 3、3b、4 空间系数(核心):哪些地区作用强、方向有几成把握、是否连片。
- 图 7、8 拟合:模型对观测的复现程度,以及结局本身的时空分布。
读体检报告也是这个顺序:先看总评,再看哪几项最关键,最后逐项看细节。
13.2 九张核心图:各回答什么、怎么读、别误读
| 图 | 回答的问题 | 怎么读 | 别误读 |
|---|---|---|---|
| 1 模型评价 | 这次拟合整体怎样? | DIC、WAIC、LS 越小越好,只在同一数据、同一 Y 上比较 | 拿 DIC 去比 WAIC |
| 2 时间系数 | 哪些时点作用更强 / 更弱? | 0 线 = 研究时期平均;看曲线高低和趋势 | 把时间系数当成“这一年的全部作用”(还要加空间系数) |
| 3 空间系数地图 | 哪些地区作用更强 / 更弱? | 红 = 推高,蓝 = 拉低;每幅各自分级,看图例数值 | 跨地图比较颜色深浅 |
| 3b 方向概率地图 | 作用方向有几成把握? | 0–1 连续:越红越确定为正,越蓝越确定为负,白 = 说不准 | 把它当成“作用大小”(大小看图 3) |
| 4 热点与冷点 | 高(低)作用的地区连成片吗? | 红 = 成片偏高,蓝 = 成片偏低 | 当成确证性结论(它是探索性的) |
| 5 STVPI 分面 | 谁是关键因素?空间还是时间? | 圆圈 = 估计值,粗 / 细条 = 50% / 95% 区间 | X 未标准化时比较百分比 |
| 6 STVPI 堆叠 | 每个因素的贡献由什么组成? | 条长 = 合计,两段 = 空间 / 时间 | 只看排名不看区间 |
| 7 拟合精度 | 模型复现观测有多好? | 连续 / 计数:点贴近虚线、R²;二分类:ROC 与 AUC | 当成对新数据的预测能力 |
| 8 拟合值地图 | 结局在时空中怎样分布? | 几个时点共用一个色标 | 各时点分别配色后再比较 |
13.3 论文图标准:中英两套,可直接投稿
出图脚本按国际期刊的常见版式统一设计,图里不放标题和长段说明(期刊要求写在图注里),英文版可直接用于英文论文,中文版用于中文论文和汇报:
进阶 英文图注模板(可直接改写使用)
| 图 | Figure legend template |
|---|---|
| 2 | Temporal coefficients of [covariates], [period]. Lines show posterior means; dark and light bands show 50% and 95% credible intervals. The dashed line marks the average over the study period. |
| 3 | Spatial coefficients of [covariates] across [n] [areas]. Each map uses its own classification; red indicates a positive and blue a negative association with [outcome]. |
| 3b | Posterior probability that the spatial coefficient is positive. Values close to 1 (red) or 0 (blue) indicate high certainty about the direction of the association. |
| 5 | Spatiotemporal variance partitioning (STVPI). Points show posterior means; thick and thin bars show 50% and 95% credible intervals. |
| 7 | Model fit. Observed versus fitted values (posterior means); the dashed line is the 1:1 line. / ROC curve of fitted probabilities. |
13.4 全部案例的核心图一览
点任意缩略图,跳到该案例的“可视化与解读”。
案例 2 的中国地图仅为案例展示,实际使用请依据国家标准地图重新绘制。
13.5 写进论文:可直接套用的句式
| 写什么 | 句式(方括号换成你的结果) |
|---|---|
| 模型与设置 | 采用贝叶斯时空变系数模型(BSTVC;BSTVC 桌面版 26.10.25),[响应类型] 结局,[N] 个地区 × [T] 个时点,[K] 个解释变量(已标准化),QUEEN 邻接矩阵。 |
| 模型评价 | 模型 DIC 为 [ ],WAIC 为 [ ],LS 为 [ ];拟合值与观测值的 R²(或 AUC)为 [ ](表 S1)。 |
| 关键因素 | STVPI 显示,[因素 A]([x]%,95% CrI [a]–[b]%)与 [因素 B]([y]%)是时空变异的主要贡献因素,其贡献主要来自空间部分([s]%)。 |
| 时间格局 | 相对研究期平均水平,[因素 A] 的作用在 [时段] 更强、在 [时段] 减弱(图 2)。 |
| 空间格局 | [因素 A] 的空间系数在 [区域] 较高、在 [区域] 较低;[区域] 的作用为正的后验概率超过 [0.9](图 3、3b),并形成高值聚集(图 4)。 |
14 进阶:局部系数的“类 SHAP”图(可选)
这是锦上添花的可选模块,核心仍是上一章的空间系数地图。每个地区、每个时点都有自己的局部回归系数,这和机器学习里 SHAP 给“每个样本、每个特征”一个解释值的思路一样,所以可以借用 SHAP 那一整套图,从更多角度挖掘结果。
- 一句话
- SHAP 告诉你“这个样本里每个特征推高或拉低了预测多少”;BSTVC 的局部系数告诉你“这个地区、这个时点每个因素的作用多大”。两者都是“局部解释”。
- 打个比方
- 全班的平均分只有一个数;局部解释是给每个学生都写一份“哪门课拉了分、哪门课加了分”的成绩分析。
- 为什么要用
- 地图一次只能看一个因素;类 SHAP 图能把所有因素、所有地区放在一张图里比较,找出主导因素、作用模式和地区类型。
- 怎么用
- 运行
run_local_coef(cfg)(案例脚本里已经写好);需要建模用的数据表(cfg 里的data),用来取每个地区的 X 值。 - 讲给别人听
- “BSTVC 的局部系数天生就是可解释的,可以像 SHAP 一样一张图看清每个地区由什么因素驱动。”
| 图 | 回答什么 | 怎么读 |
|---|---|---|
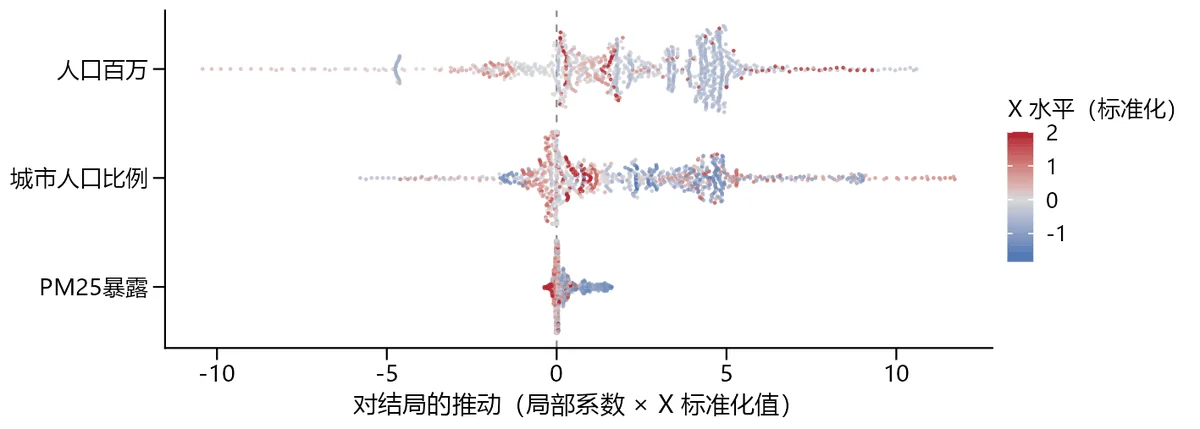
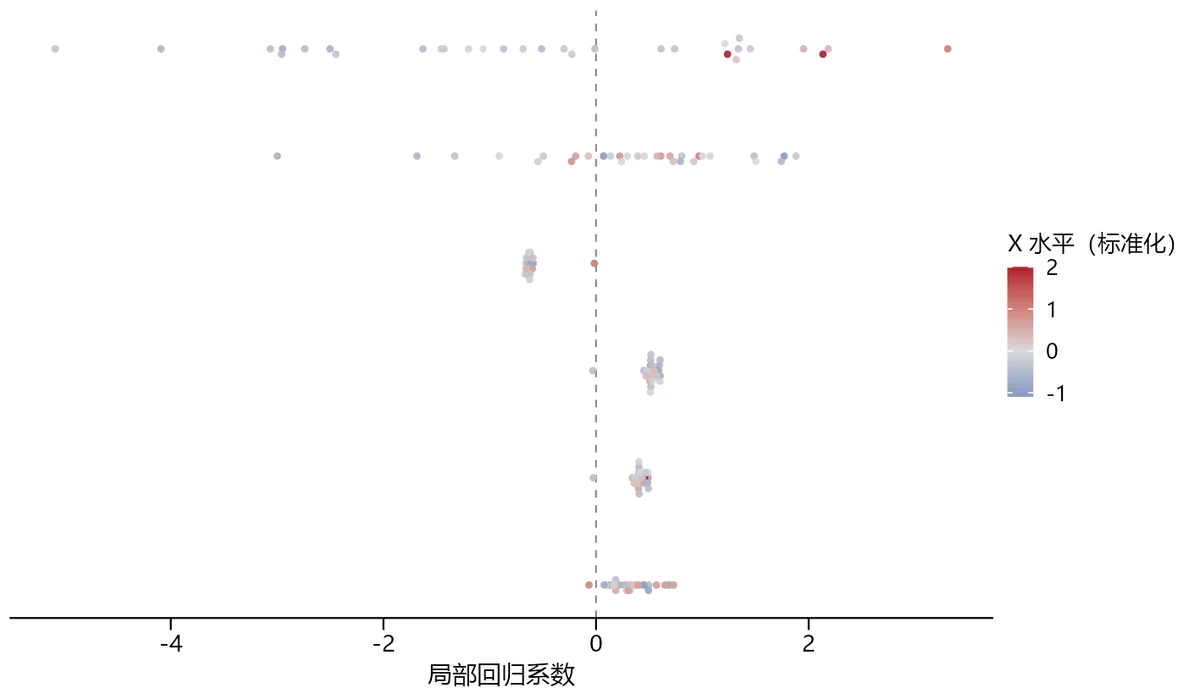
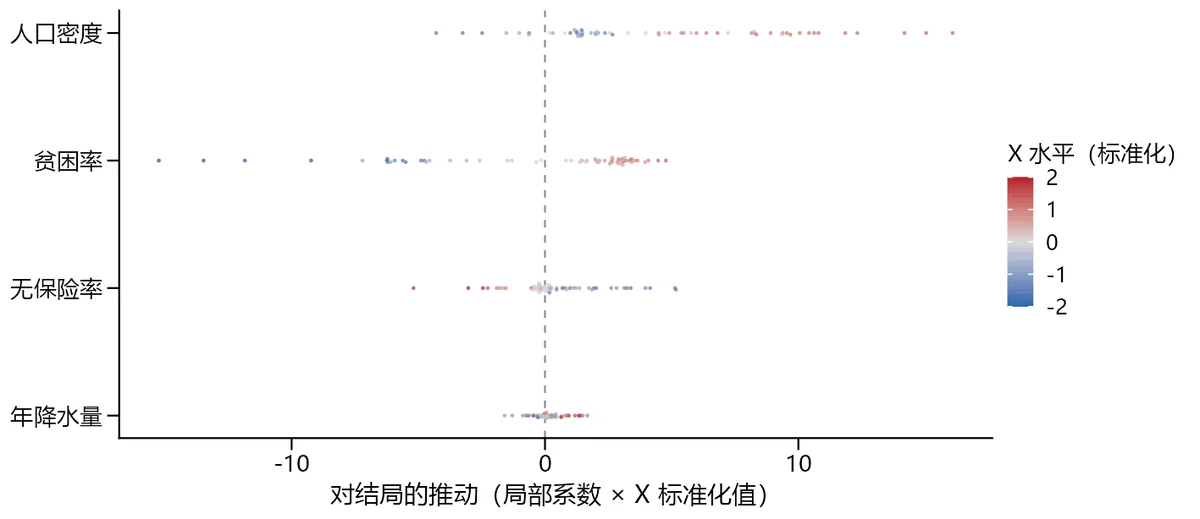
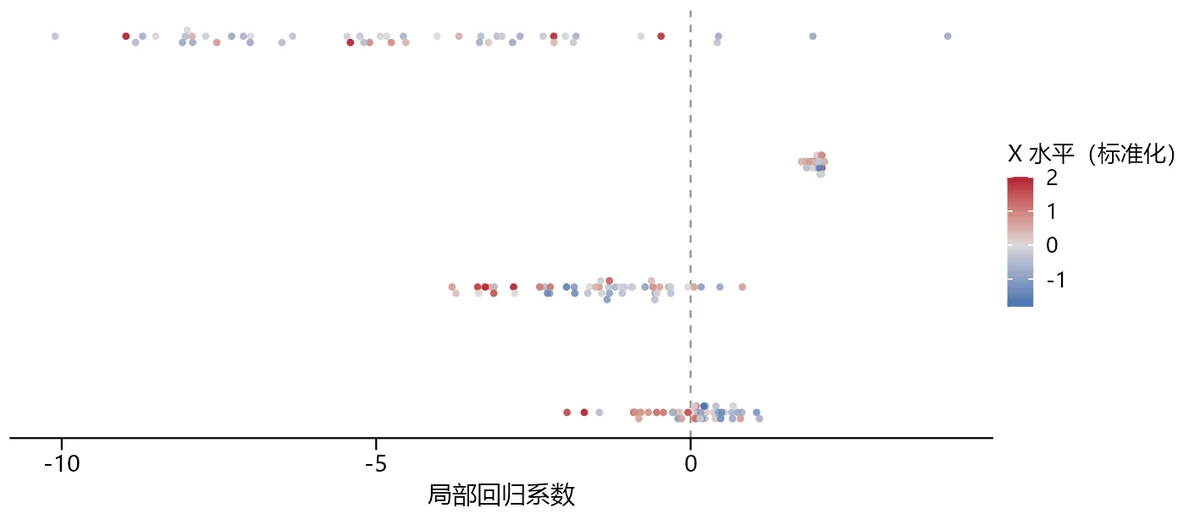
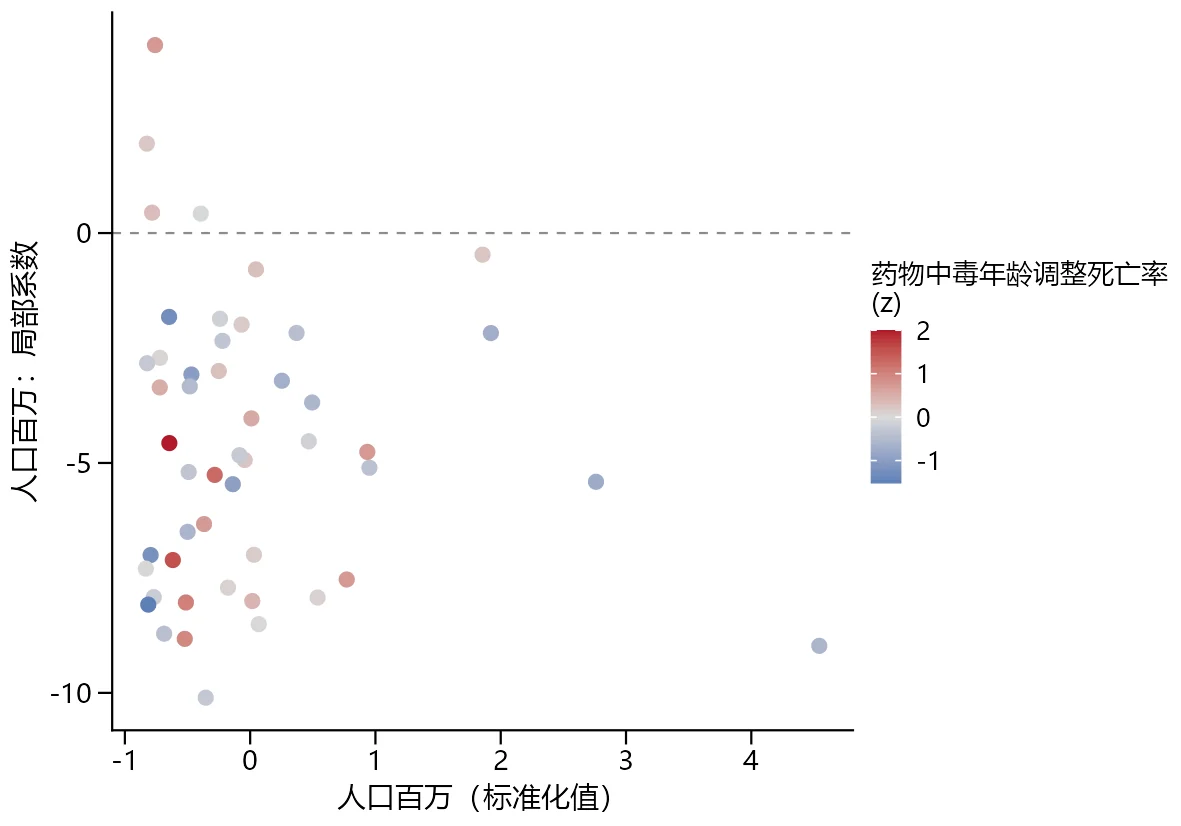
| 9 系数蜂群图 | 每个因素的作用在地区之间差多少? | 每个点一个地区;横向越分散,地区差异越大;颜色 = 该地区 X 高低 |
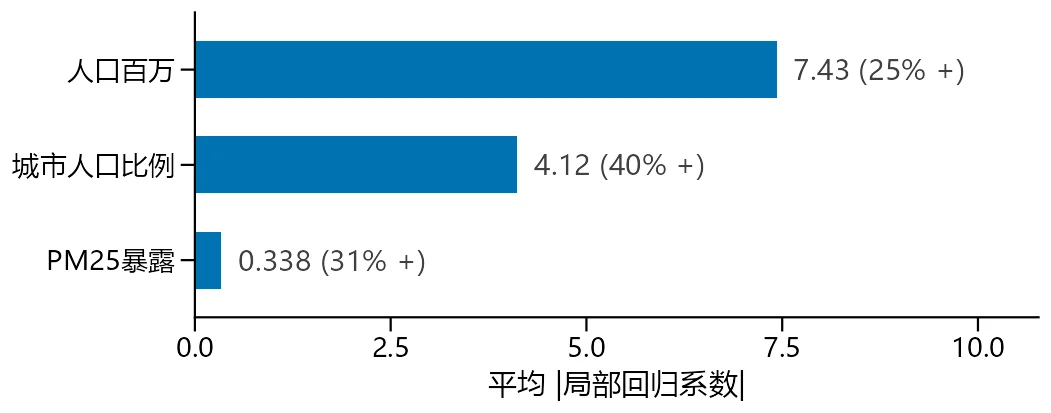
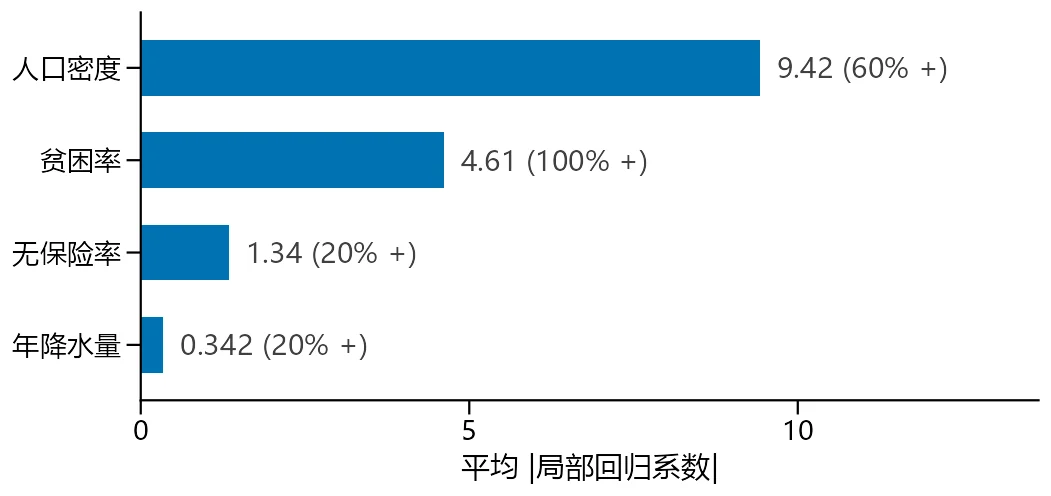
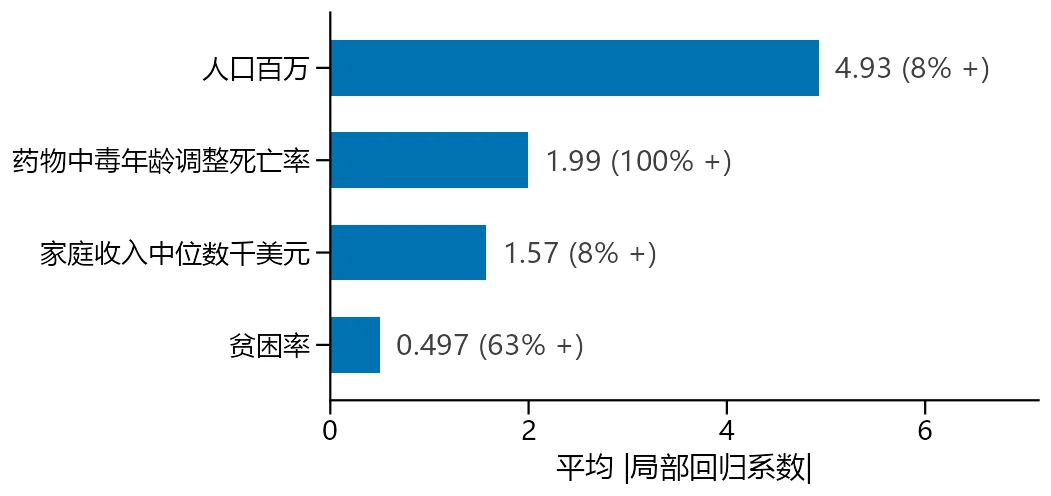
| 10 平均作用强度 | 总体上哪个因素作用最强? | 条越长作用越强(正负都算);括号里是作用为正的地区占比 |
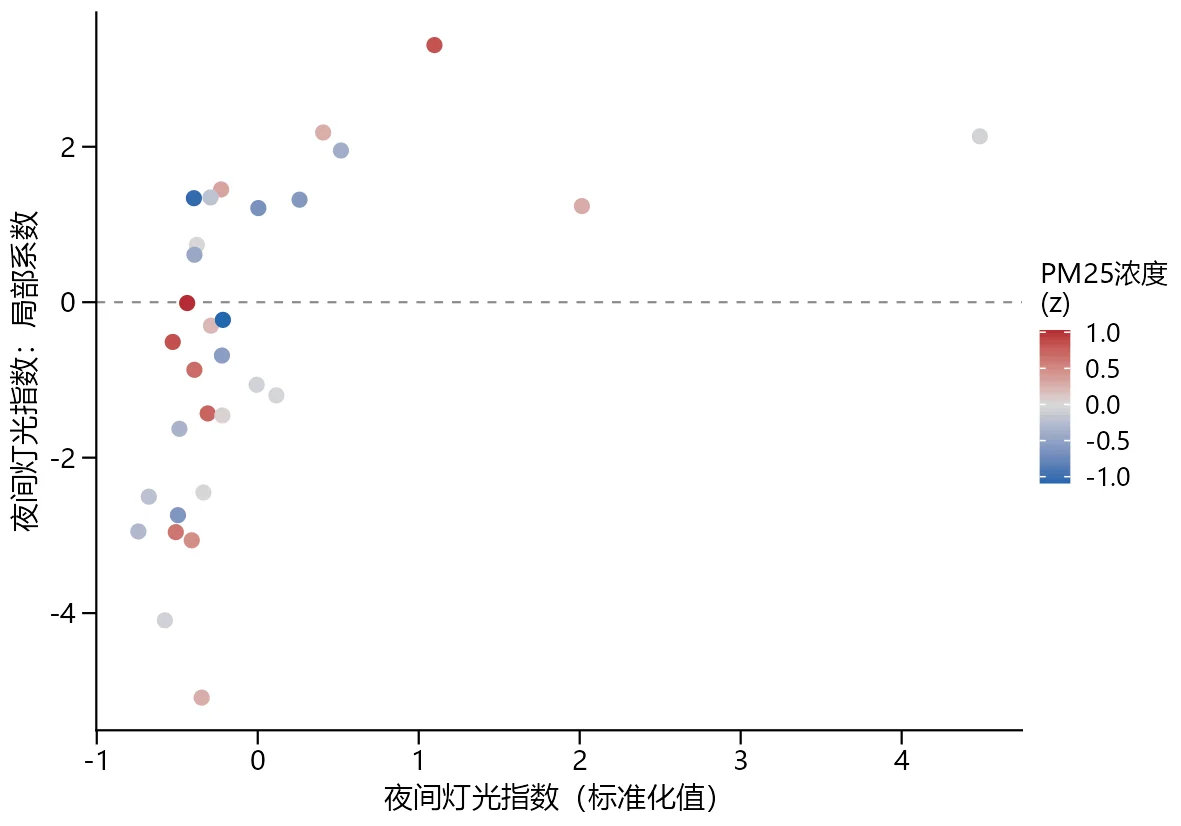
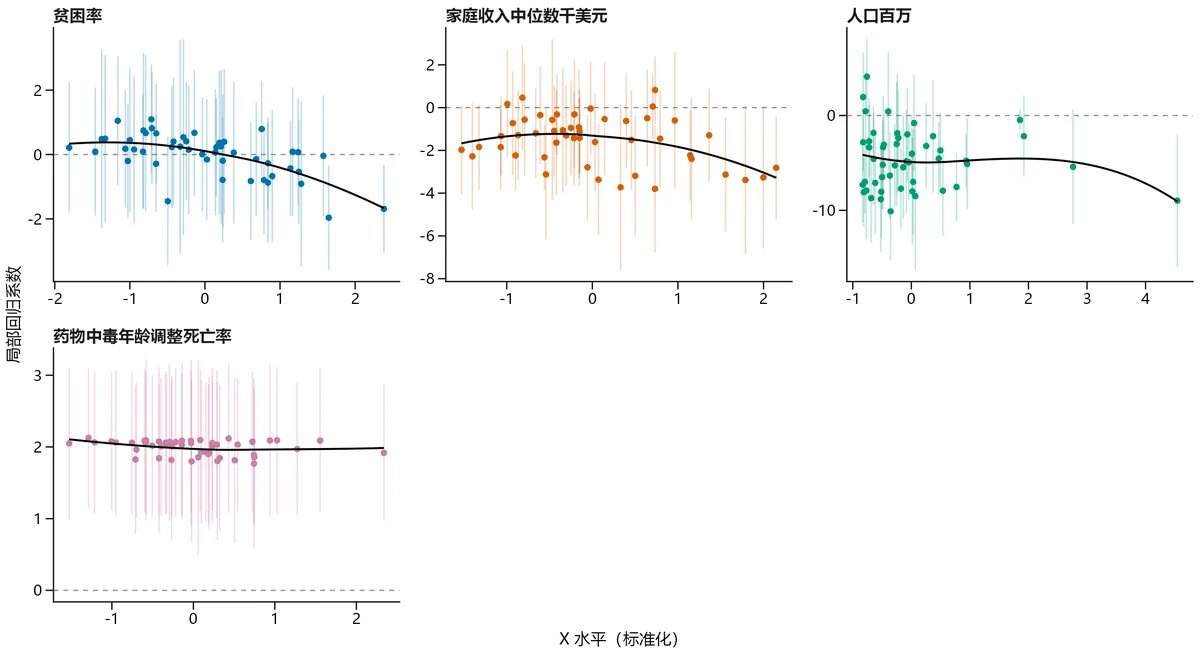
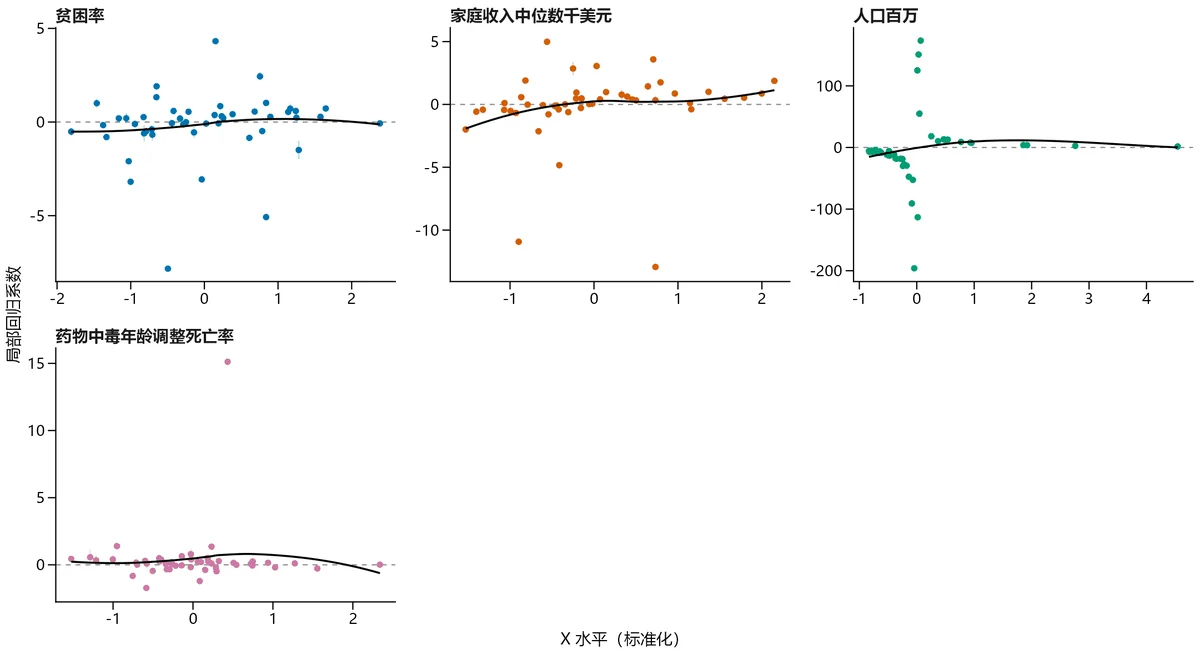
| 11 依赖图 | X 高的地方,作用是否更强? | 点 = 地区;黑线上升 = X 越高作用越正 |
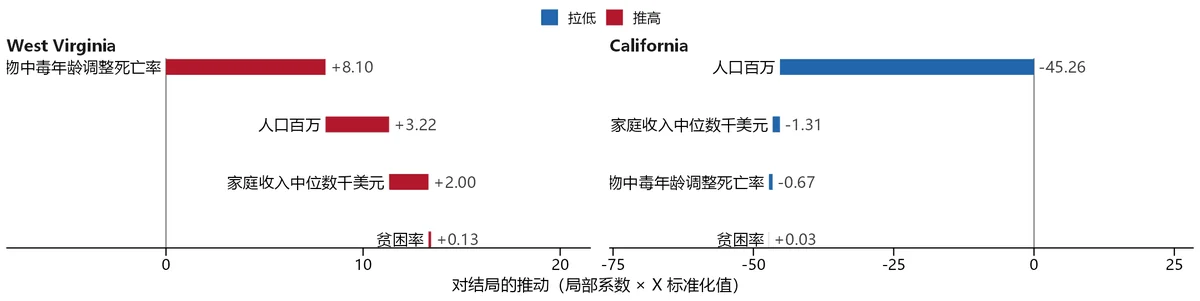
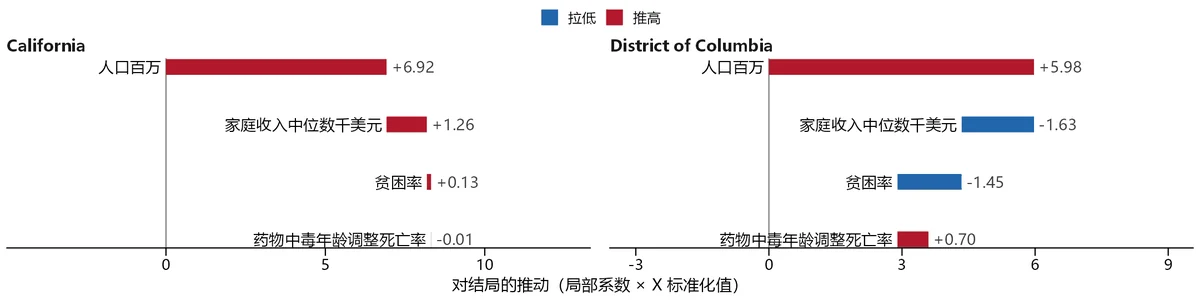
| 12 贡献瀑布图 | 某个地区的结局被哪些因素推高、拉低? | 红 = 推高,蓝 = 拉低,从上到下按贡献大小排列(默认展示拟合值最高和最低的两个地区) |
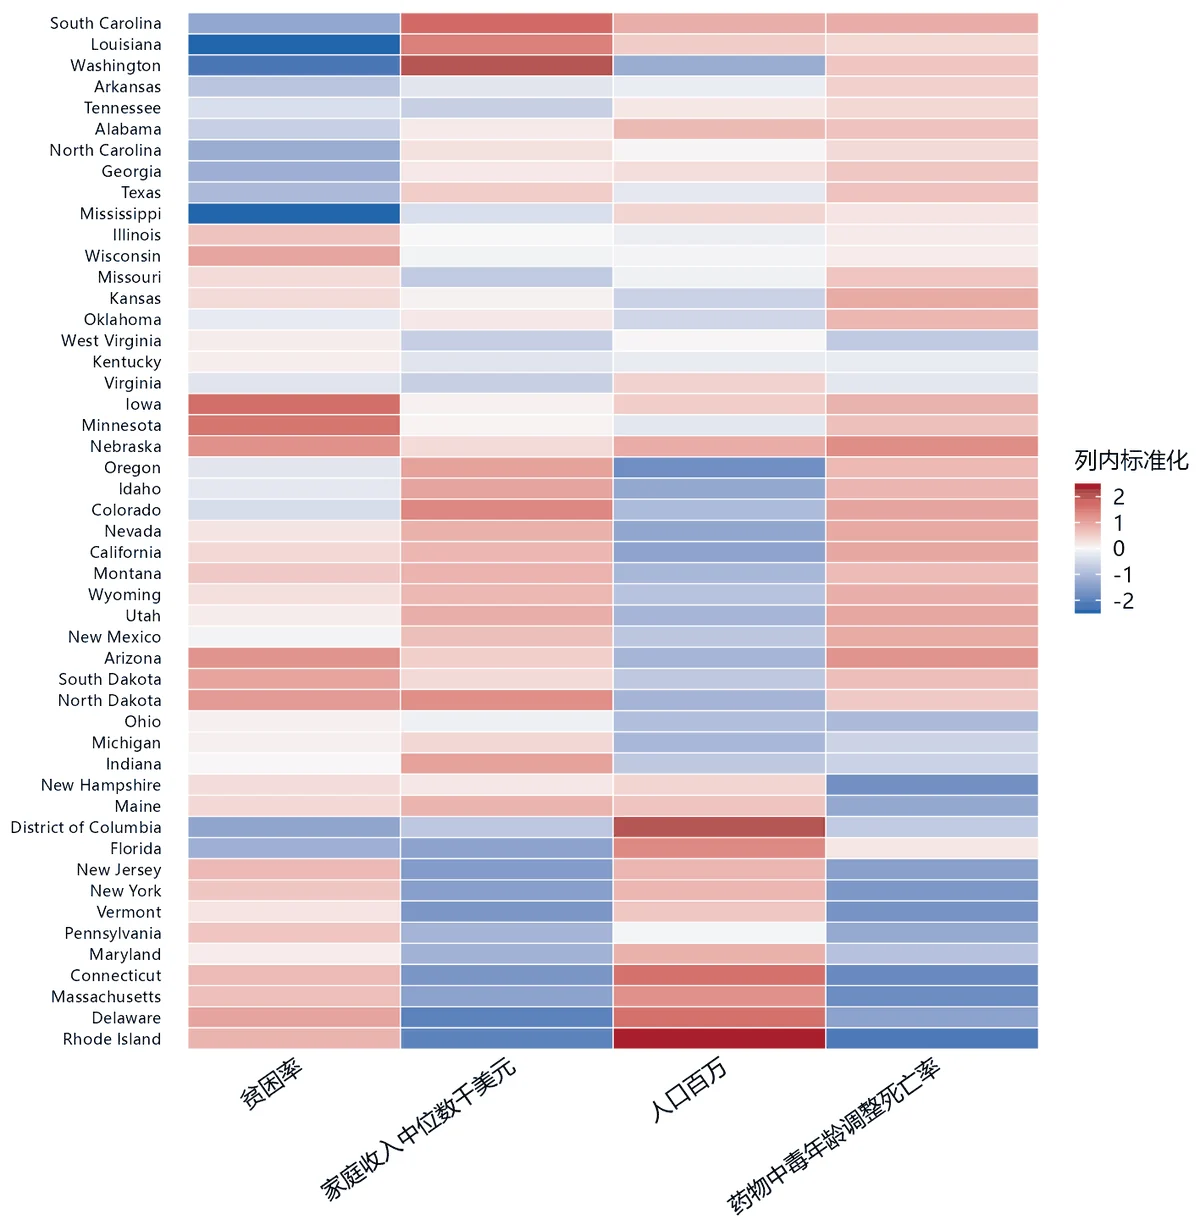
| 13 地区 × 因素热图 | 哪些地区的作用模式相似? | 红 = 该地区这个因素作用偏强;相邻行模式相近 |
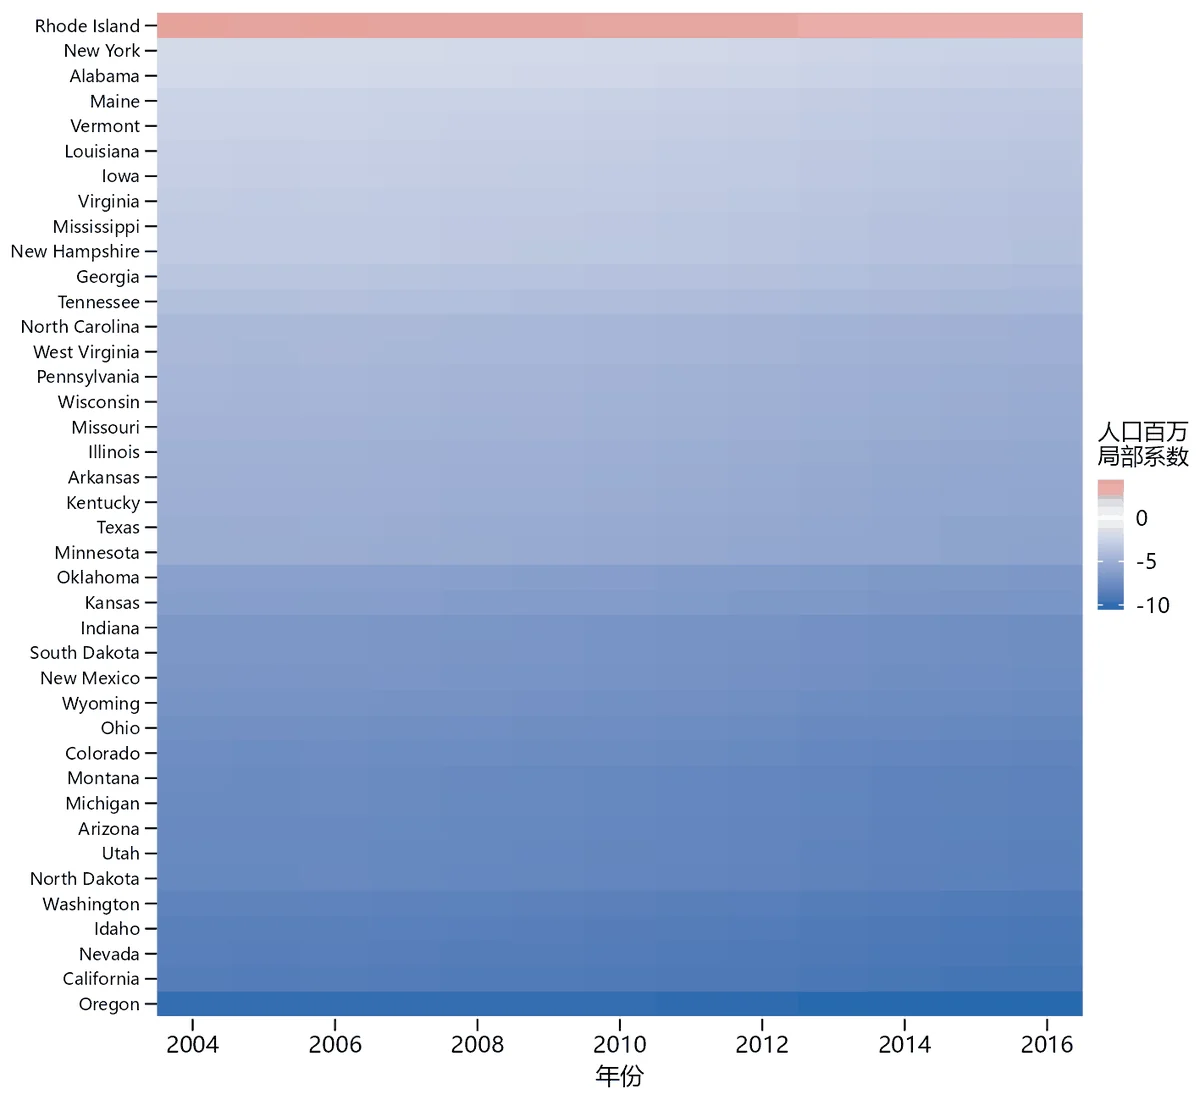
| 14 局部系数时空热图 | 最重要因素的作用在每个地区、每个时点怎样变化? | 横看随时间,竖看地区之间 |
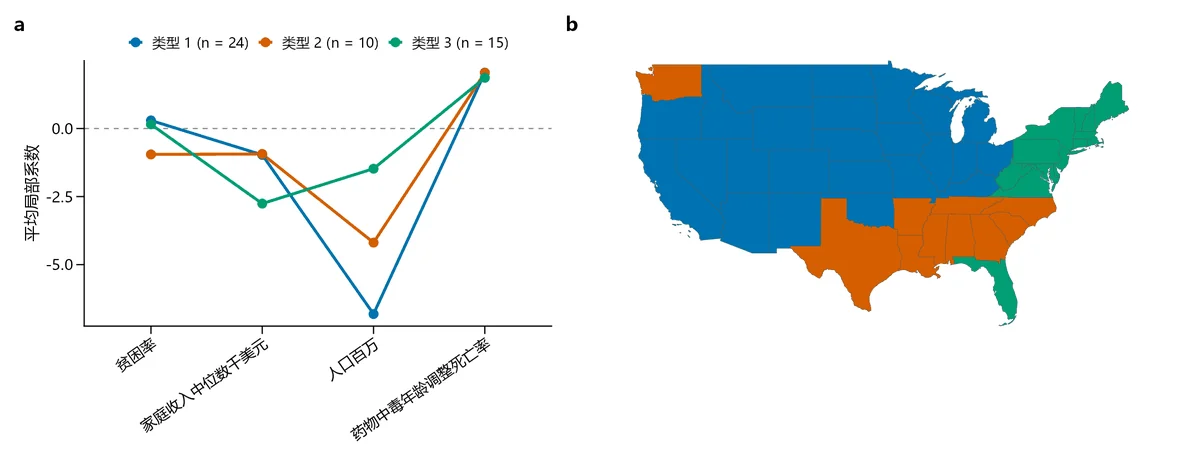
| 15 地区类型 | 能不能按作用模式给地区分类? | 左:每类的平均系数“画像”;右:每类在哪里 |
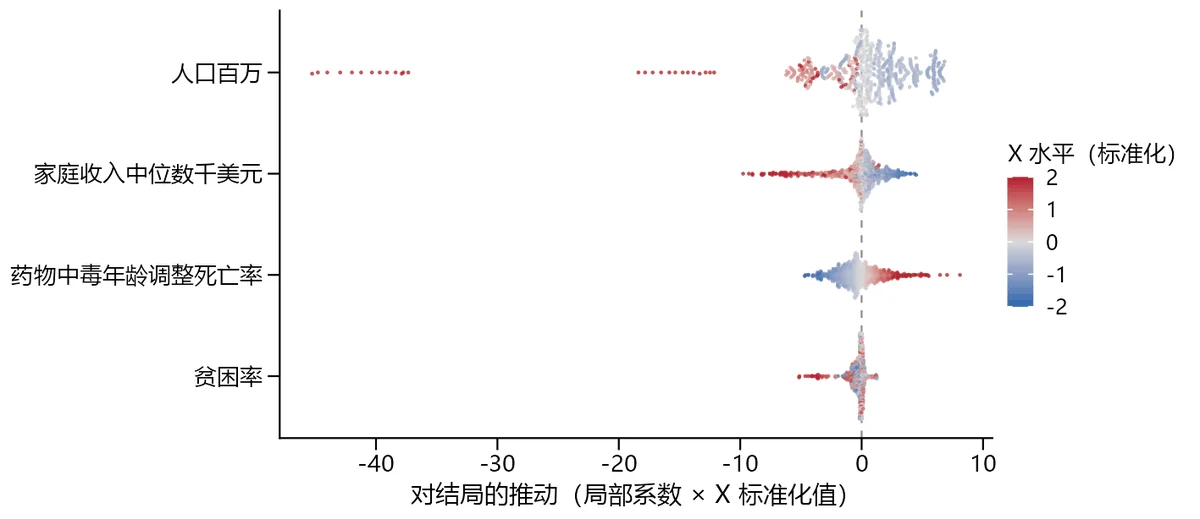
| 16 贡献蜂群图 | 每个因素推高还是拉低了结局?(最接近 SHAP 原图) | 右 = 推高,左 = 拉低;红点在右 = X 越高结局越高 |
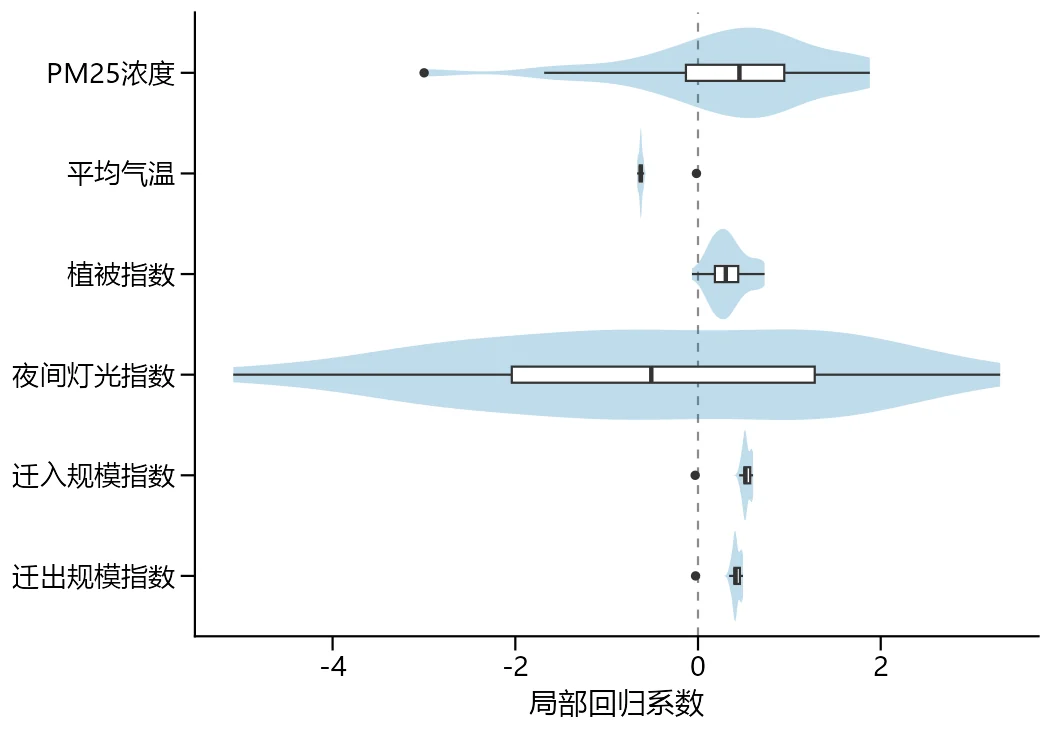
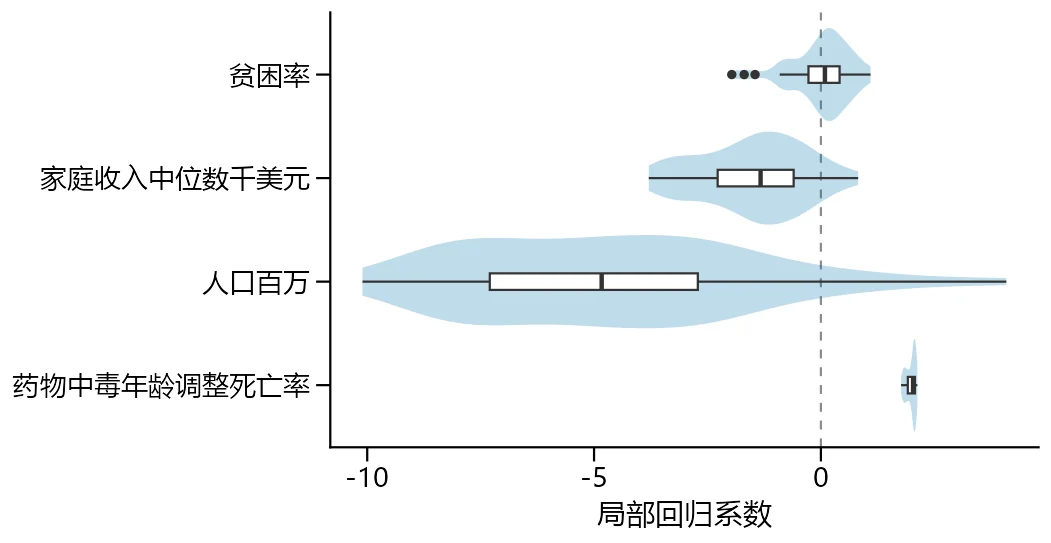
| 17 系数分布 | 系数在地区间是单峰还是两极分化? | 小提琴越宽,该取值的地区越多 |
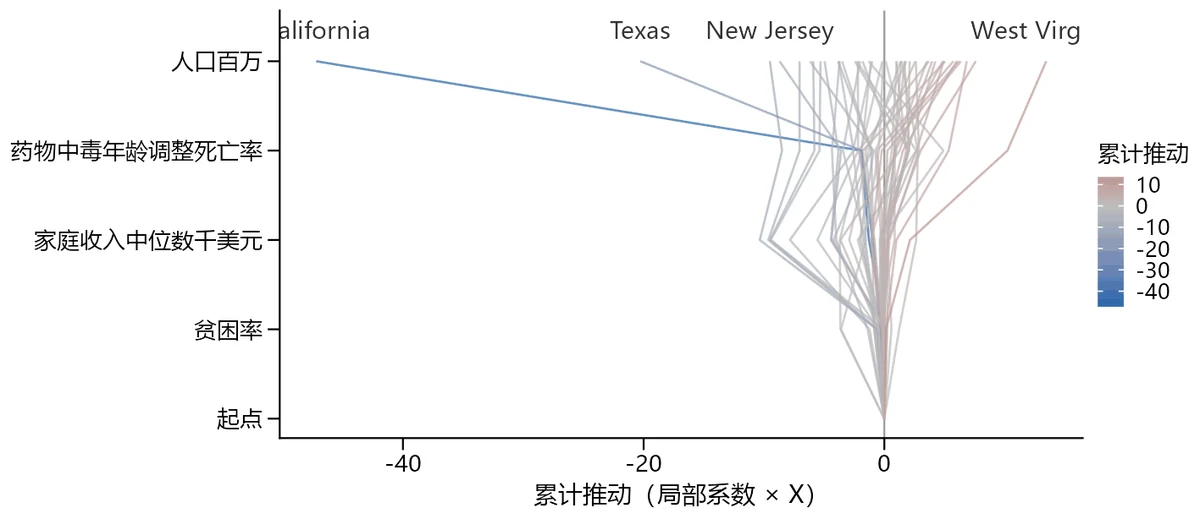
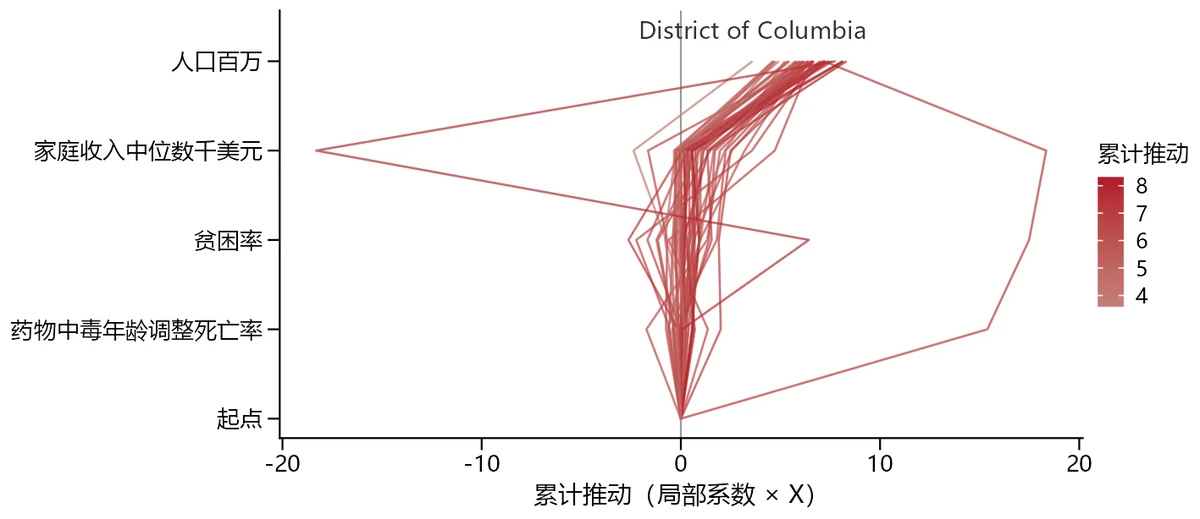
| 18 决策图 | 每个地区的结局是怎样一步步被推到最终位置的? | 每条线一个地区,在哪一层拐弯,哪个因素就让它与众不同 |
| 19 交互依赖图 | 两个因素是否相互放大? | 颜色 = 第二个因素的水平;红点集中在上方 = 相互放大 |
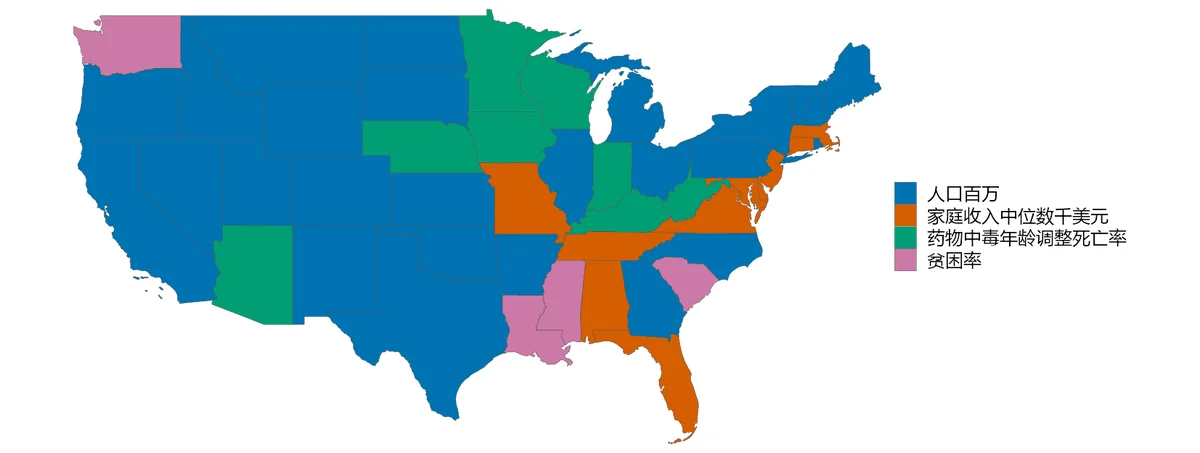
| 20 主导因素图 | 每个地区最该优先抓哪个因素? | 颜色 = 该地区贡献最大的因素 |
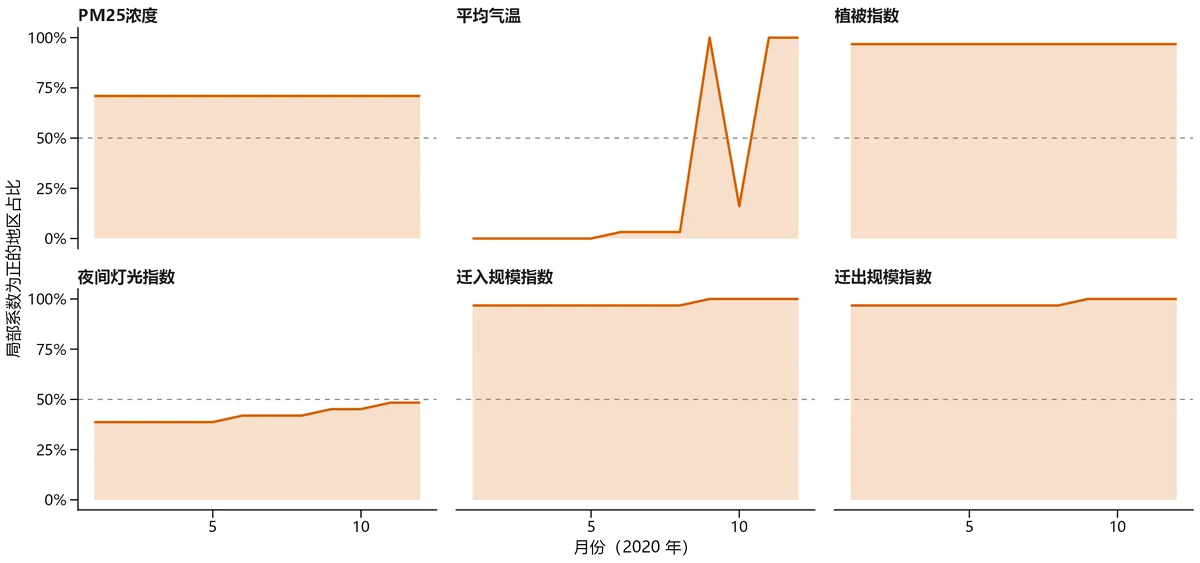
| 22 作用方向随时间 | “作用为正”的地区比例怎样随时间变化? | 接近 100% = 几乎处处为正;在 50% 附近 = 方向因地而异 |
下面按案例逐一给出全部进阶图。每节先给读图要点(直接由结果表算出),再给图。
14.1 案例 1 · 非洲五岁以下儿童死亡率
- 先看图 16 和图 10 找主角,再看图 12、图 20 落到具体地区,最后用图 15 给地区分类型。
- 平均作用强度从强到弱:人口百万(7.43,正向地区 25%) > 城市人口比例(4.12,正向地区 40%) > PM25暴露(0.338,正向地区 31%)。
- 作用方向因地而异(正向地区占 20%–80%)的因素:人口百万、城市人口比例、PM25暴露——这些因素最适合看图 16、图 20,按地区分别施策。
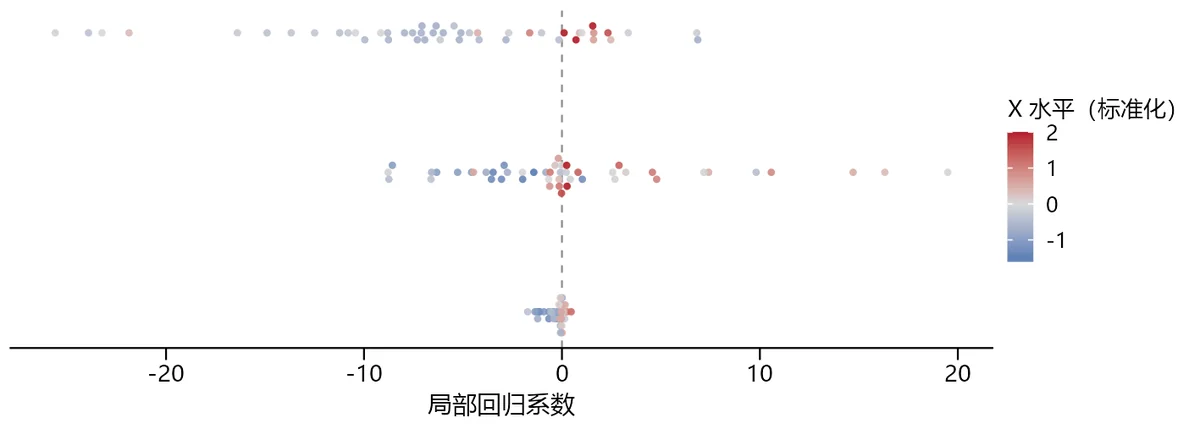
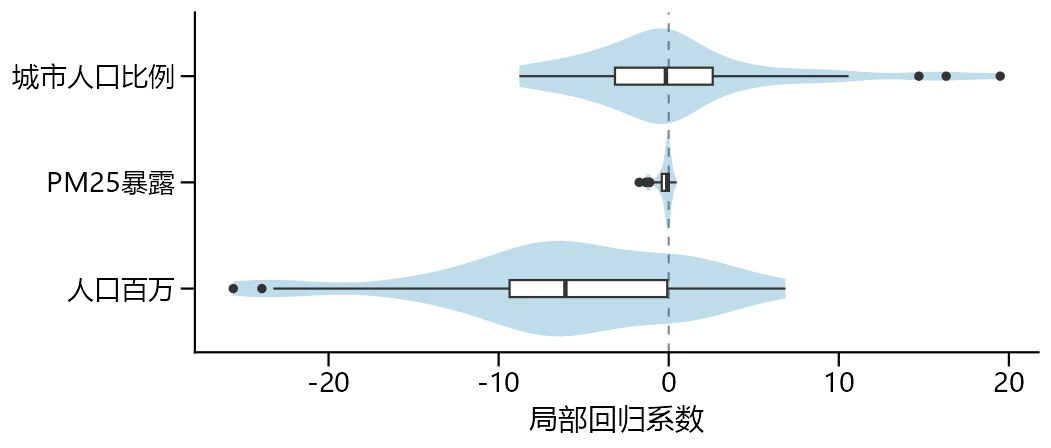
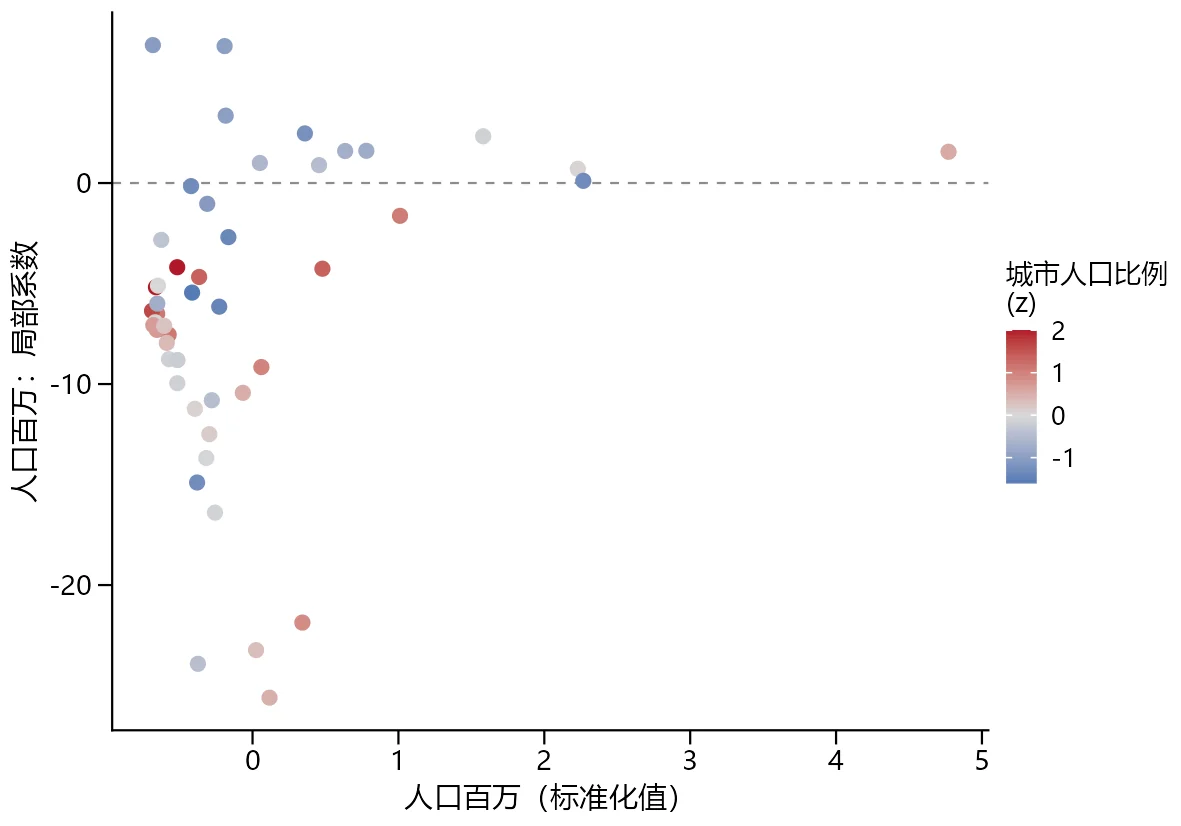
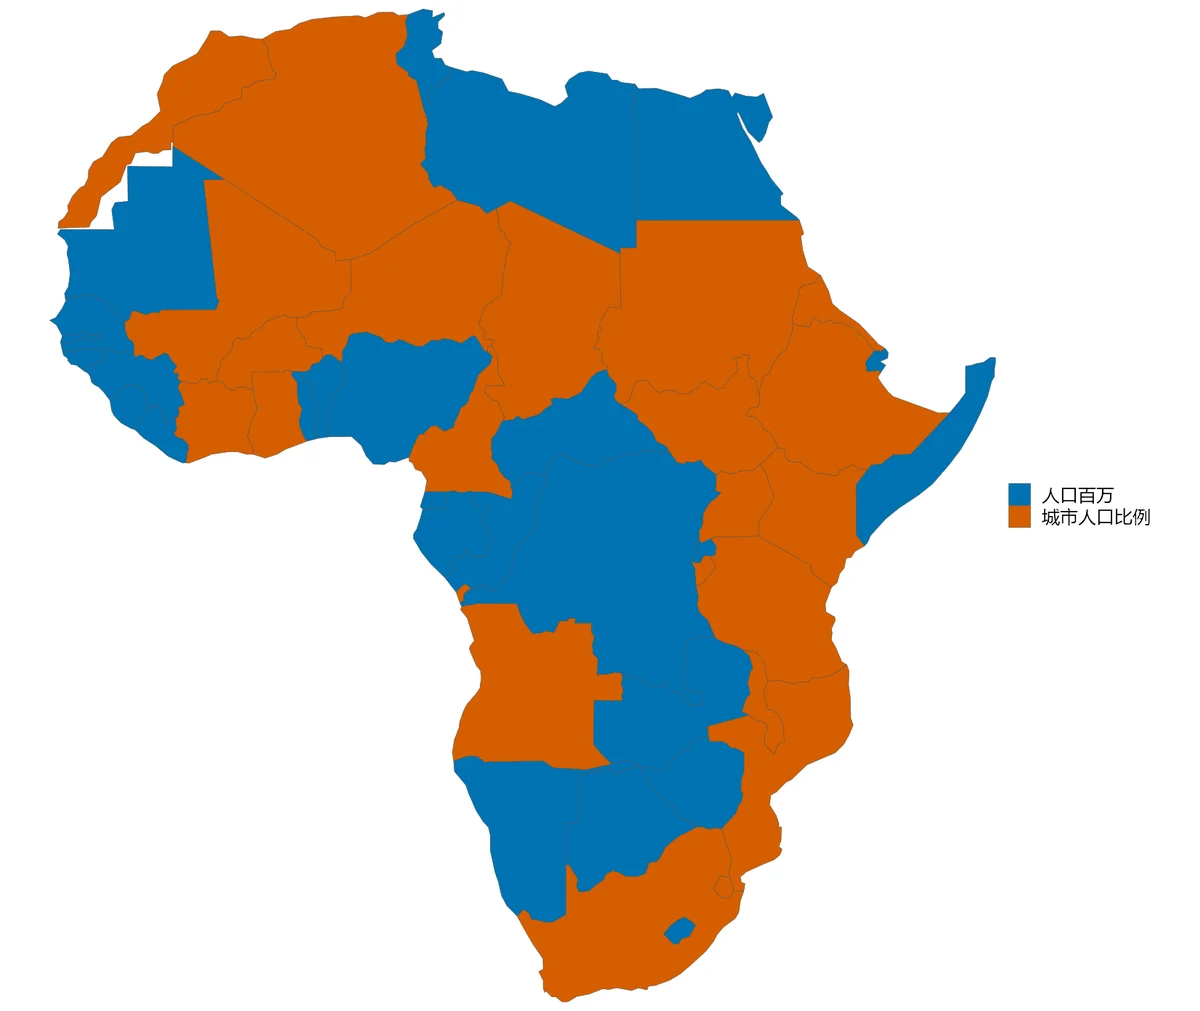
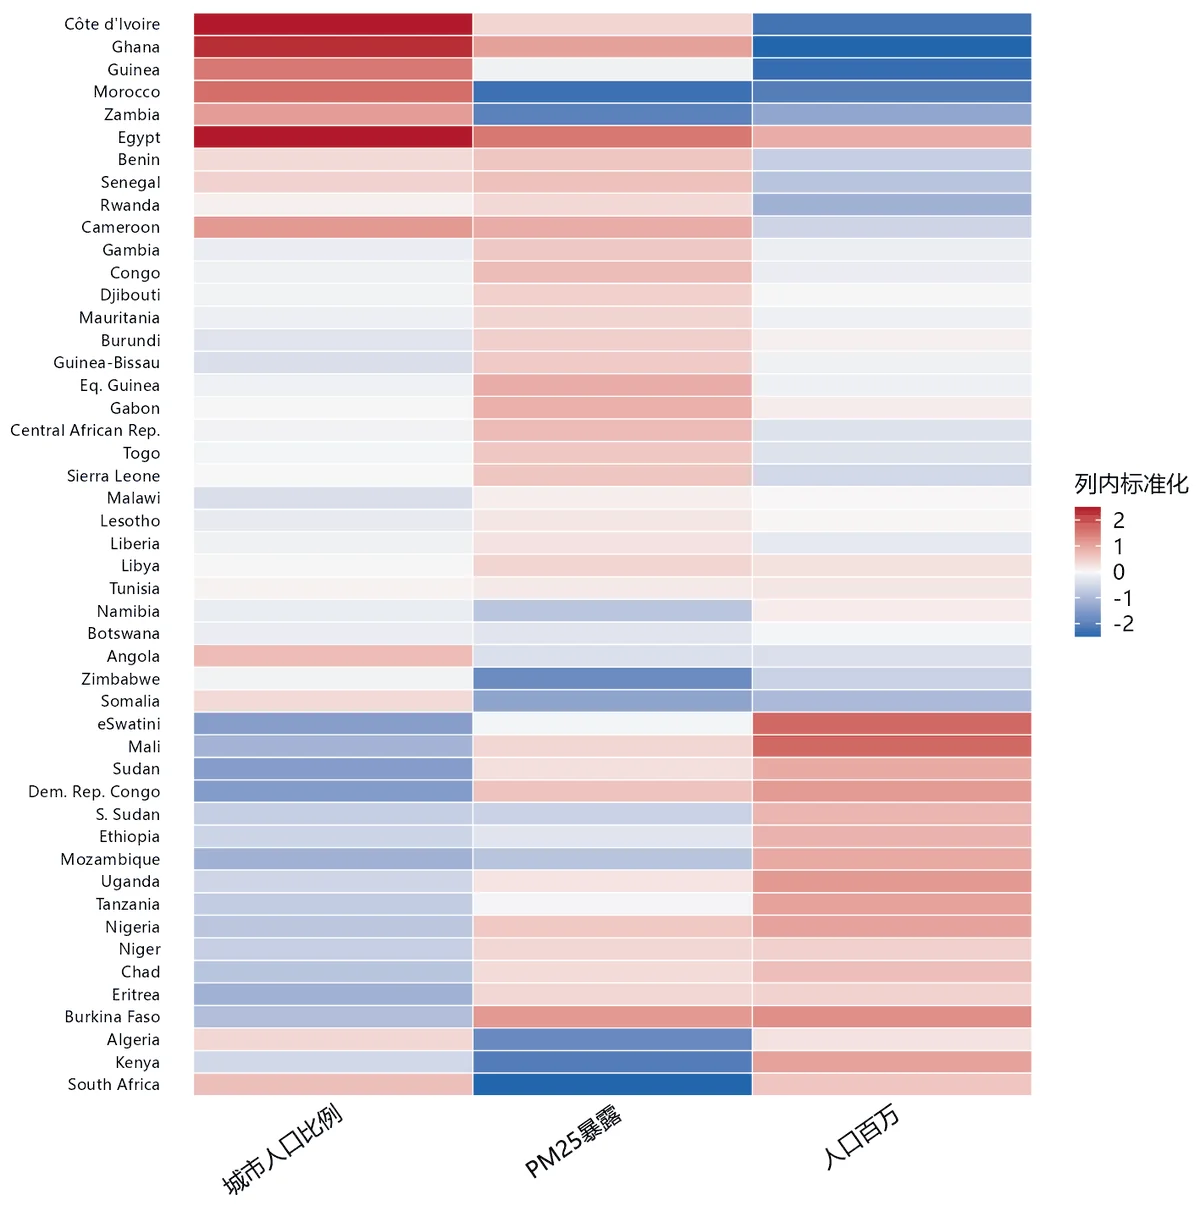
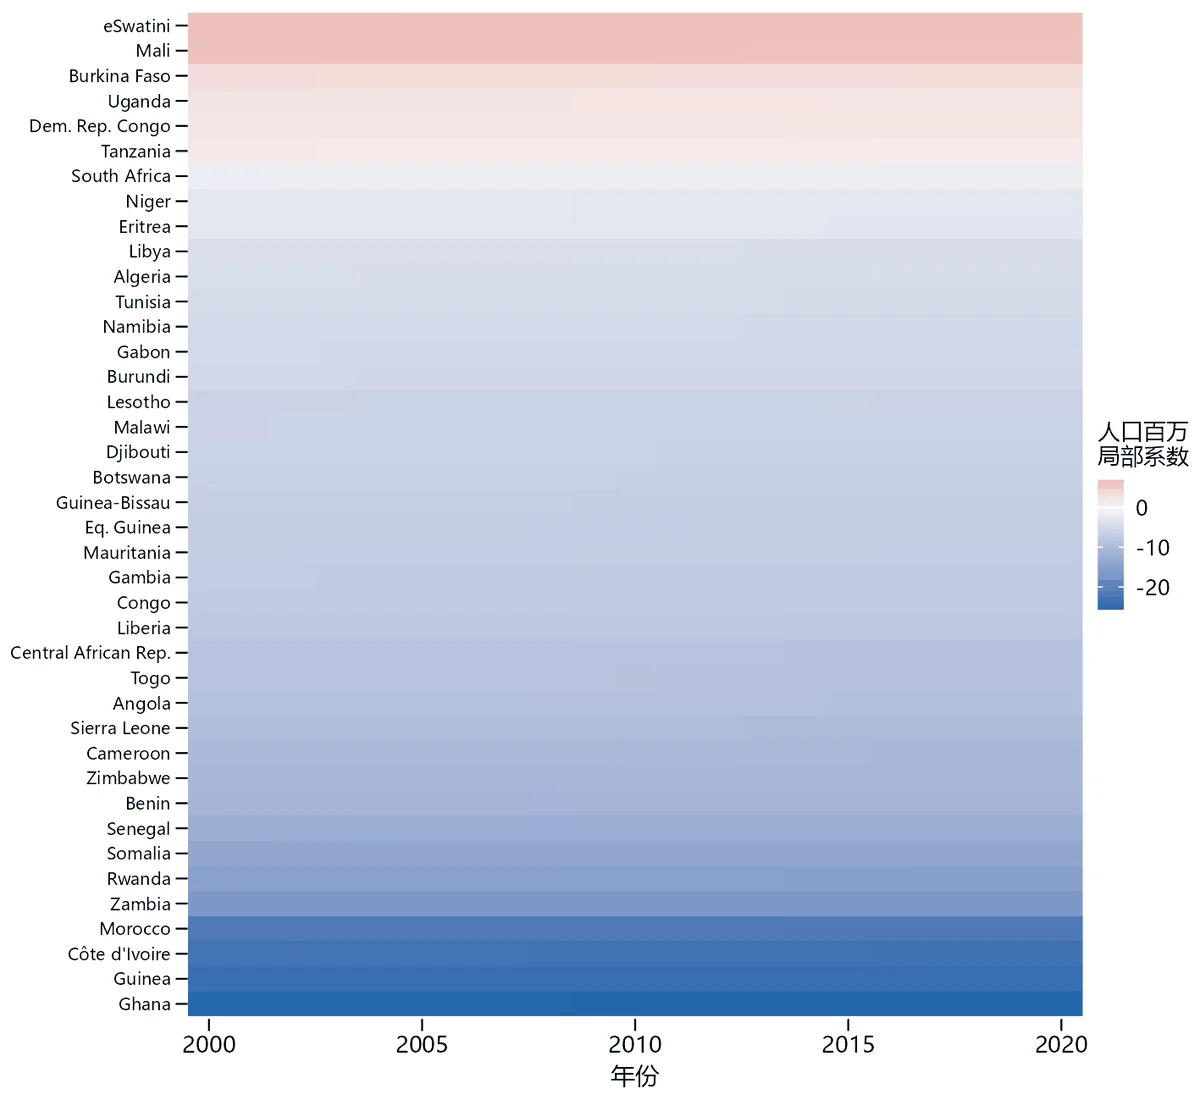
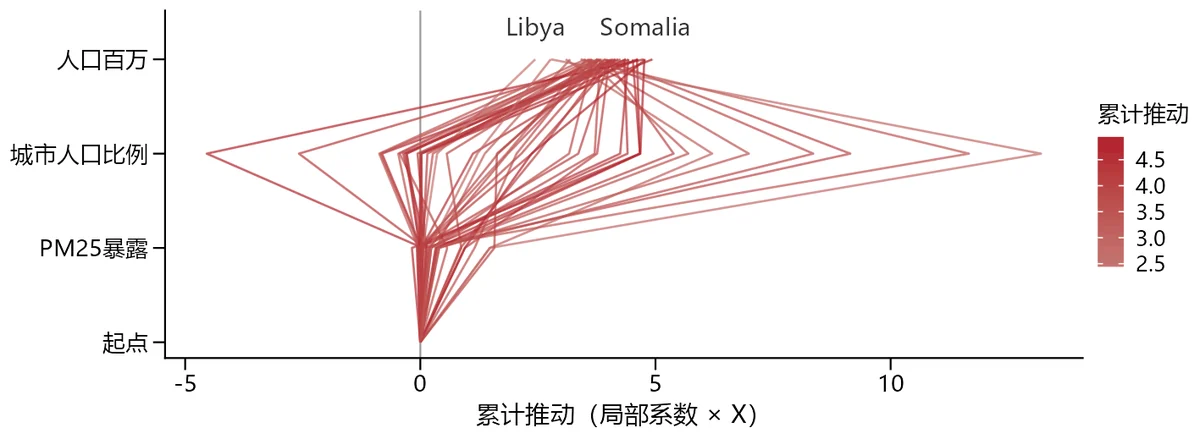
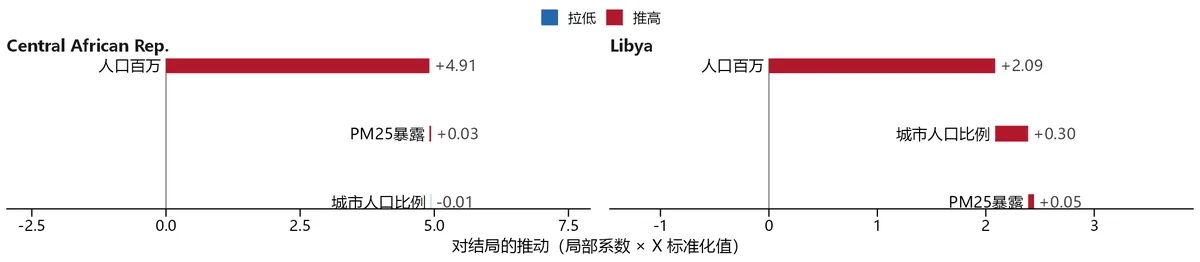
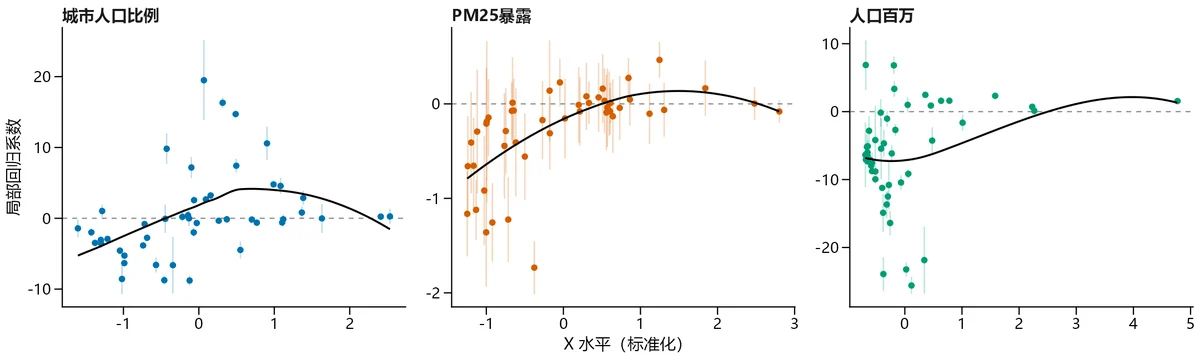
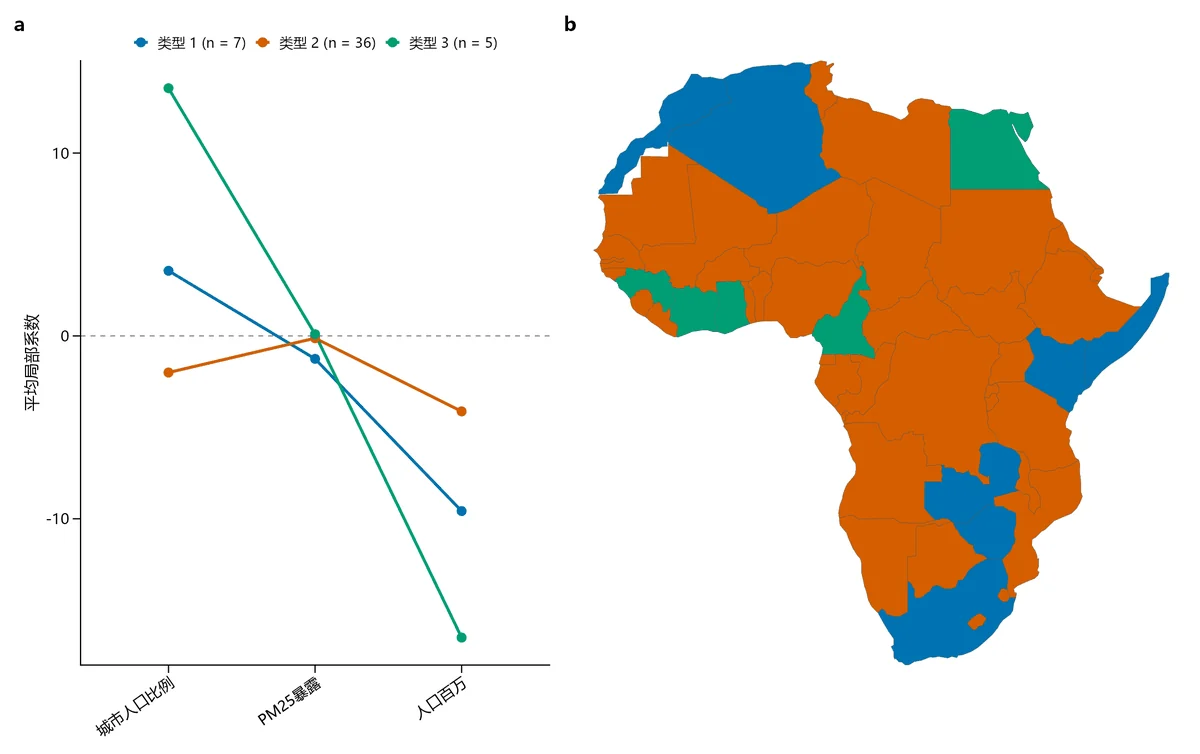
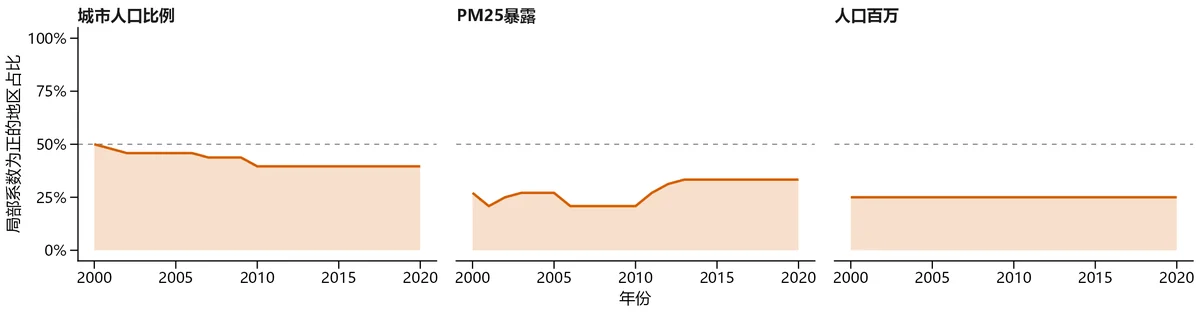
全部进阶图(中文 / 英文,PNG + PDF)在案例文件夹的 Case-01-Continuous-Africa-U5MR\visualization\outputs\zh 或 en\local_coef_module\。
14.2 案例 2 · 中国新冠疫情发生状态
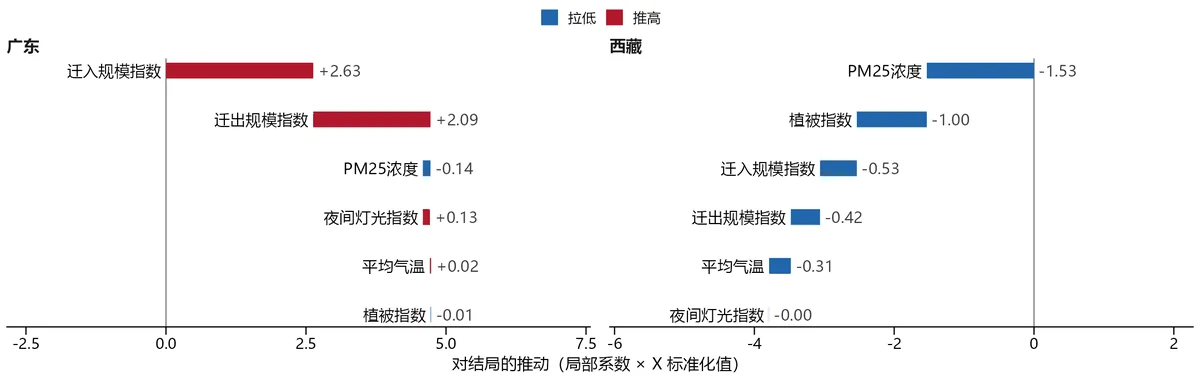
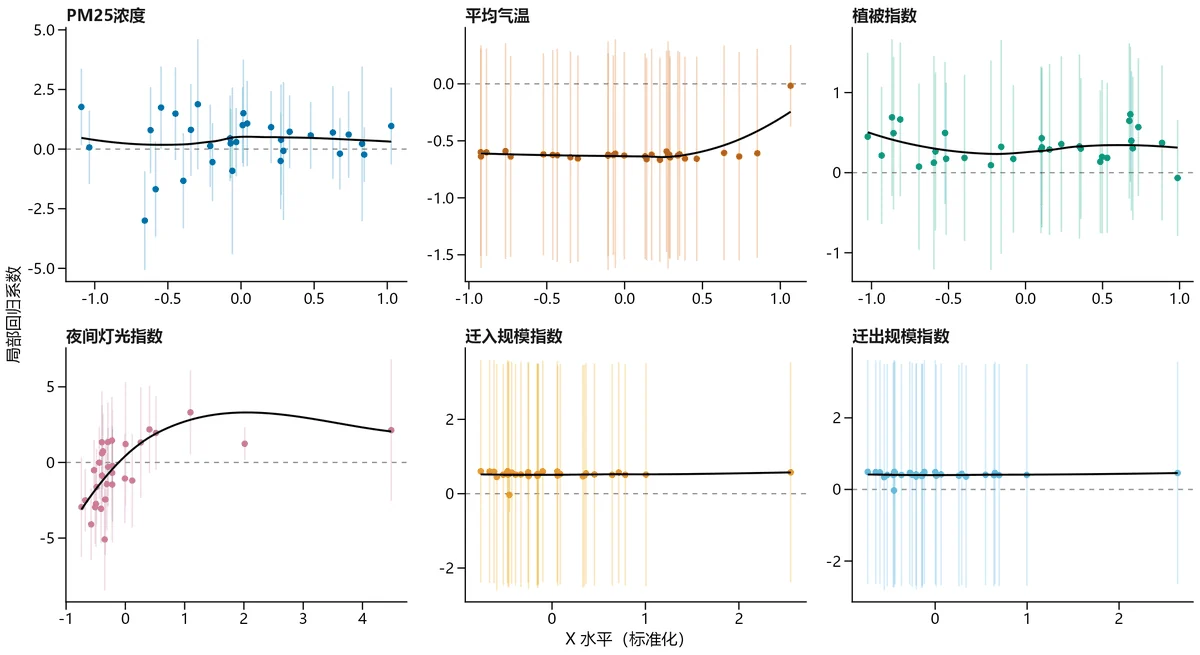
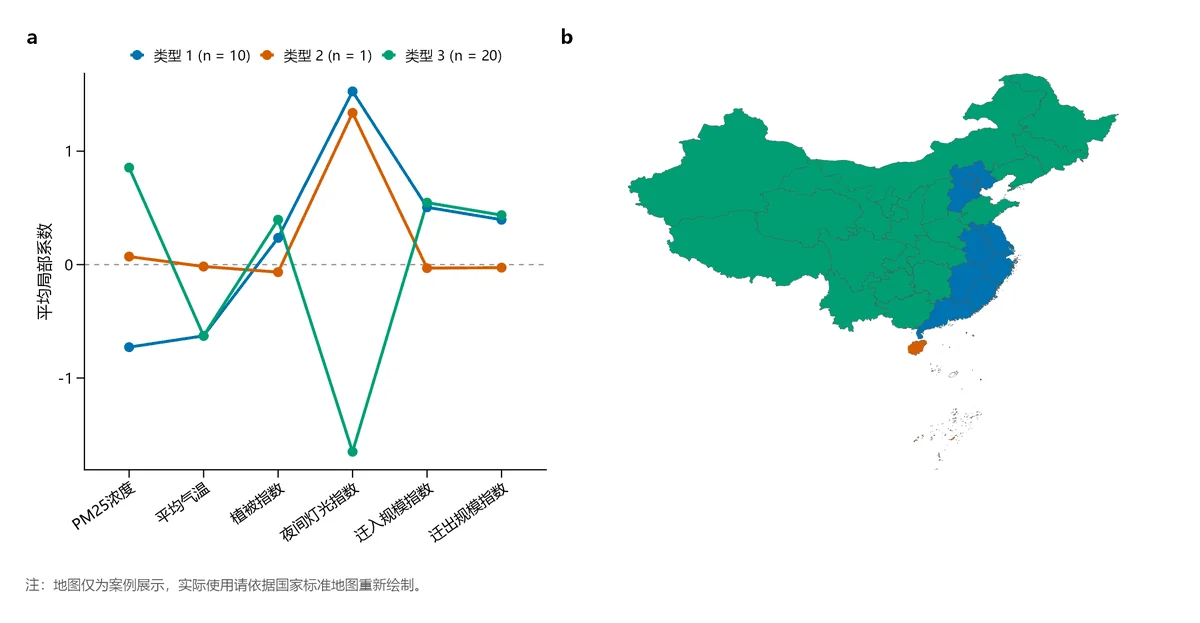
- 先看图 16 和图 10 找主角,再看图 12、图 20 落到具体地区,最后用图 15 给地区分类型。
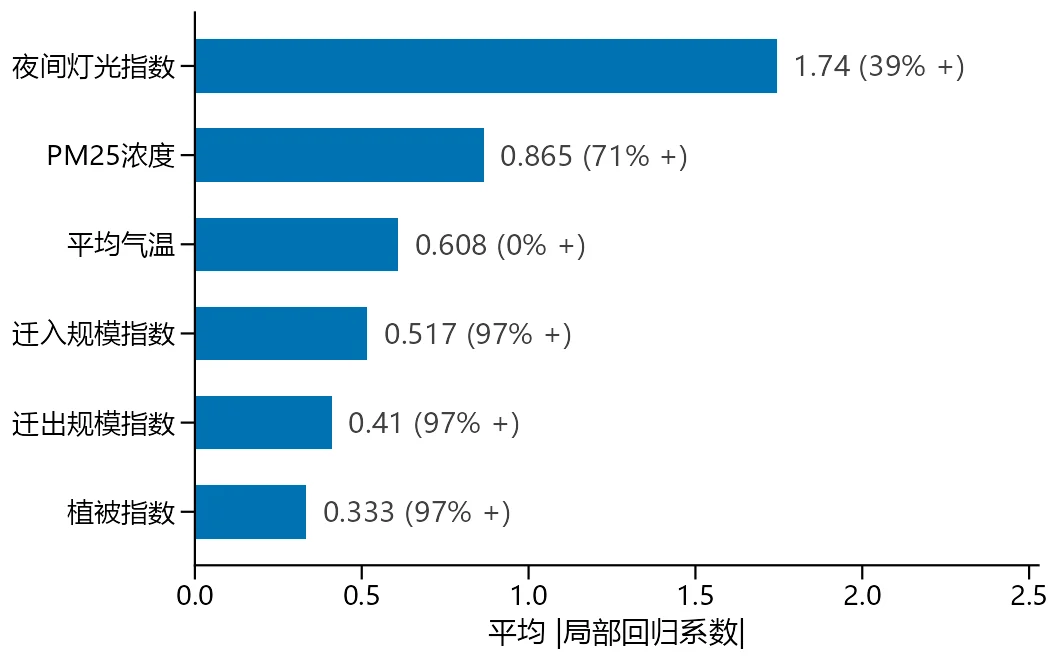
- 平均作用强度从强到弱:夜间灯光指数(1.74,正向地区 39%) > PM25浓度(0.865,正向地区 71%) > 平均气温(0.608,正向地区 0%) > 迁入规模指数(0.517,正向地区 97%) > 迁出规模指数(0.41,正向地区 97%)……。
- 作用方向因地而异(正向地区占 20%–80%)的因素:夜间灯光指数、PM25浓度——这些因素最适合看图 16、图 20,按地区分别施策。
- 方向在大多数地区一致的因素:平均气温、迁入规模指数、迁出规模指数、植被指数。
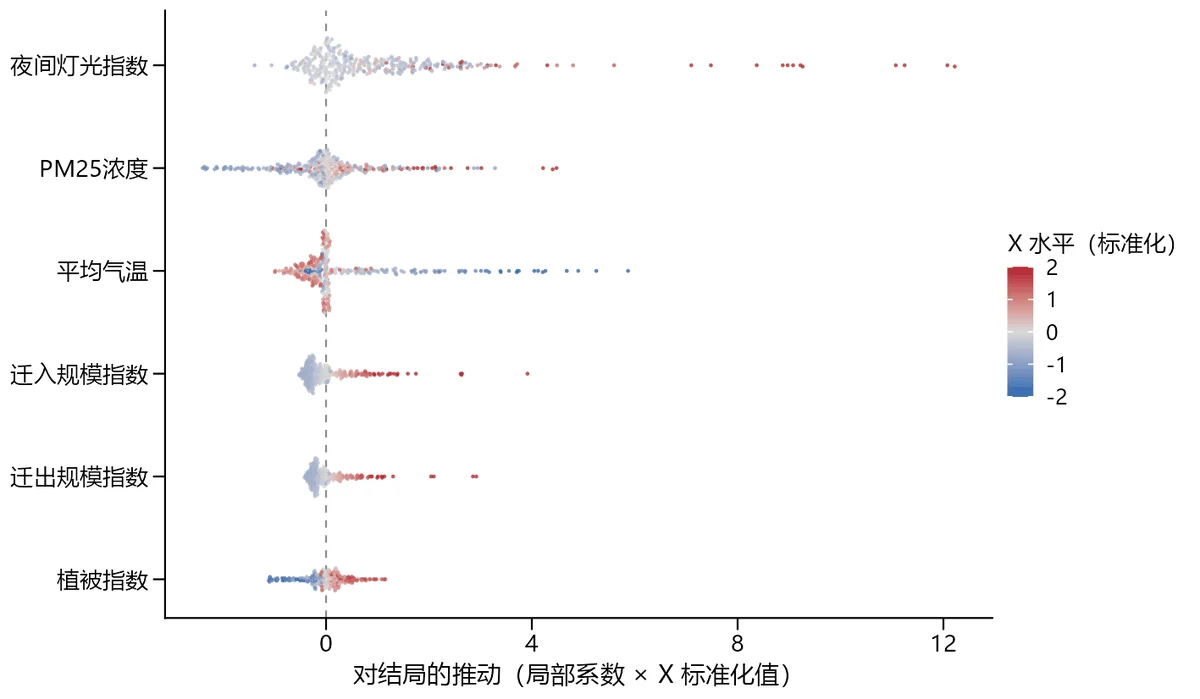
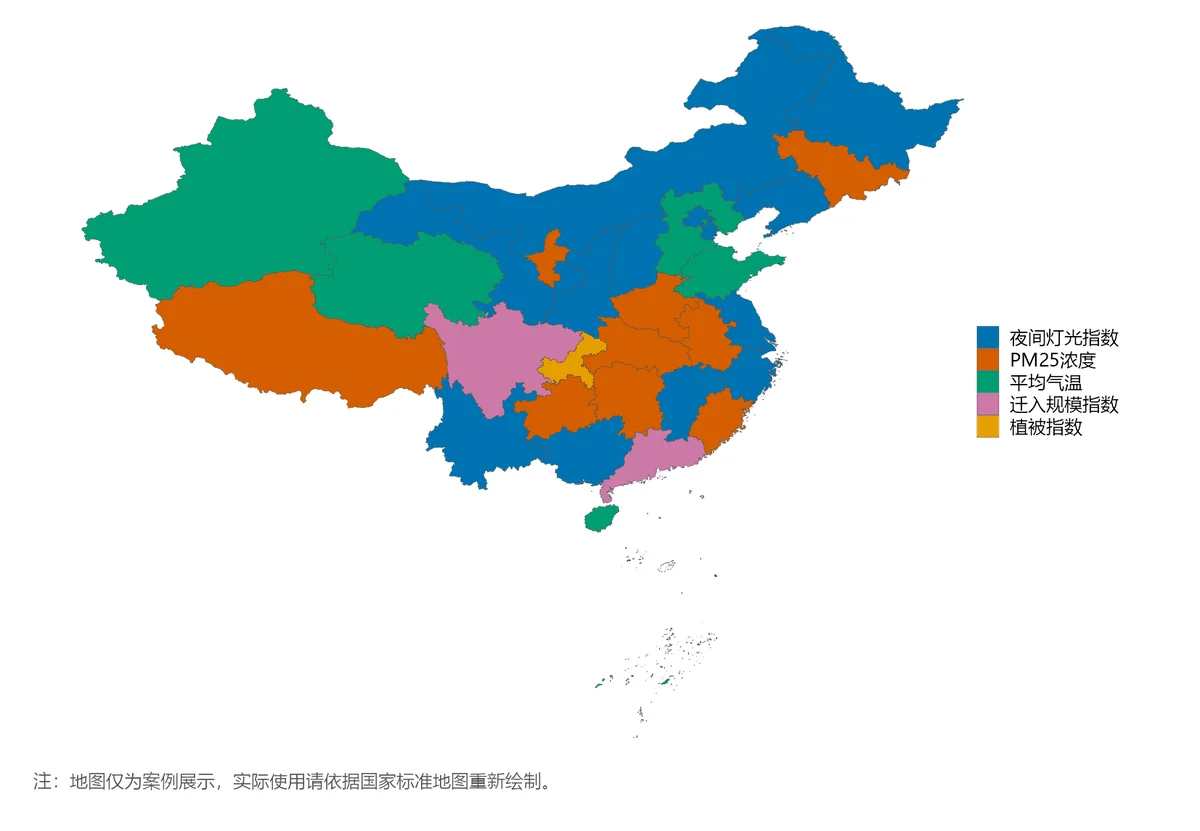
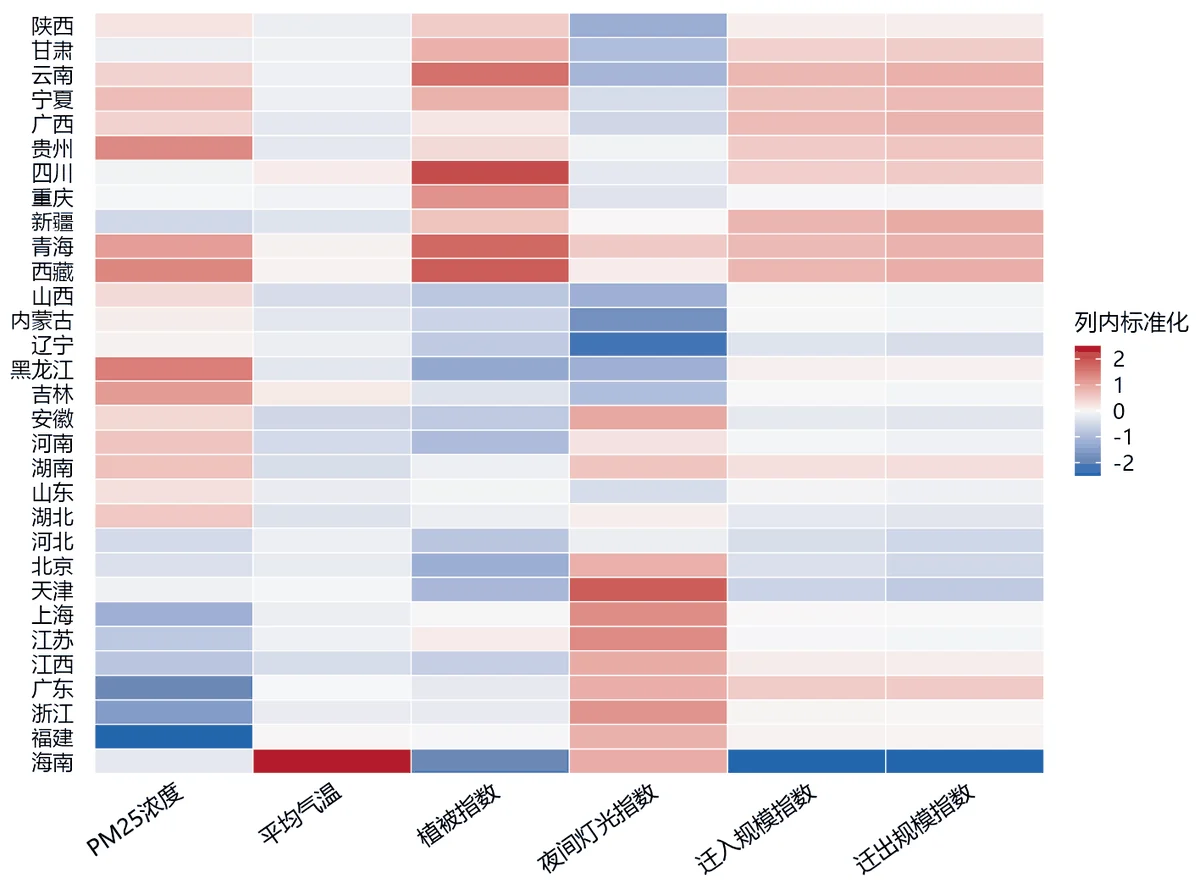
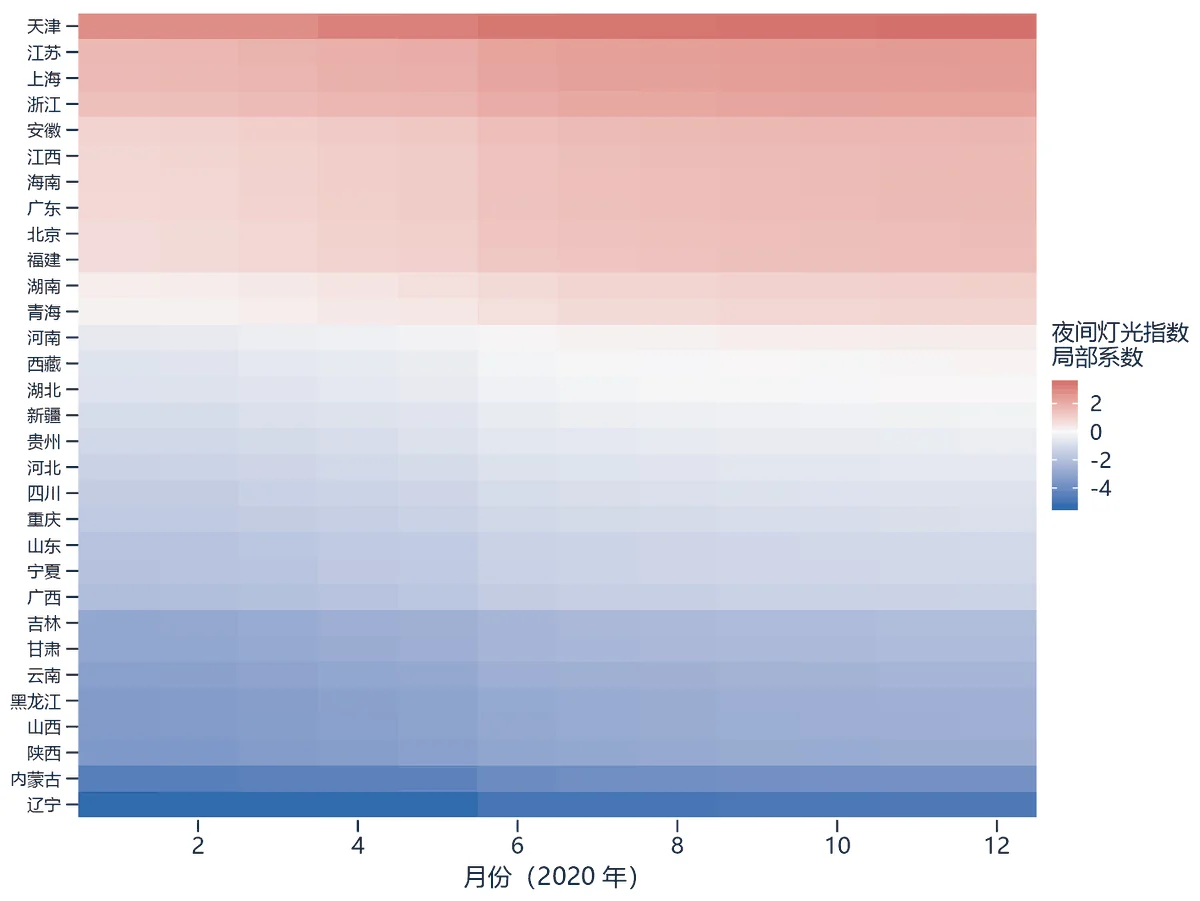
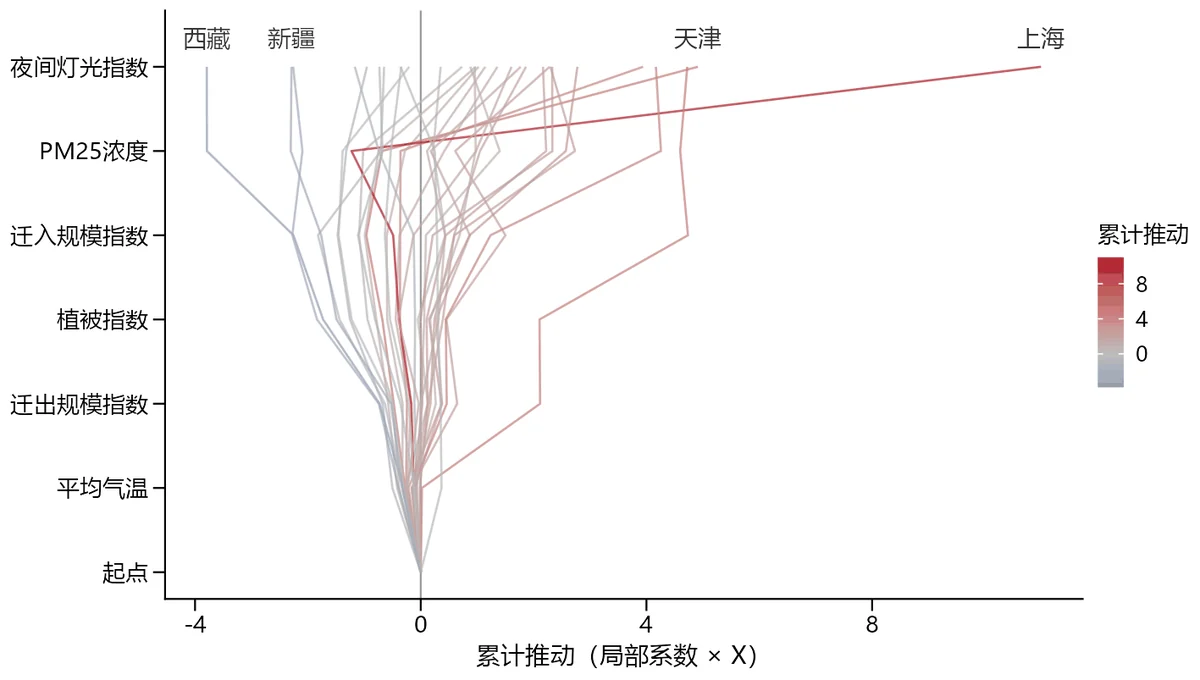
全部进阶图(中文 / 英文,PNG + PDF)在案例文件夹的 Case-02-Binary-China-COVID-19\visualization\outputs\zh 或 en\local_coef_module\。
14.3 案例 3 · 美国急性乙型肝炎
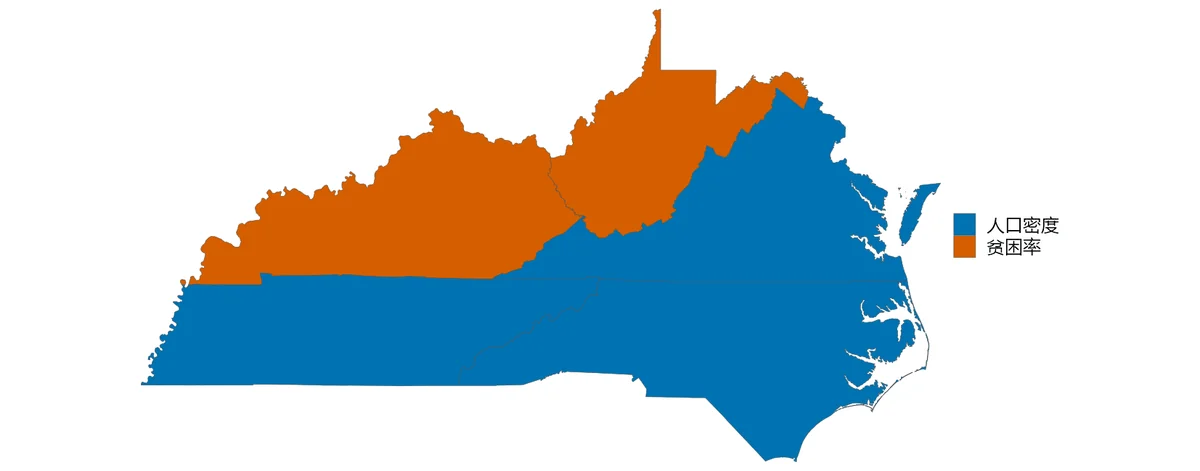
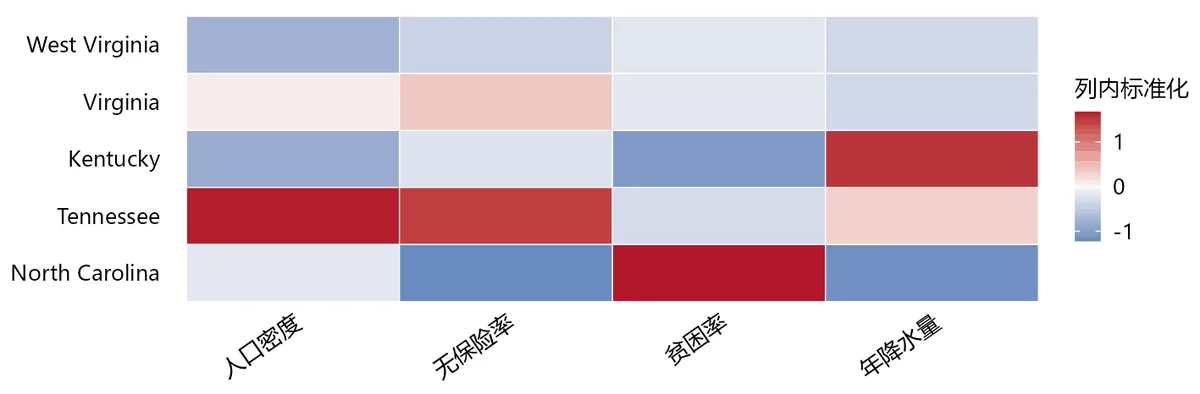
- 先看图 16 和图 10 找主角,再看图 12、图 20 落到具体地区,最后用图 15 给地区分类型。
- 平均作用强度从强到弱:人口密度(9.42,正向地区 60%) > 贫困率(4.61,正向地区 100%) > 无保险率(1.34,正向地区 20%) > 年降水量(0.342,正向地区 20%)。
- 作用方向因地而异(正向地区占 20%–80%)的因素:人口密度、无保险率、年降水量——这些因素最适合看图 16、图 20,按地区分别施策。
- 方向在大多数地区一致的因素:贫困率。
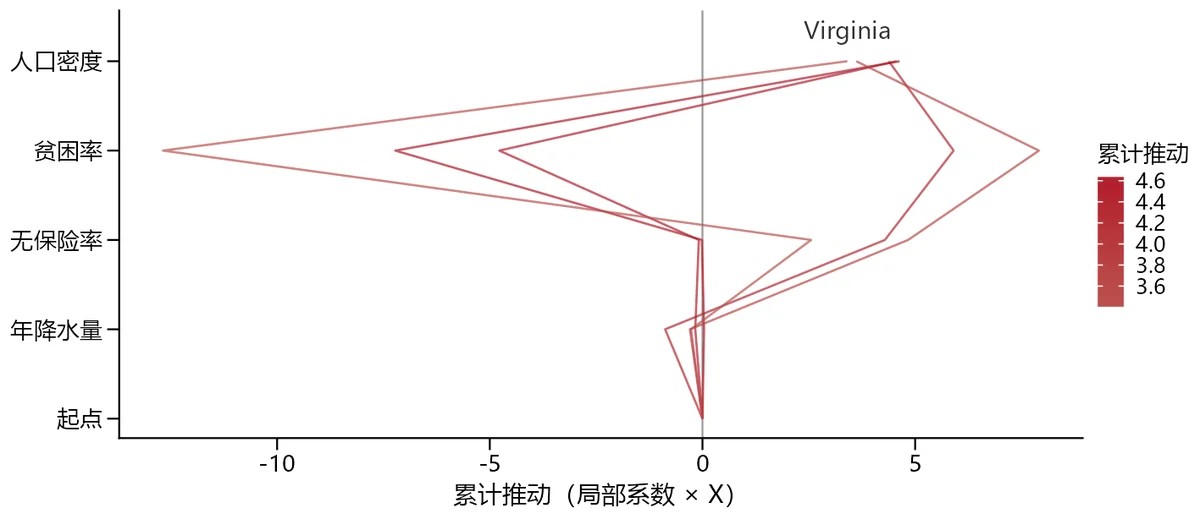
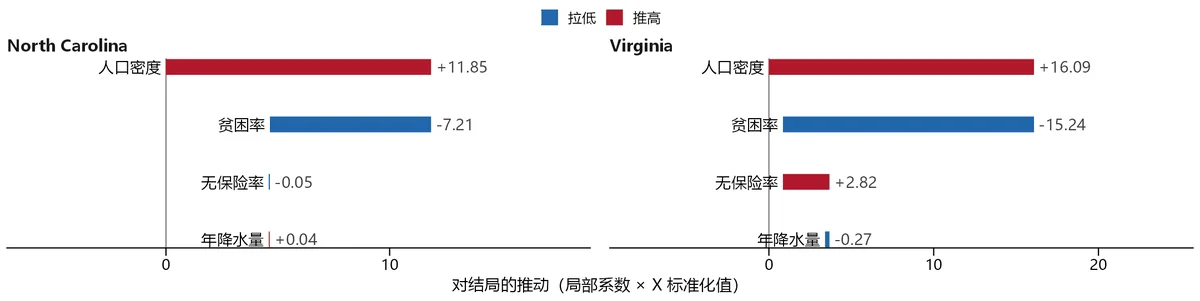
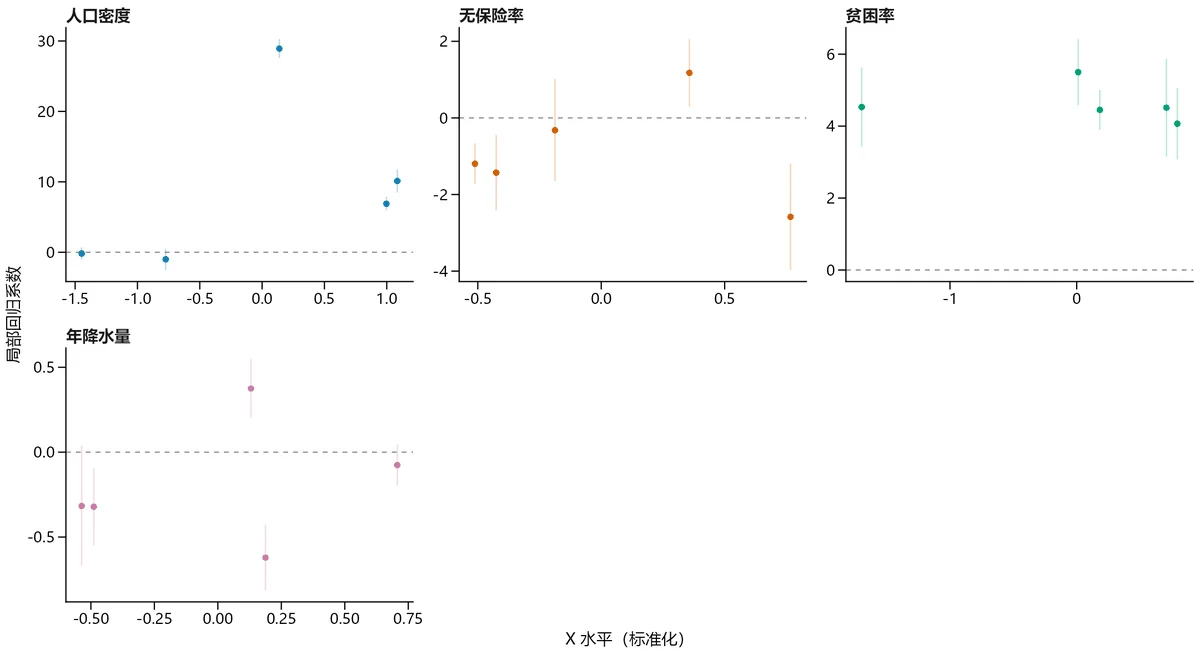
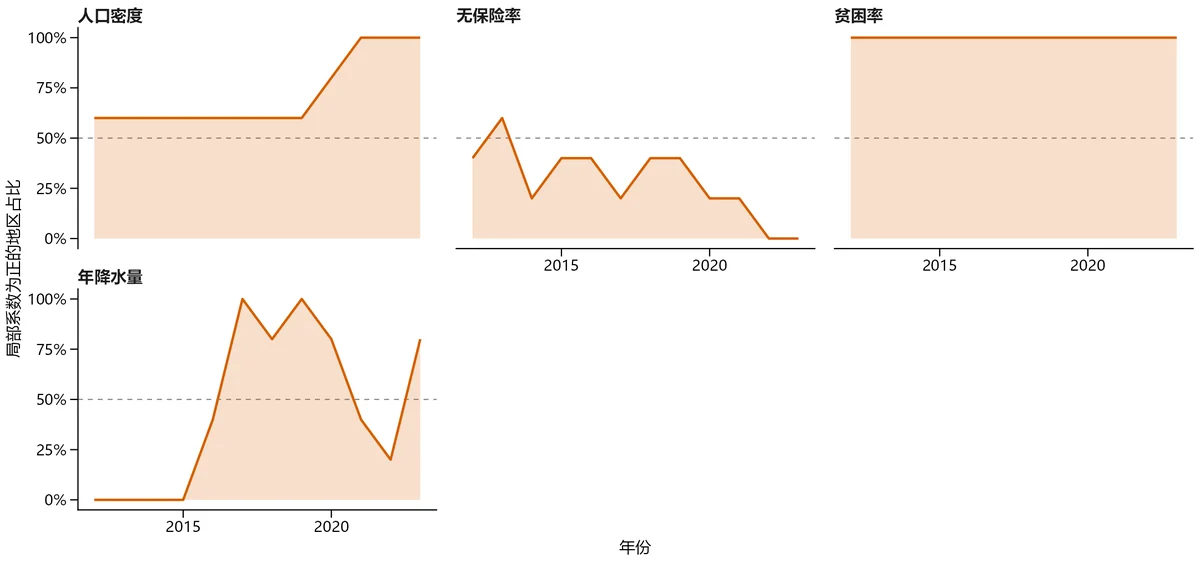
全部进阶图(中文 / 英文,PNG + PDF)在案例文件夹的 Case-03-Count-US-Hepatitis-B\visualization\outputs\zh 或 en\local_coef_module\。
14.4 案例 4a · 美国高自杀率状态
- 先看图 16 和图 10 找主角,再看图 12、图 20 落到具体地区,最后用图 15 给地区分类型。
- 平均作用强度从强到弱:人口百万(4.93,正向地区 8%) > 药物中毒年龄调整死亡率(1.99,正向地区 100%) > 家庭收入中位数千美元(1.57,正向地区 8%) > 贫困率(0.497,正向地区 63%)。
- 作用方向因地而异(正向地区占 20%–80%)的因素:贫困率——这些因素最适合看图 16、图 20,按地区分别施策。
- 方向在大多数地区一致的因素:人口百万、药物中毒年龄调整死亡率、家庭收入中位数千美元。
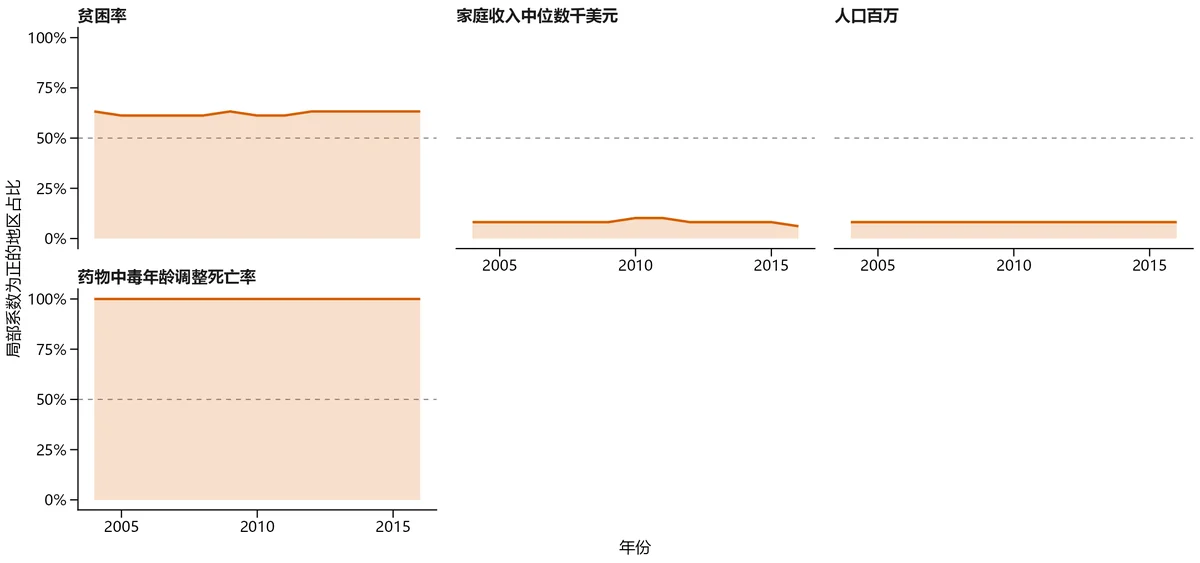
全部进阶图(中文 / 英文,PNG + PDF)在案例文件夹的 Case-04-US-Suicide-Binary-and-Count\visualization\outputs\zh 或 en\local_coef_module\。
14.5 案例 4b · 美国自杀死亡数
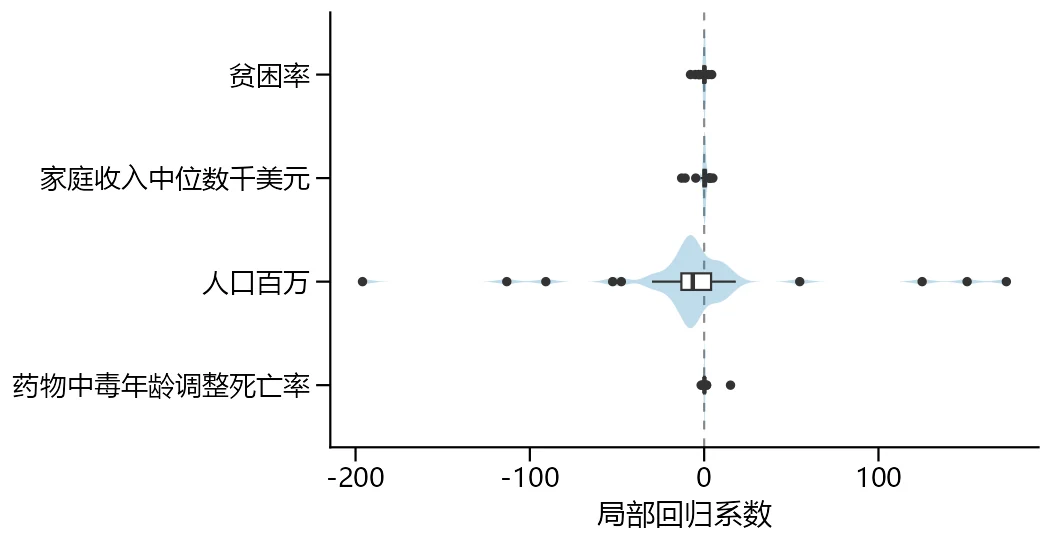
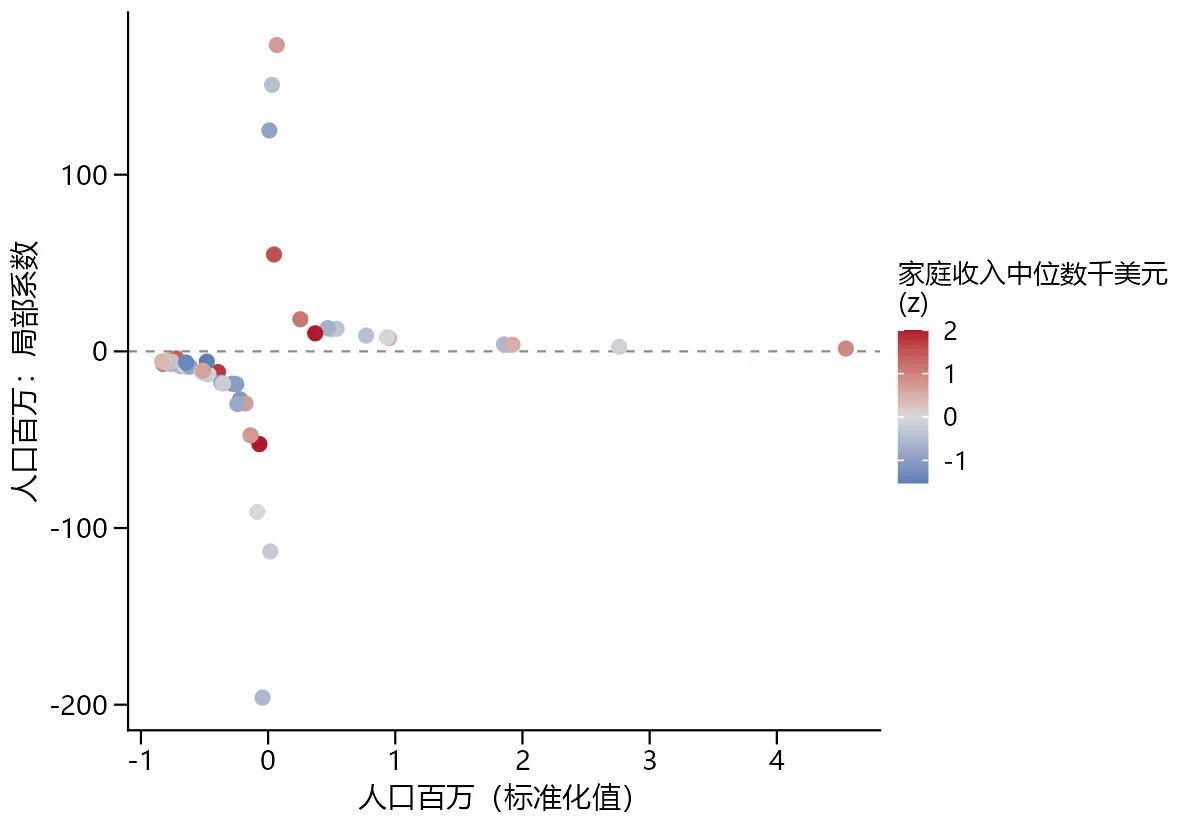
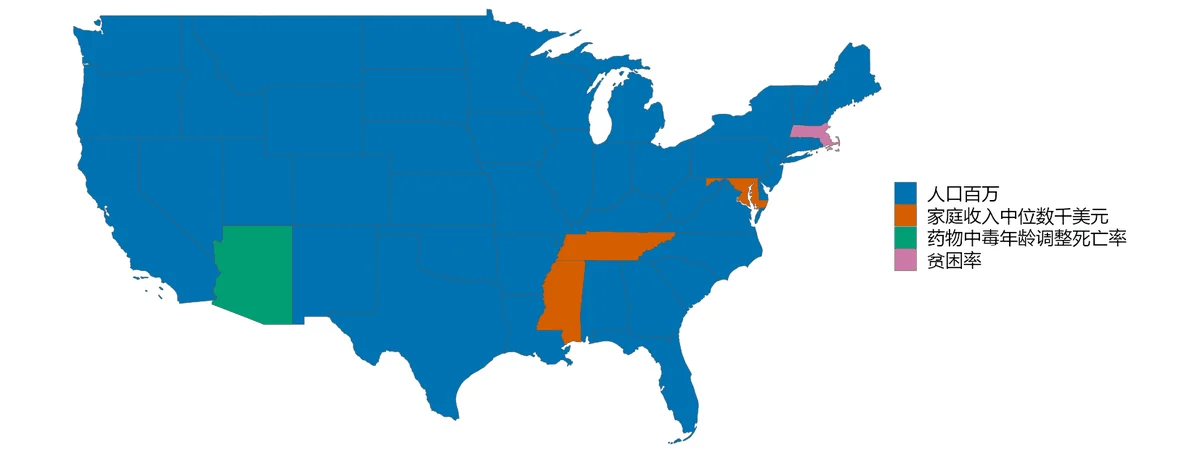
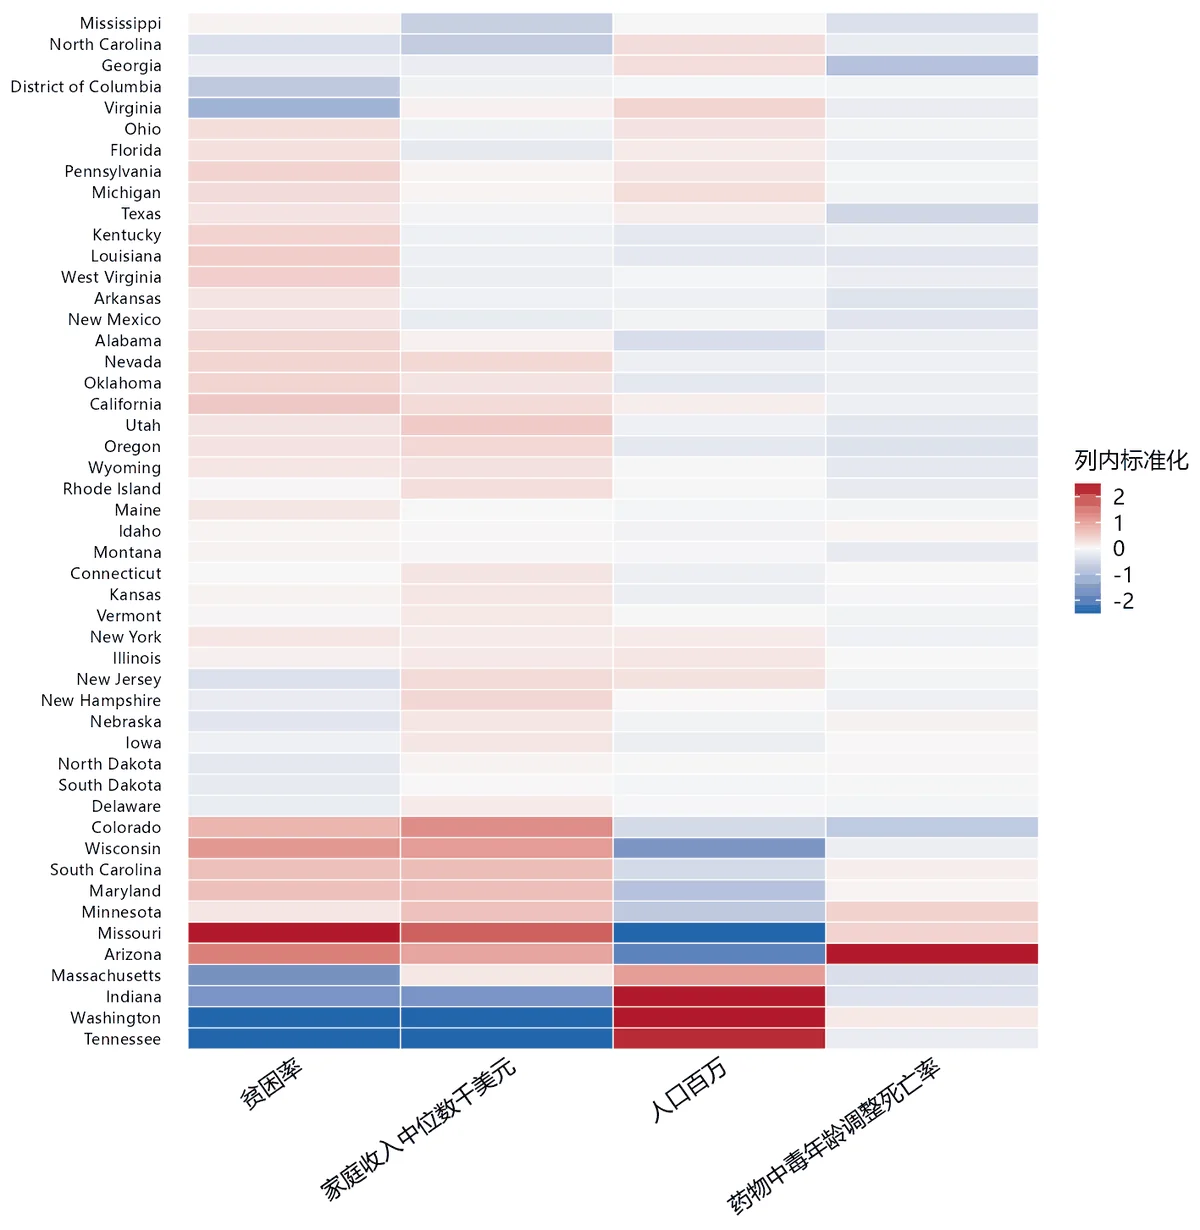
- 先看图 16 和图 10 找主角,再看图 12、图 20 落到具体地区,最后用图 15 给地区分类型。
- 平均作用强度从强到弱:人口百万(29.3,正向地区 33%) > 家庭收入中位数千美元(1.44,正向地区 61%) > 贫困率(1,正向地区 53%) > 药物中毒年龄调整死亡率(0.669,正向地区 69%)。
- 作用方向因地而异(正向地区占 20%–80%)的因素:人口百万、家庭收入中位数千美元、贫困率、药物中毒年龄调整死亡率——这些因素最适合看图 16、图 20,按地区分别施策。
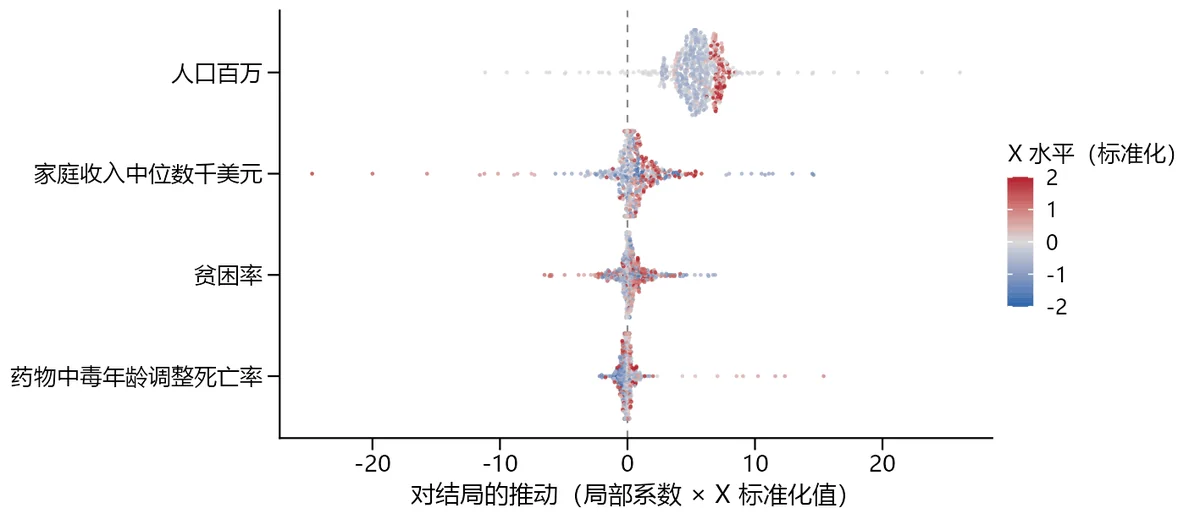
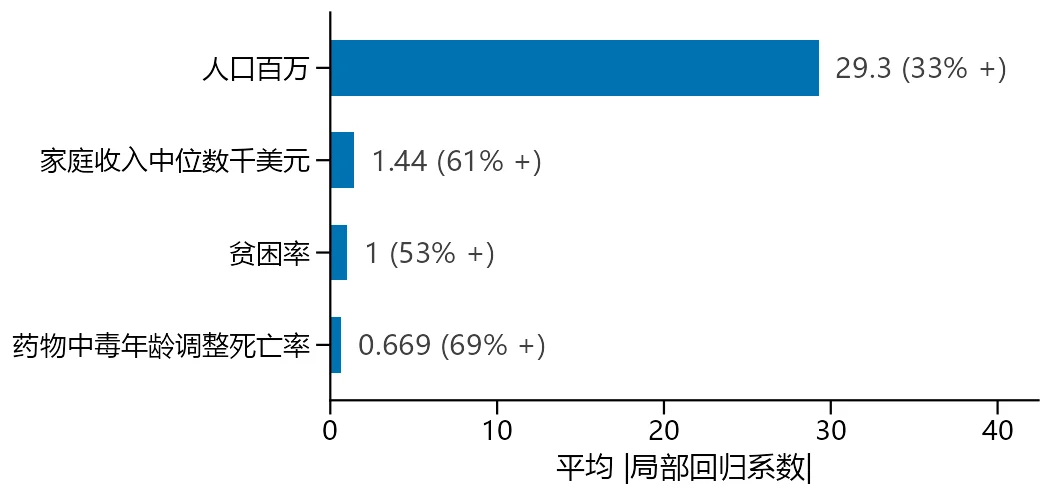
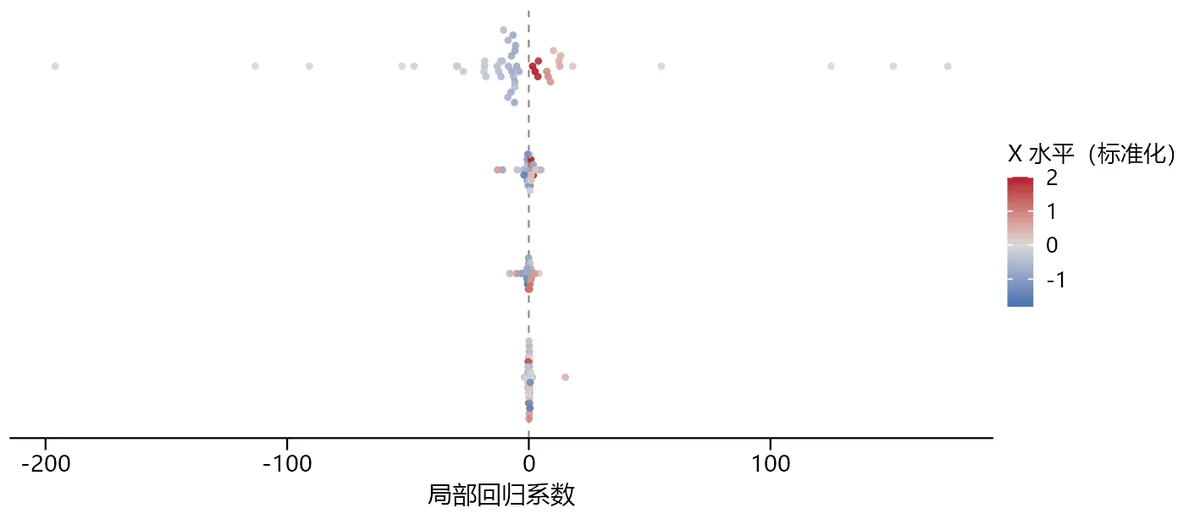
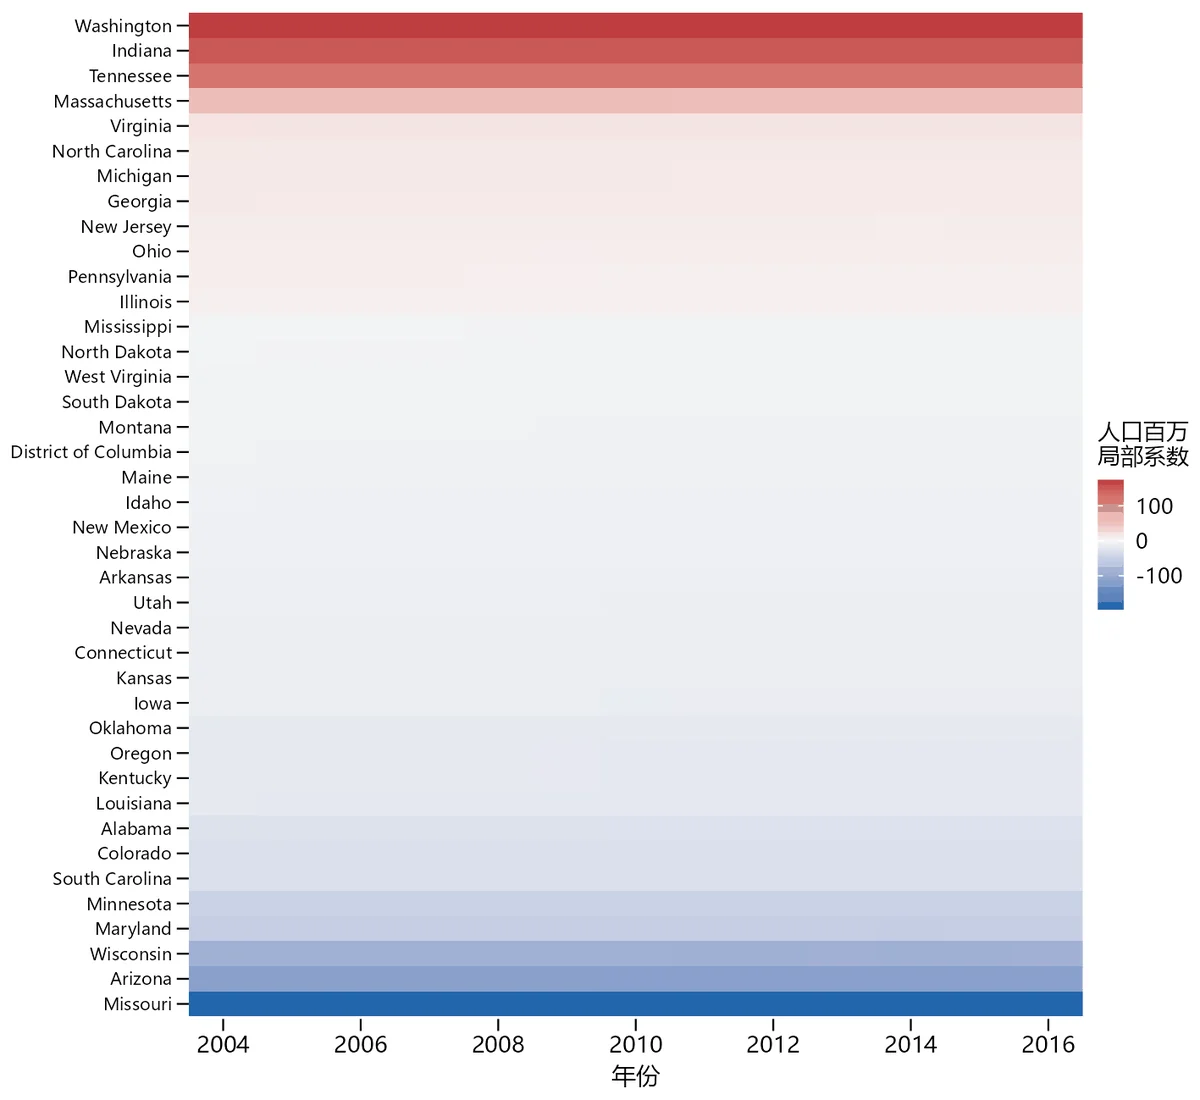
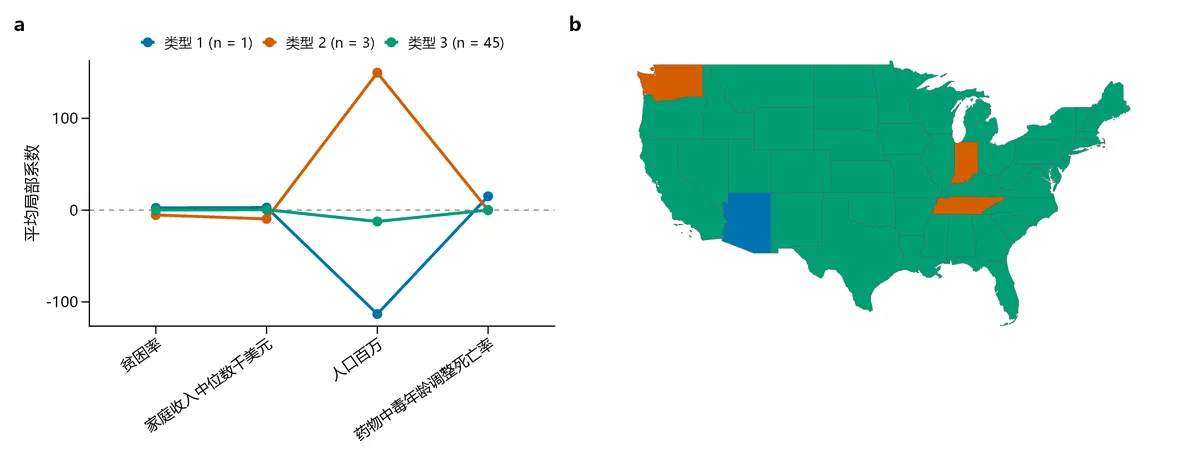
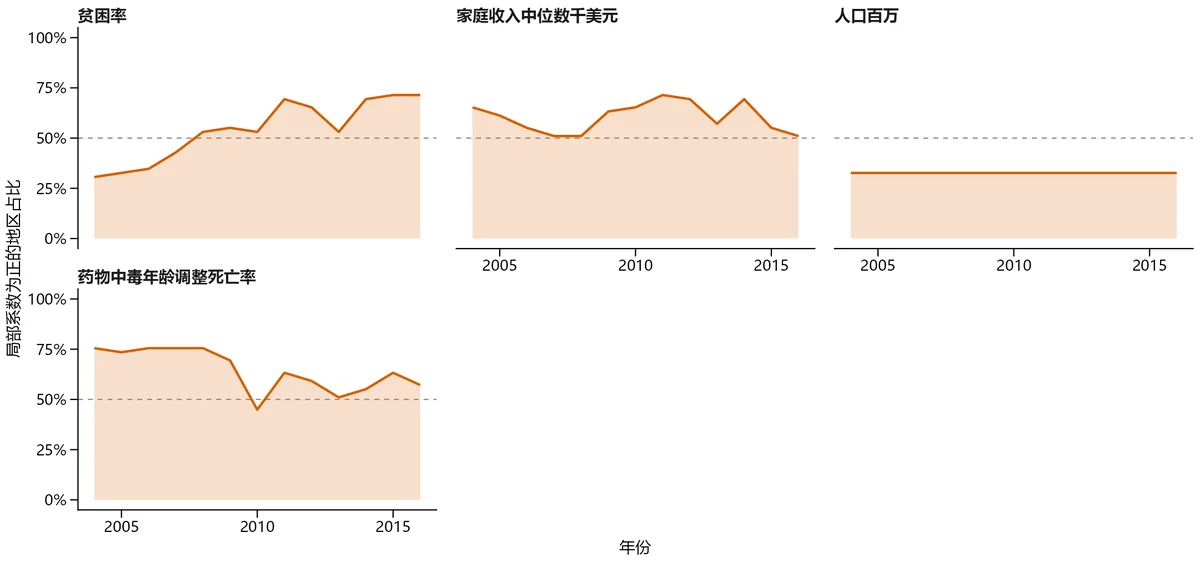
全部进阶图(中文 / 英文,PNG + PDF)在案例文件夹的 Case-04-US-Suicide-Binary-and-Count\visualization\outputs\zh 或 en\local_coef_module\。
14.6 案例 5 · 美国 2016 年高自杀率(BSVC)
- 先看图 16 和图 10 找主角,再看图 12、图 20 落到具体地区,最后用图 15 给地区分类型。
- 平均作用强度从强到弱:人口百万(2.42,正向地区 0%) > 家庭收入中位数千美元(2.34,正向地区 0%) > 贫困率(1.39,正向地区 0%) > 药物中毒年龄调整死亡率(0.344,正向地区 100%)。
- 方向在大多数地区一致的因素:人口百万、家庭收入中位数千美元、贫困率、药物中毒年龄调整死亡率。
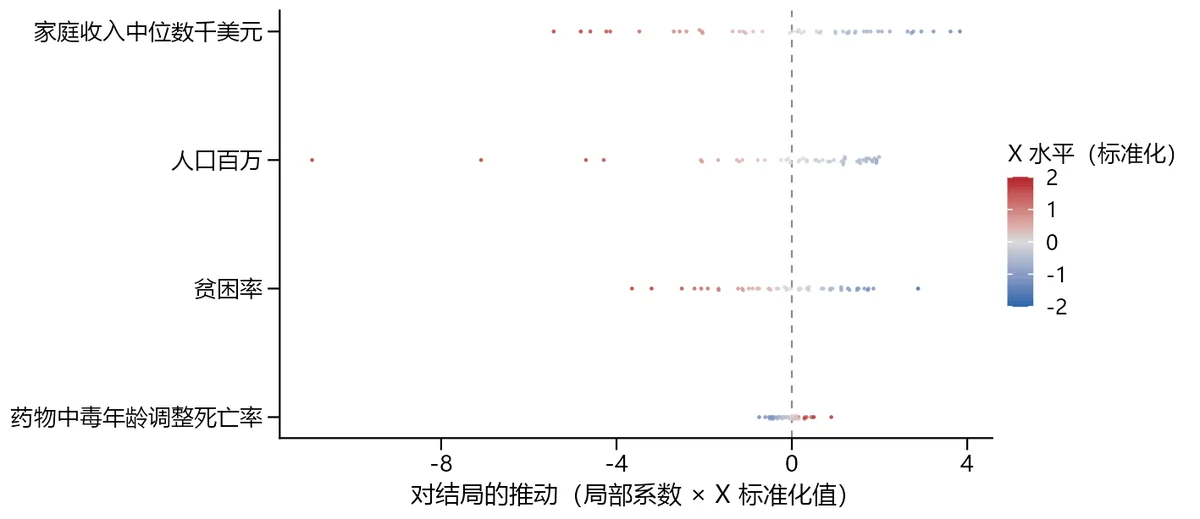
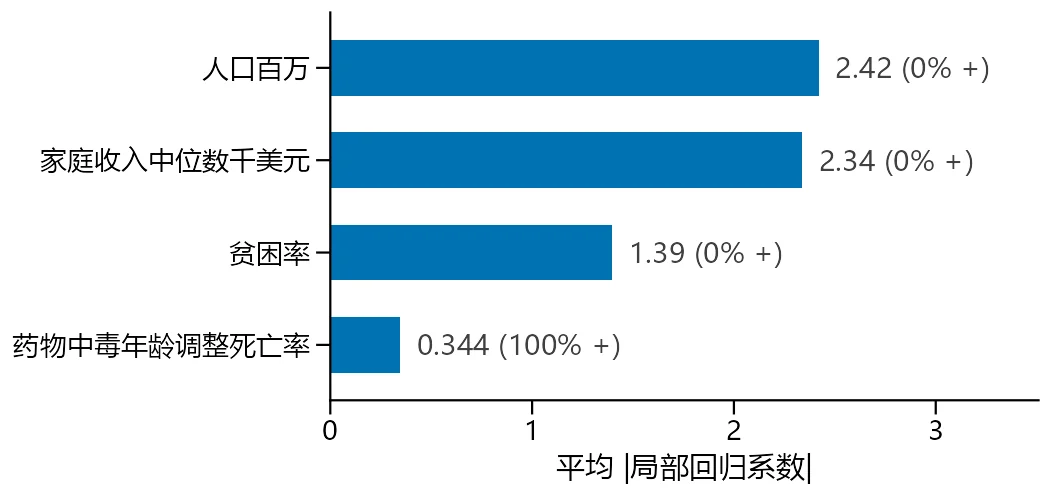
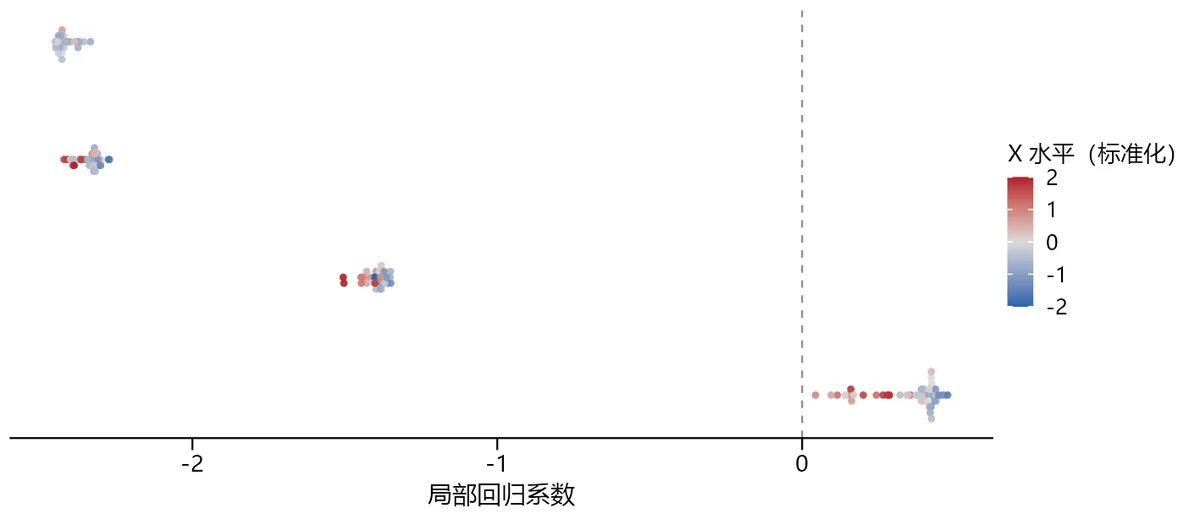
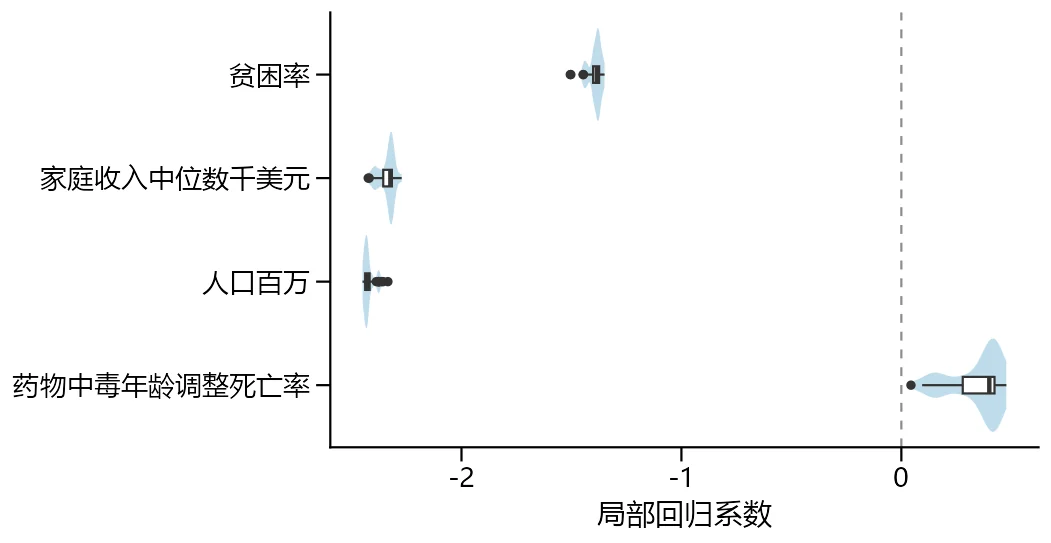
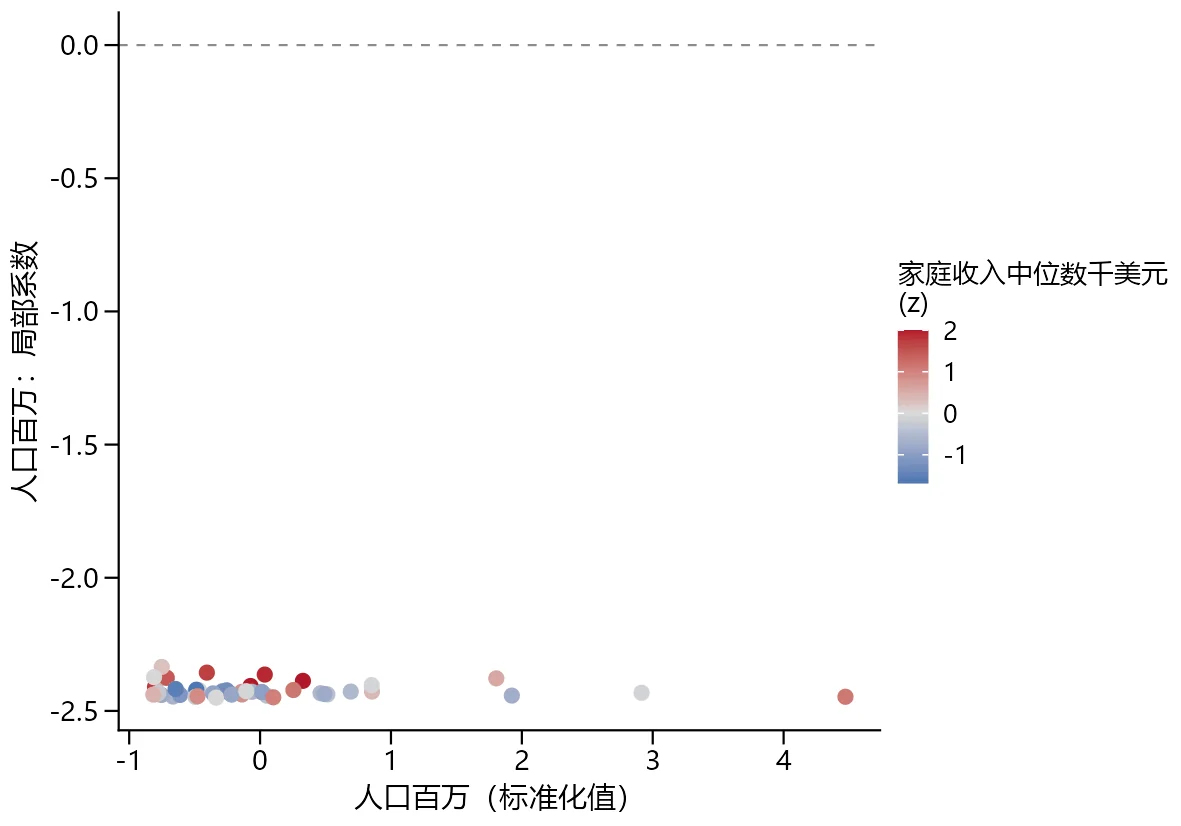
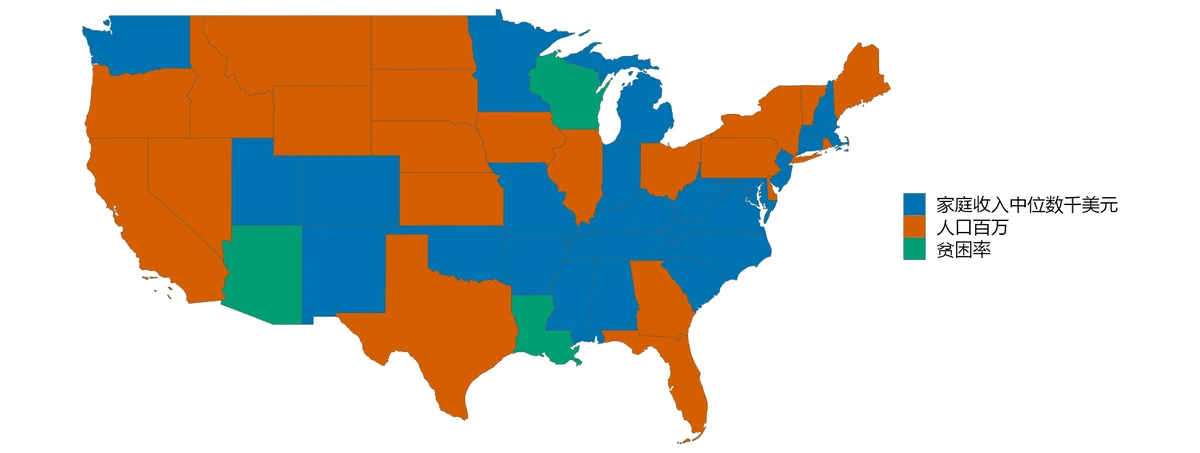
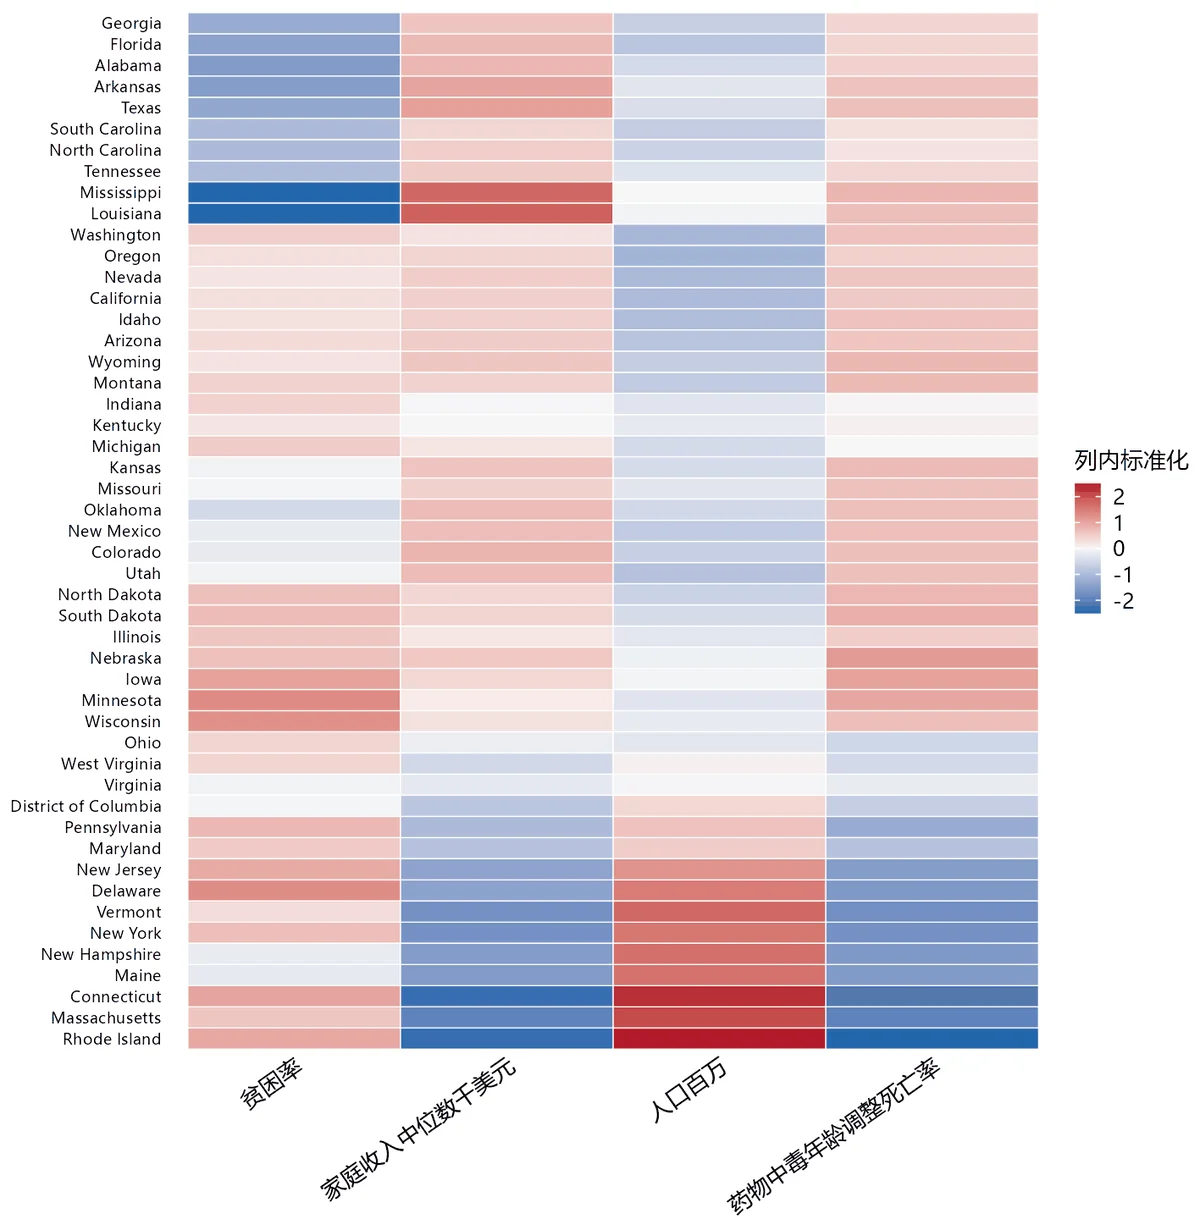
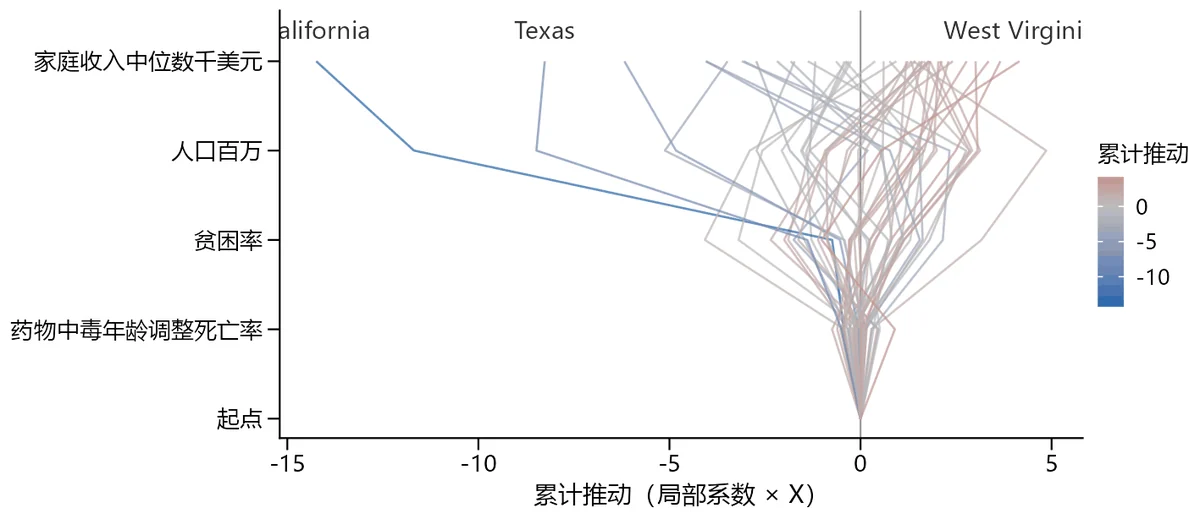
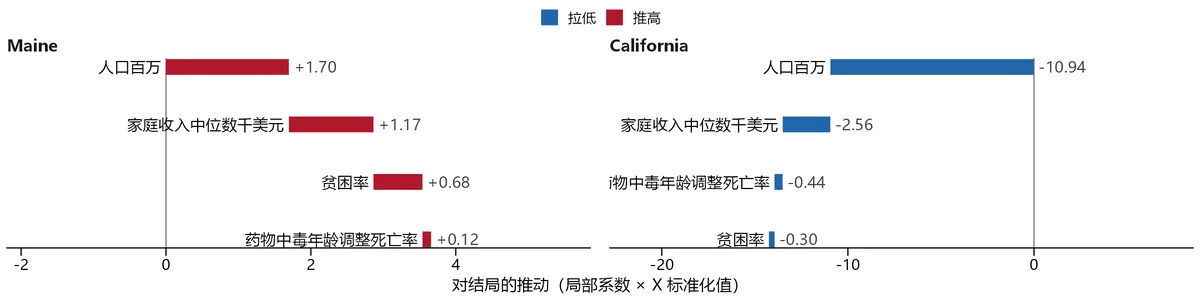
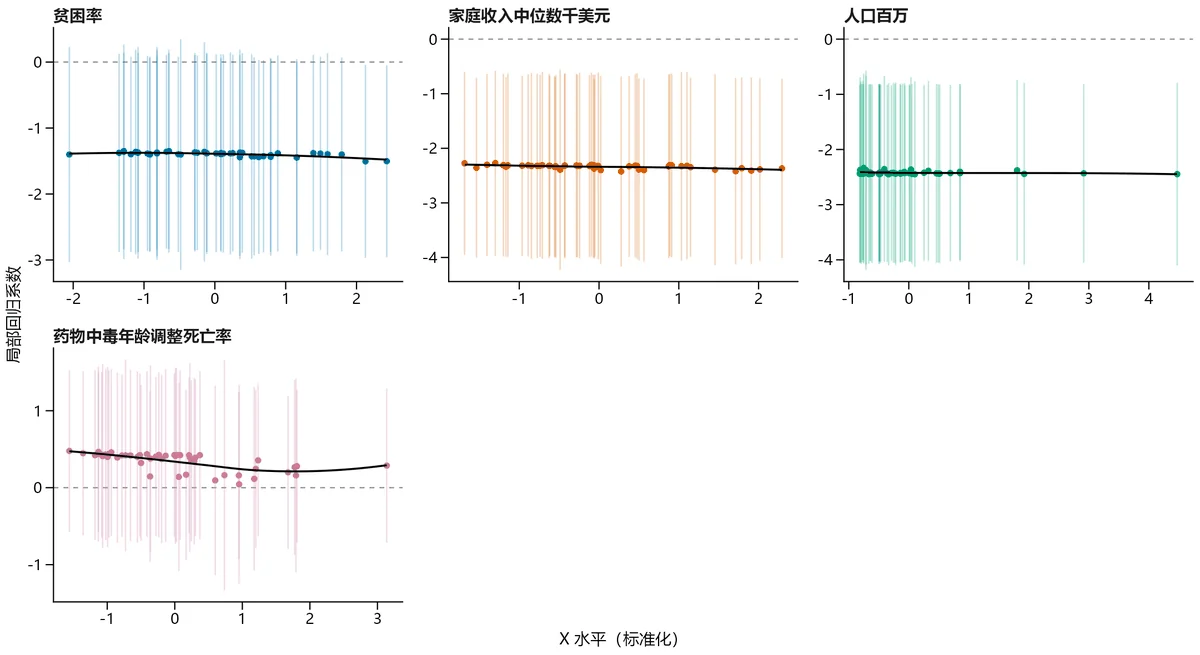
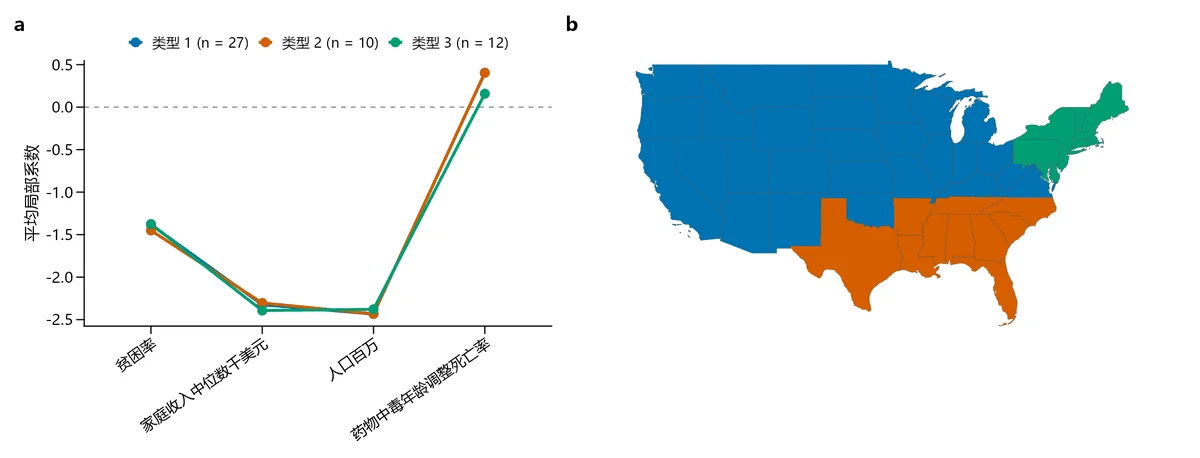
全部进阶图(中文 / 英文,PNG + PDF)在案例文件夹的 Case-05-BSVC-US-Suicide-2016\visualization\outputs\zh 或 en\local_coef_module\。
14.7 案例 6 · 全球健康调整预期寿命
- 先看图 16 和图 10 找主角,再看图 12、图 20 落到具体地区,最后用图 15 给地区分类型。
- 平均作用强度从强到弱:人均国民收入(6.35,正向地区 21%) > 高酒精使用(1.26,正向地区 21%) > 孕产妇死亡率(1.06,正向地区 27%) > 城市人口比例(0.943,正向地区 53%) > 高温暴露(0.756,正向地区 34%)……。
- 作用方向因地而异(正向地区占 20%–80%)的因素:人均国民收入、高酒精使用、孕产妇死亡率、城市人口比例、高温暴露——这些因素最适合看图 16、图 20,按地区分别施策。
- 方向在大多数地区一致的因素:归一化植被指数、女性就业人口比。
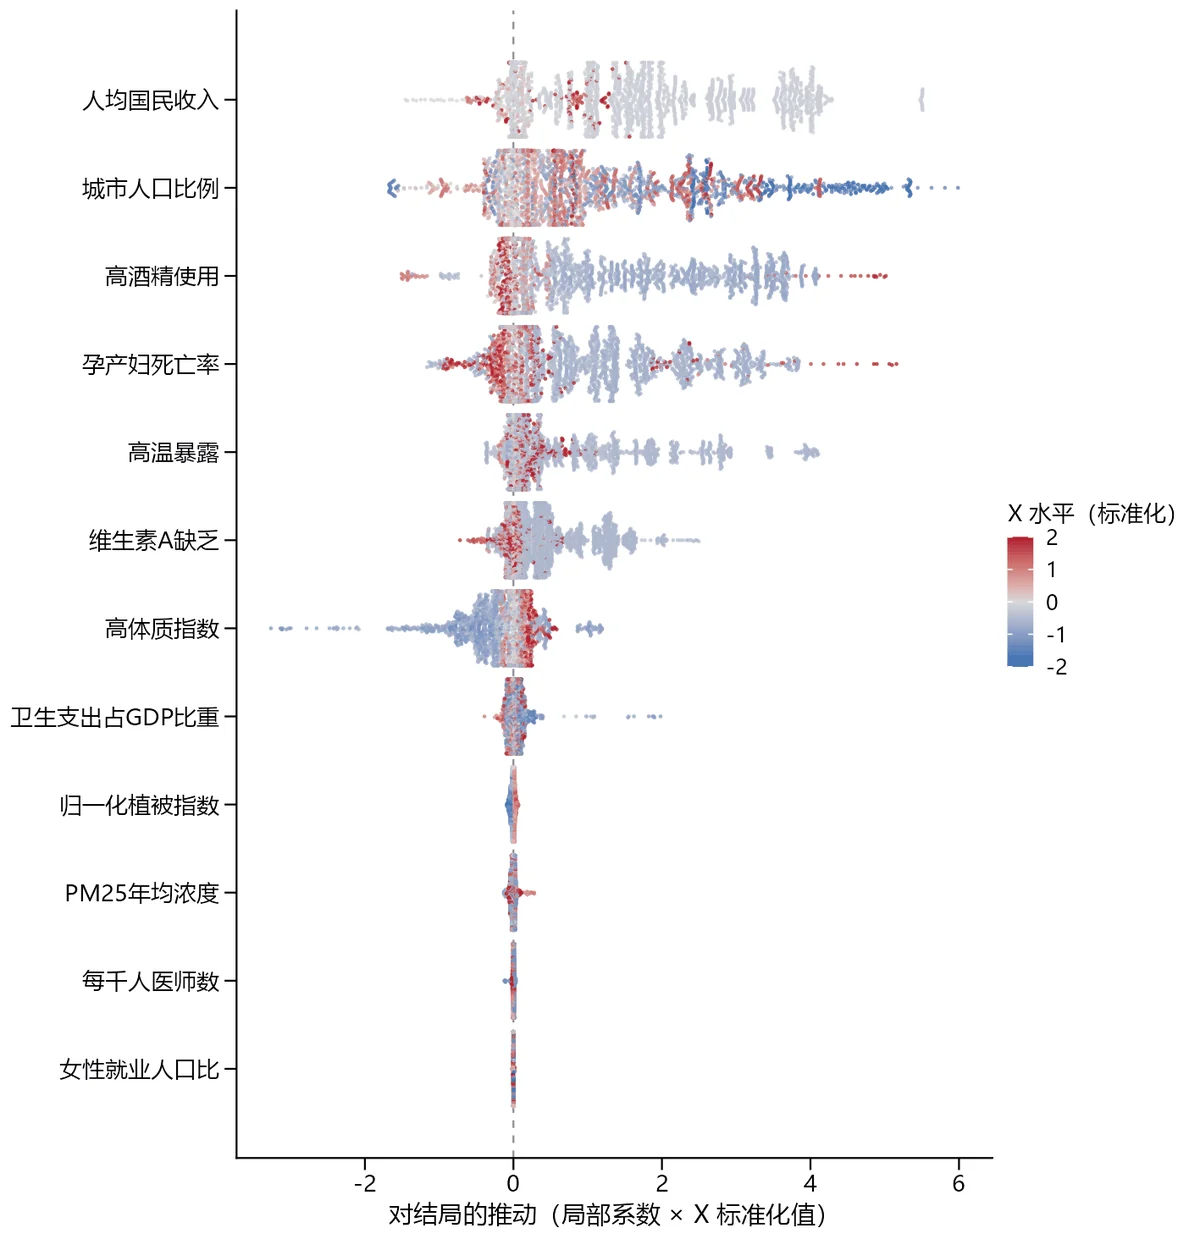
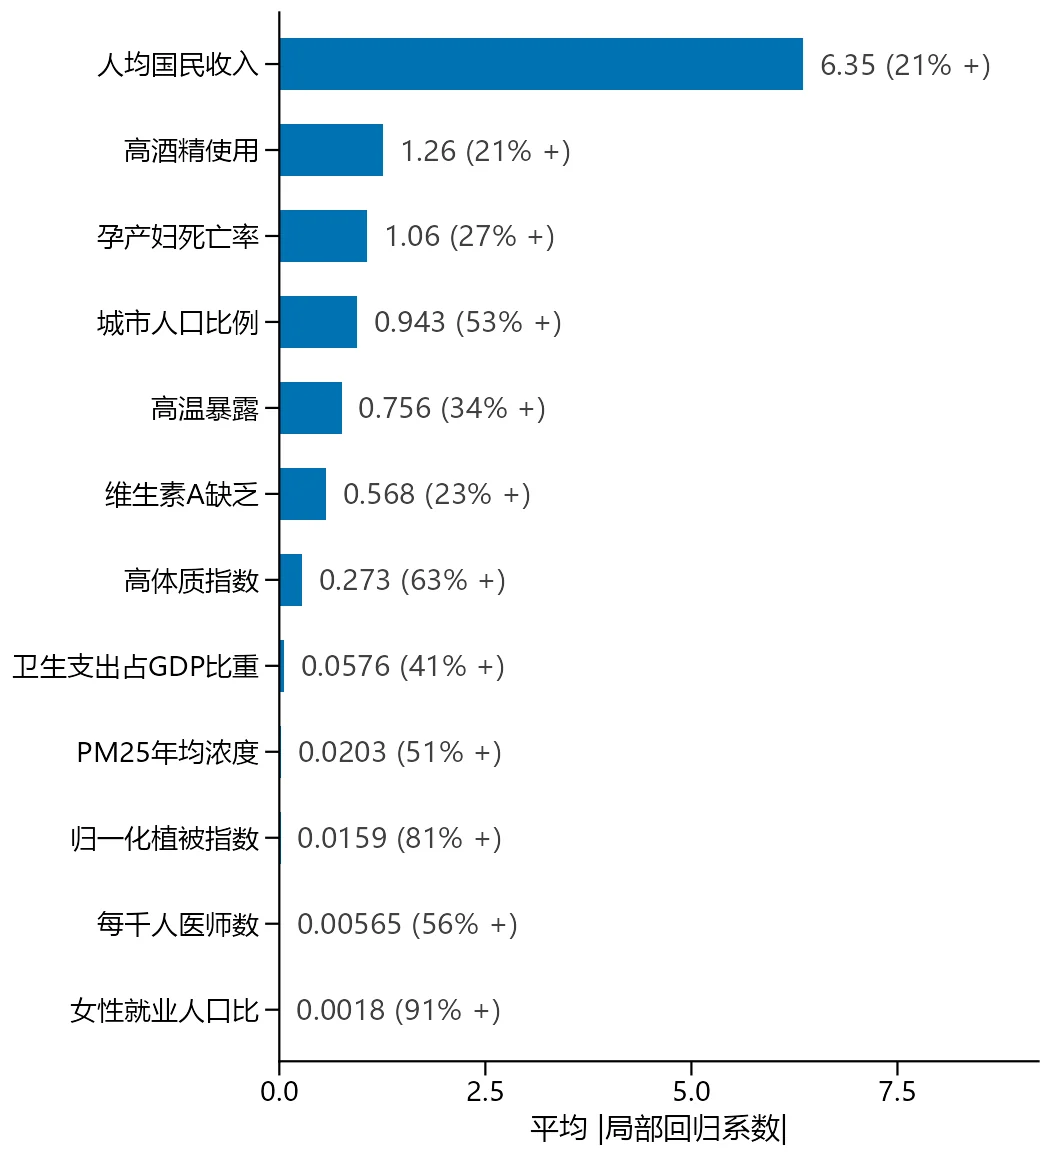
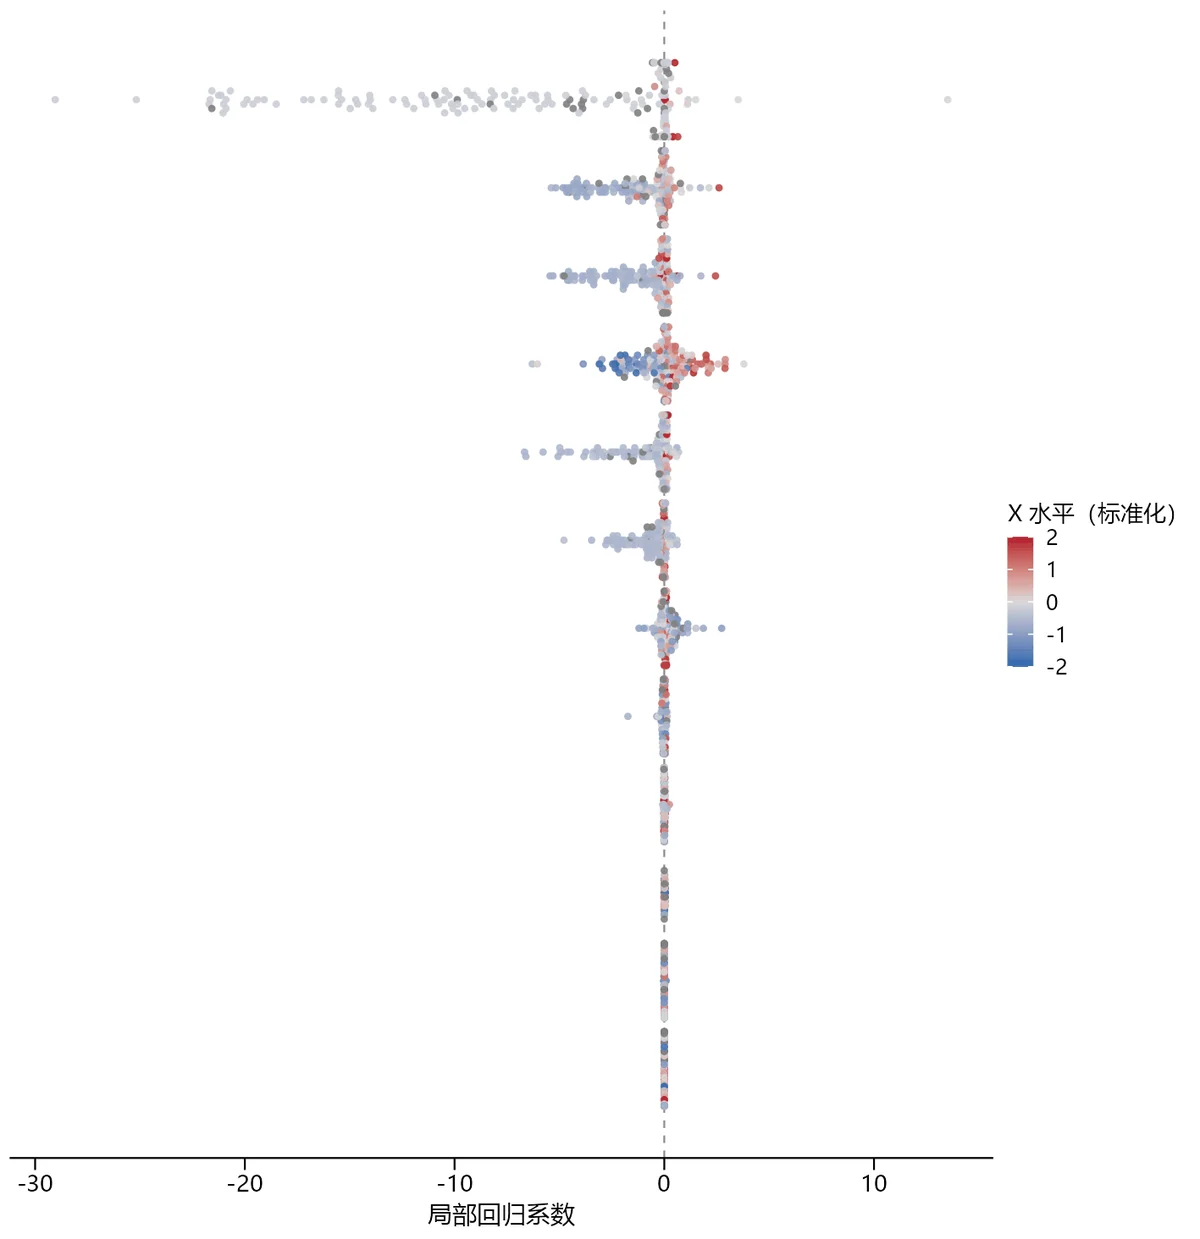
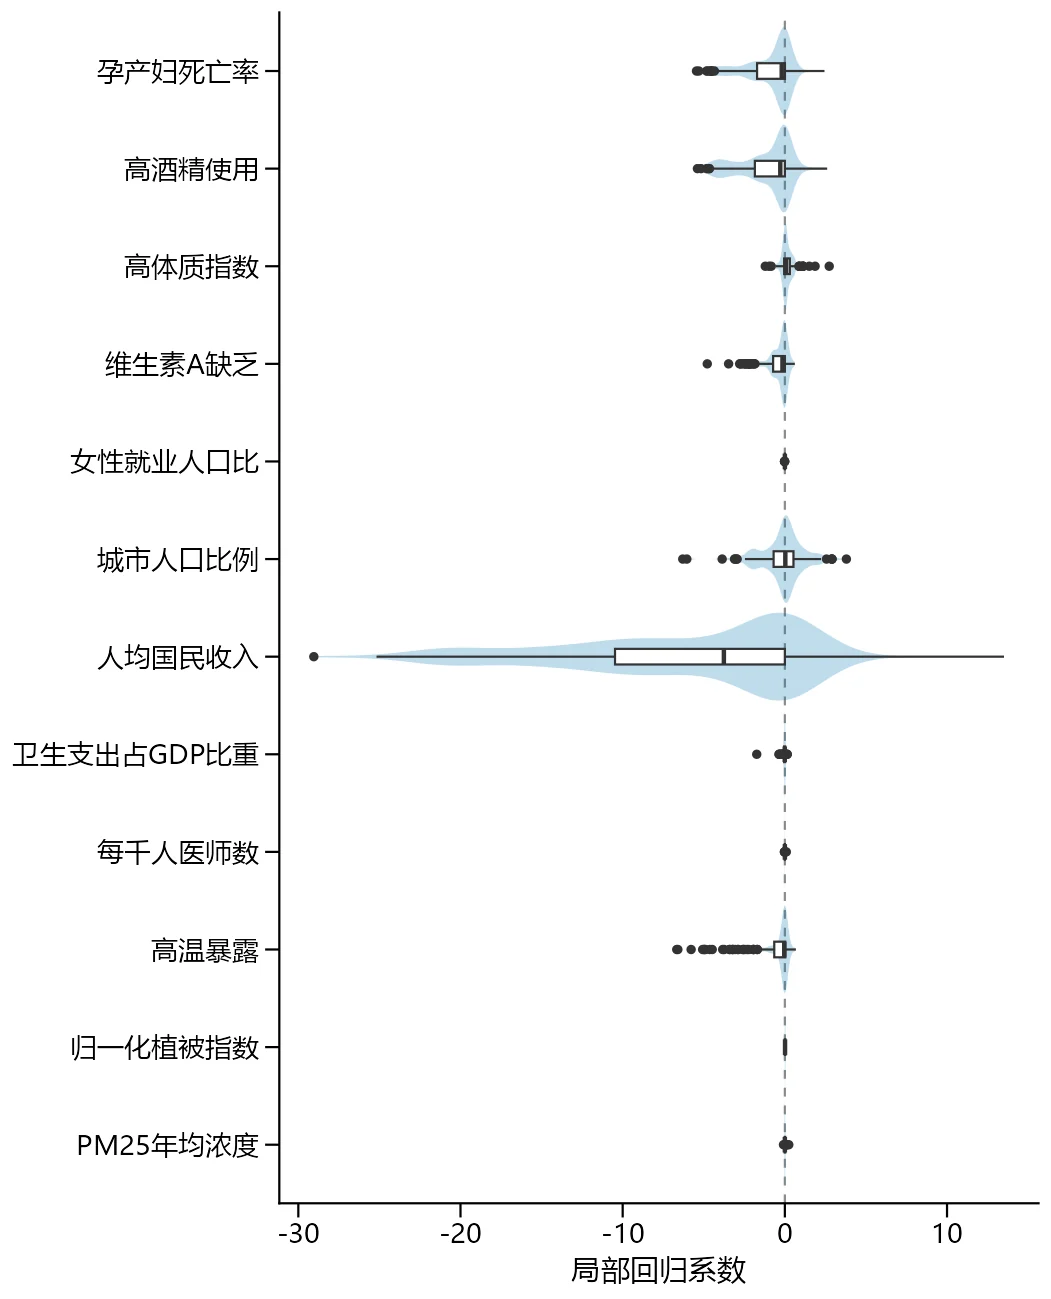
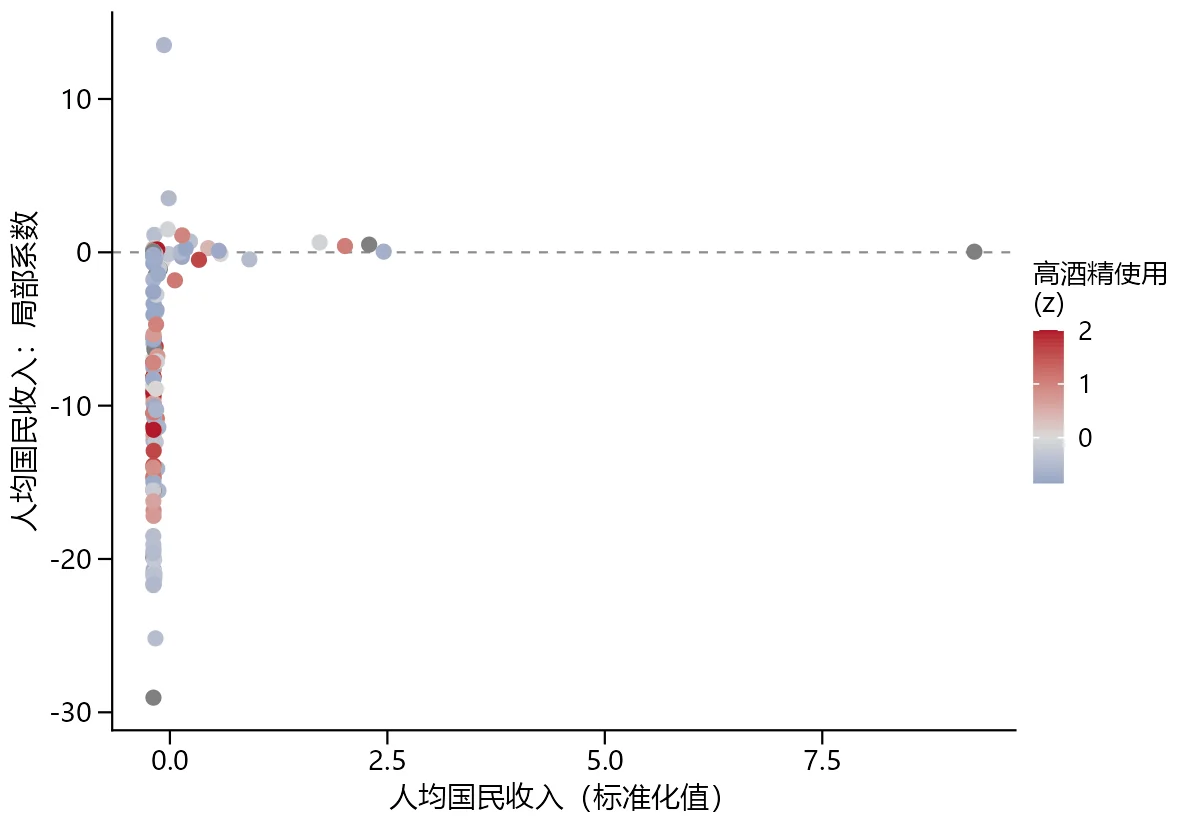
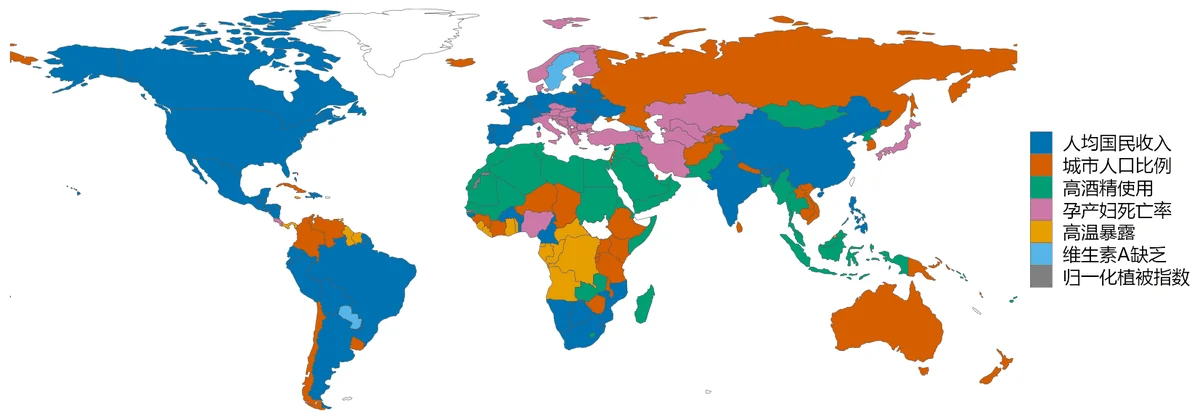
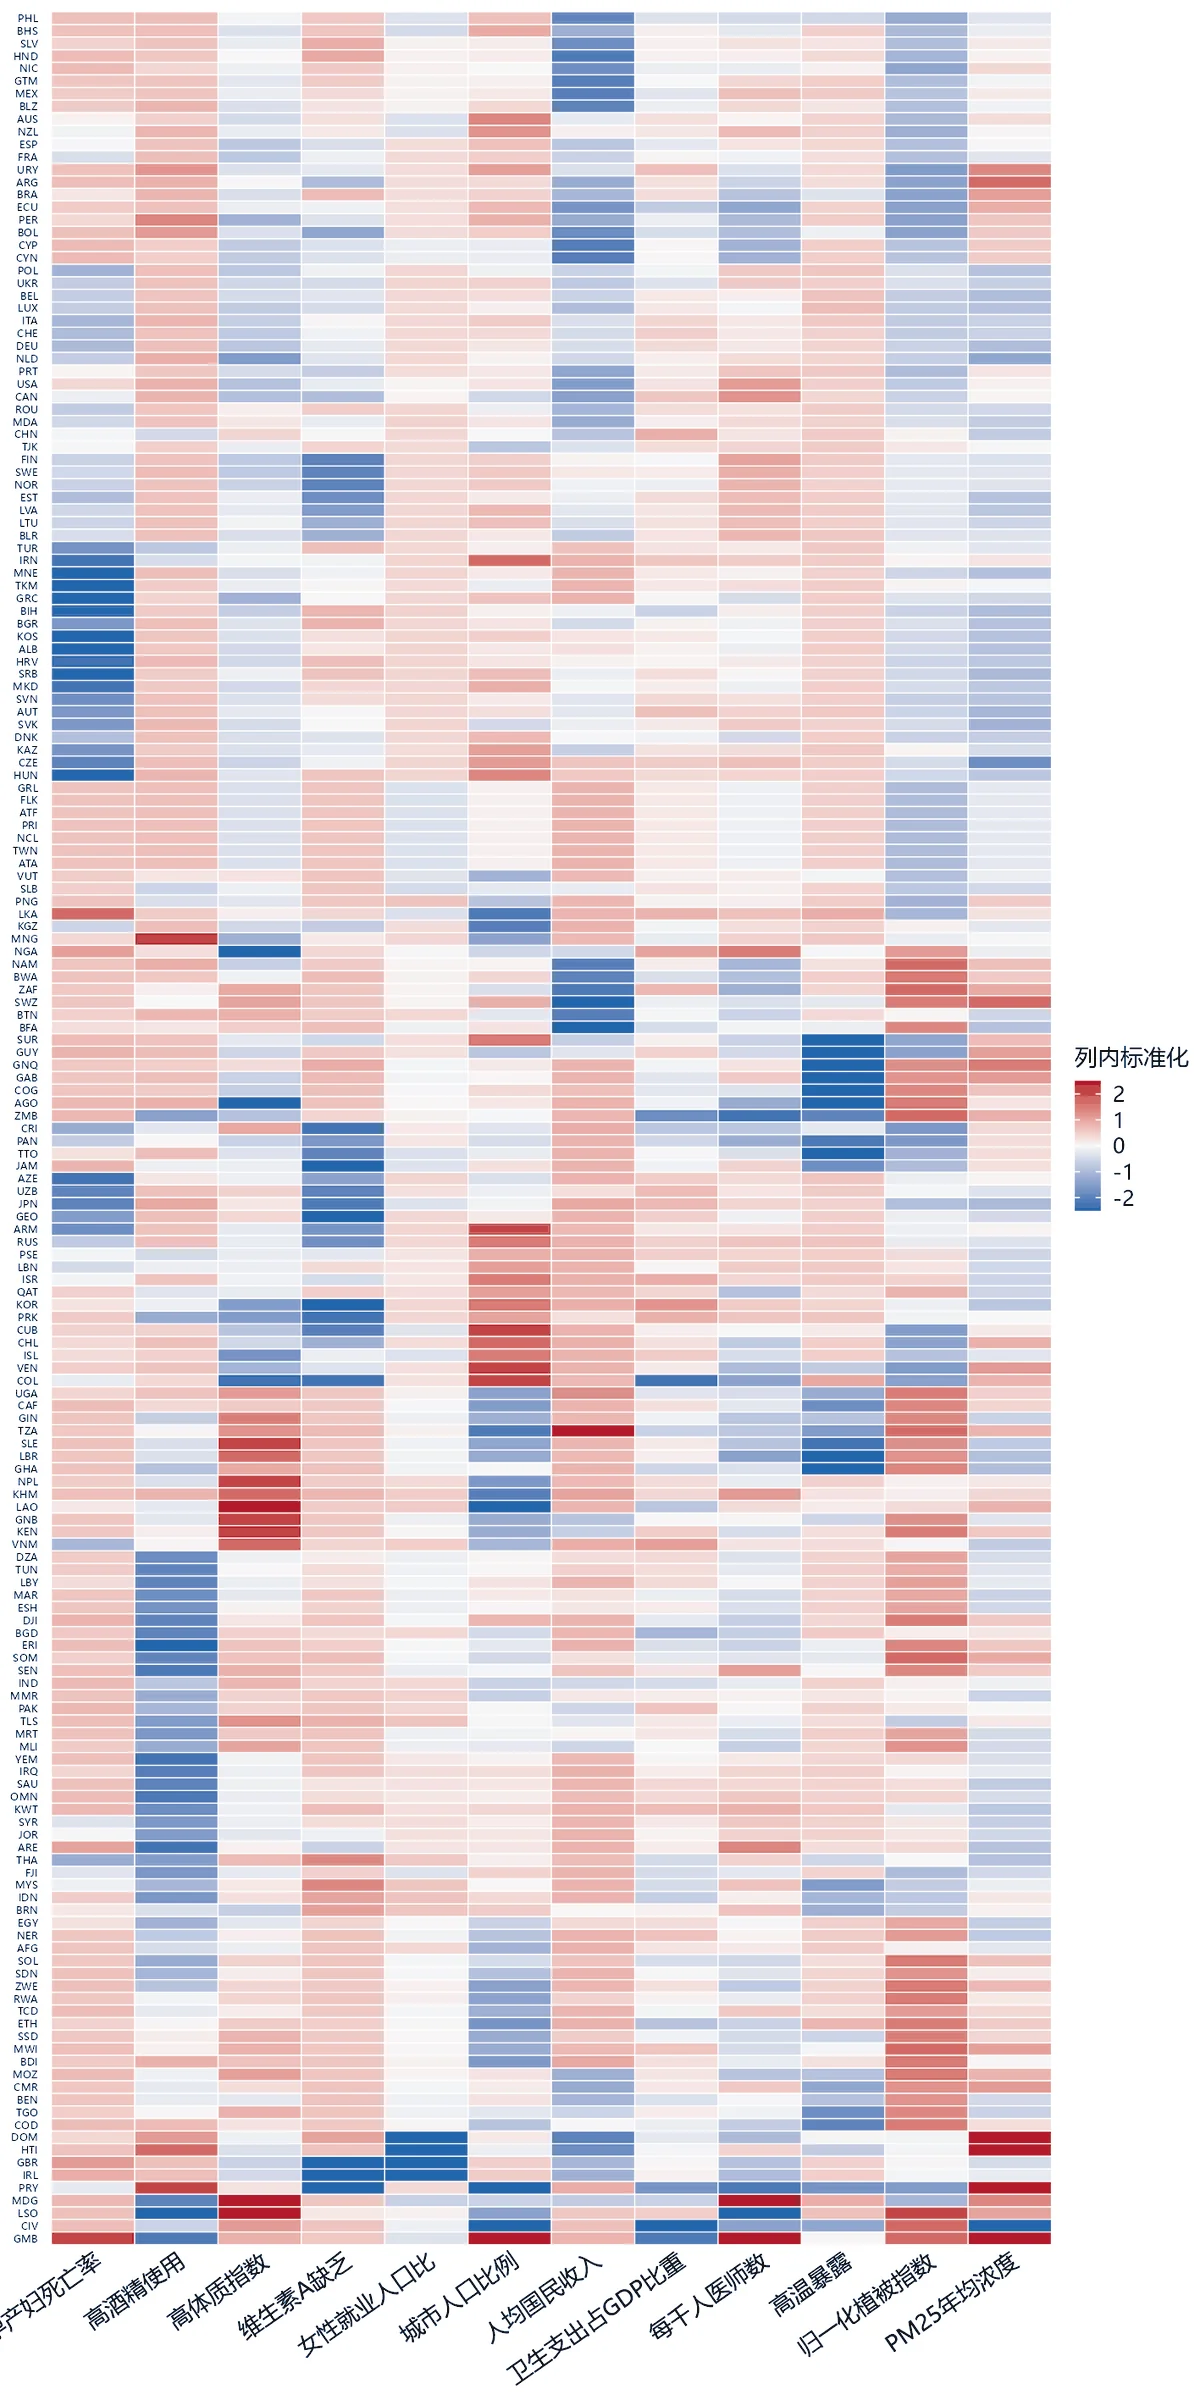
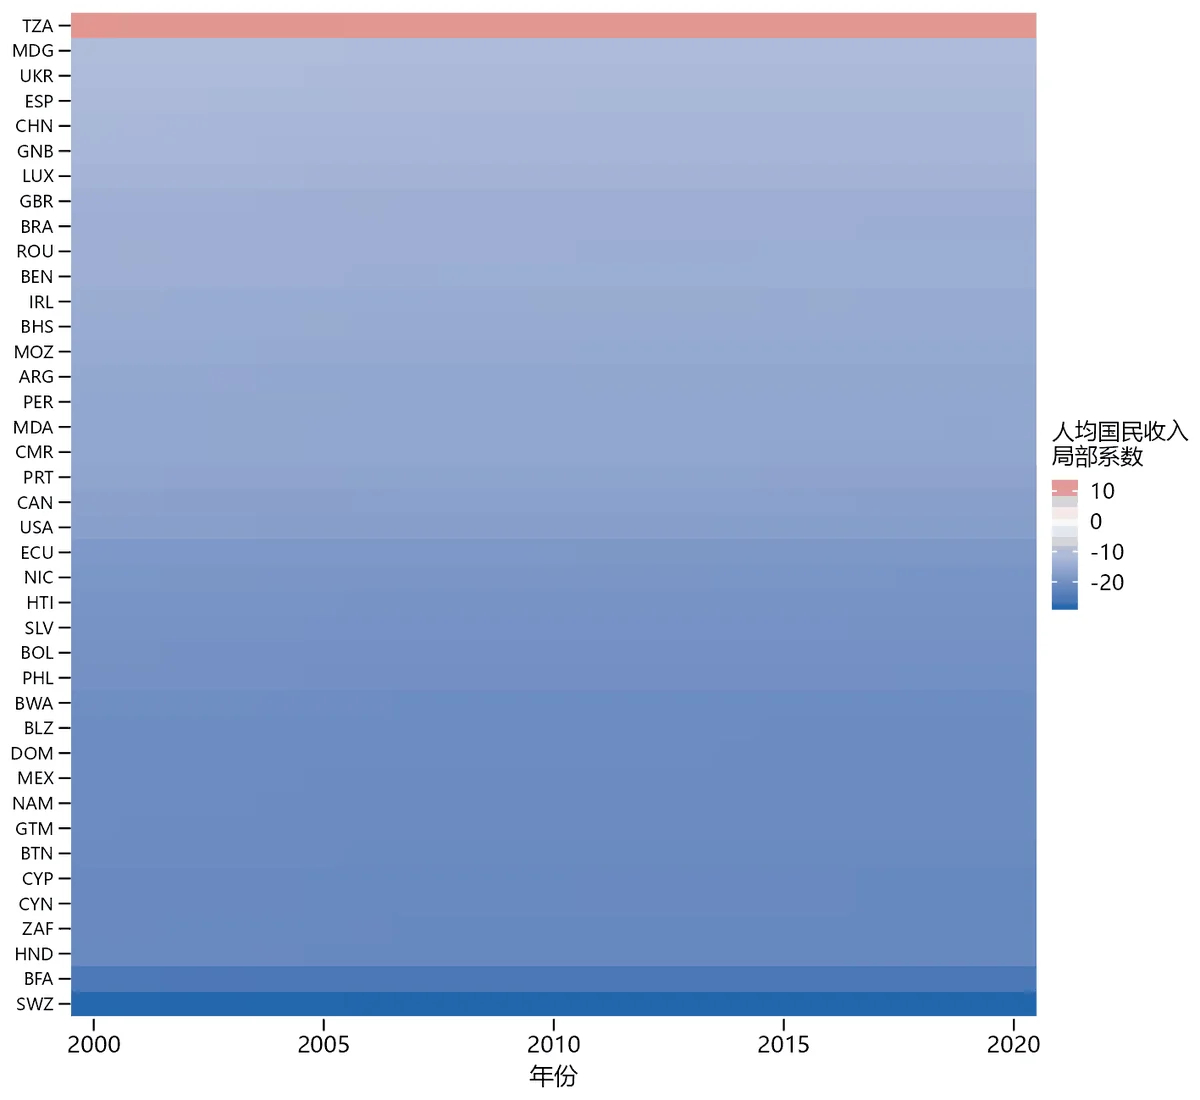
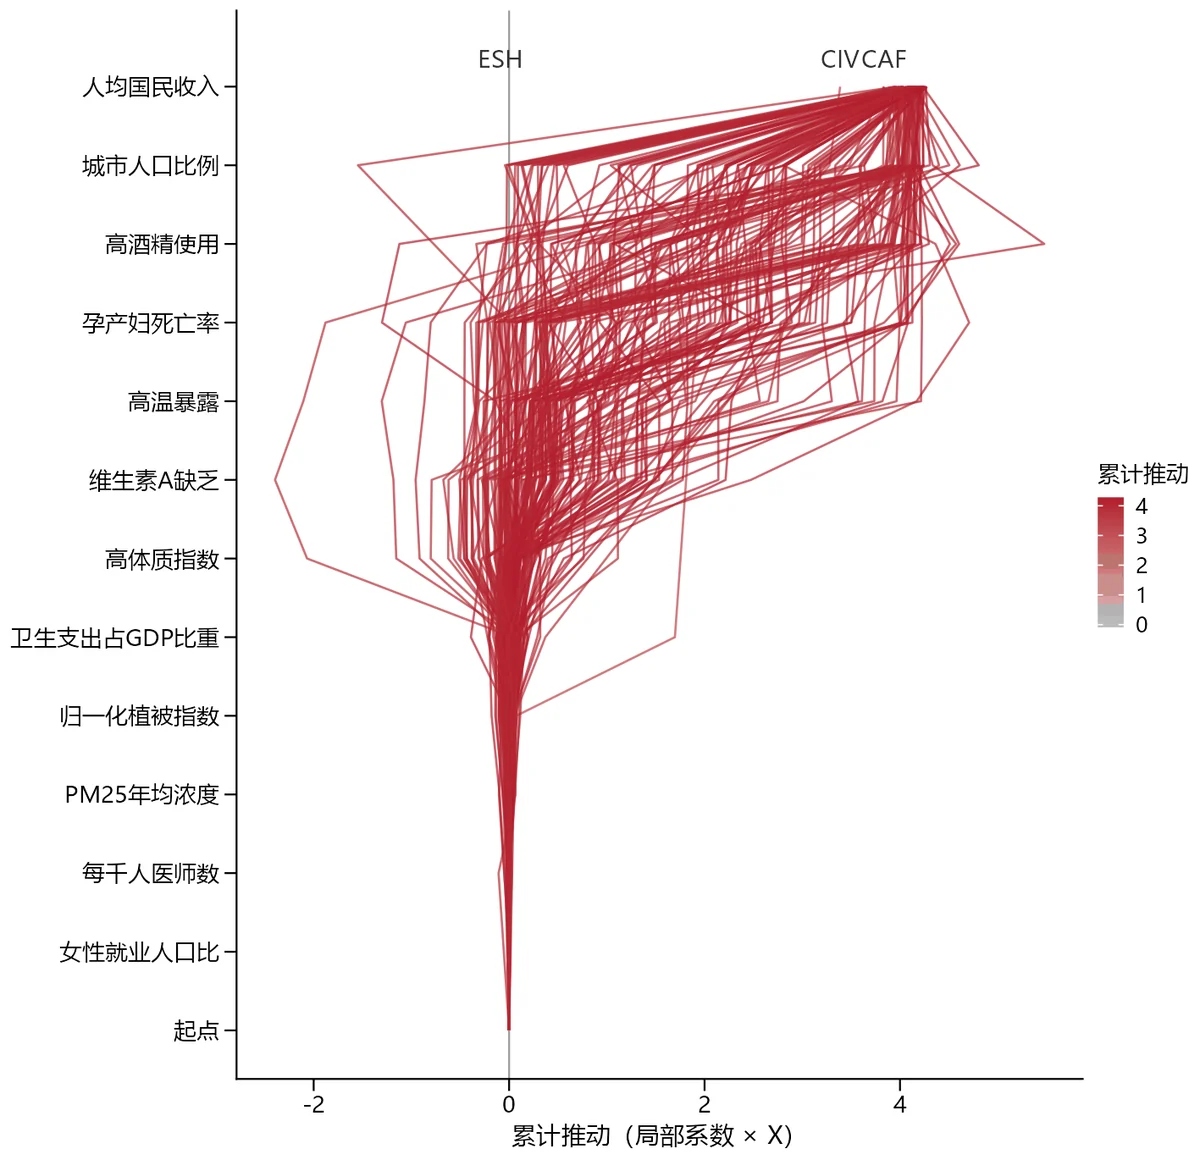
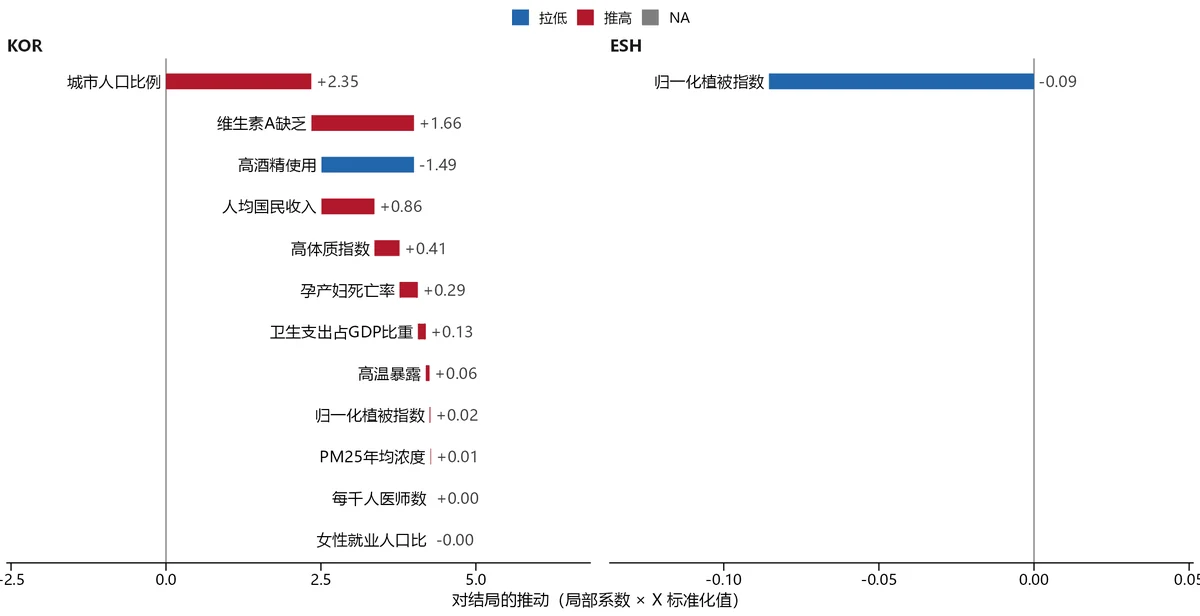
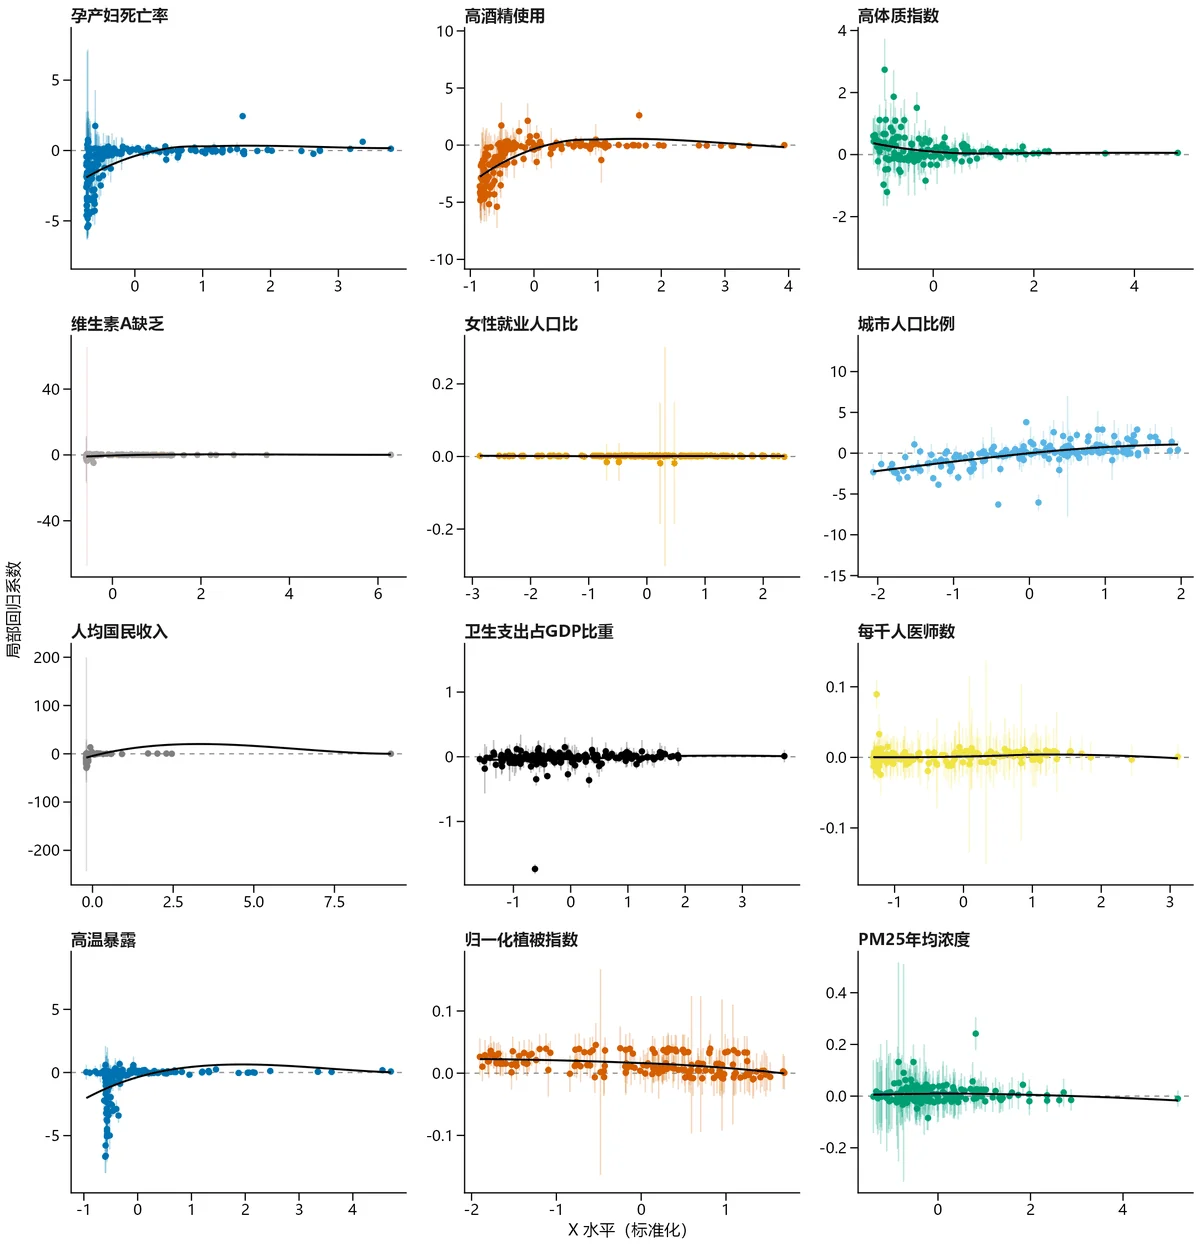
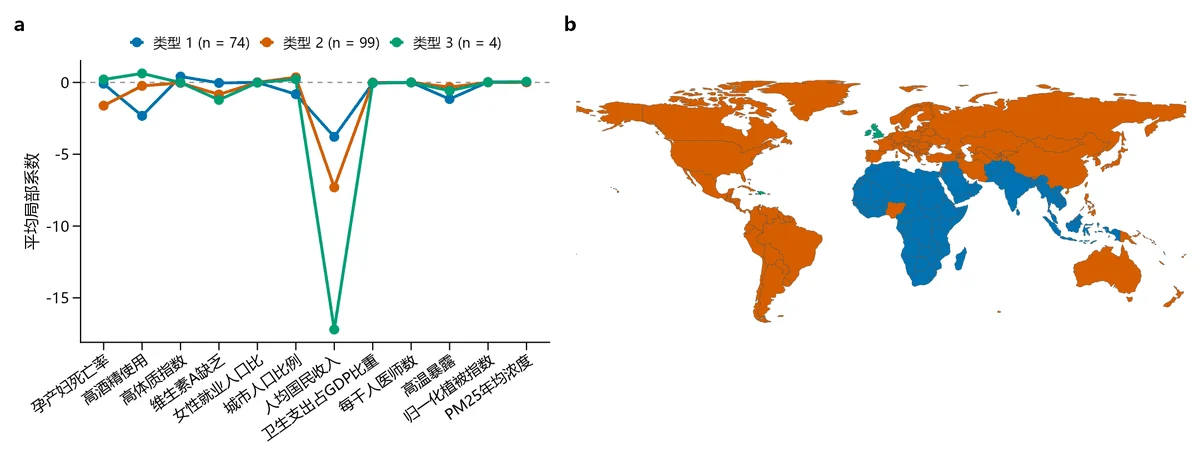
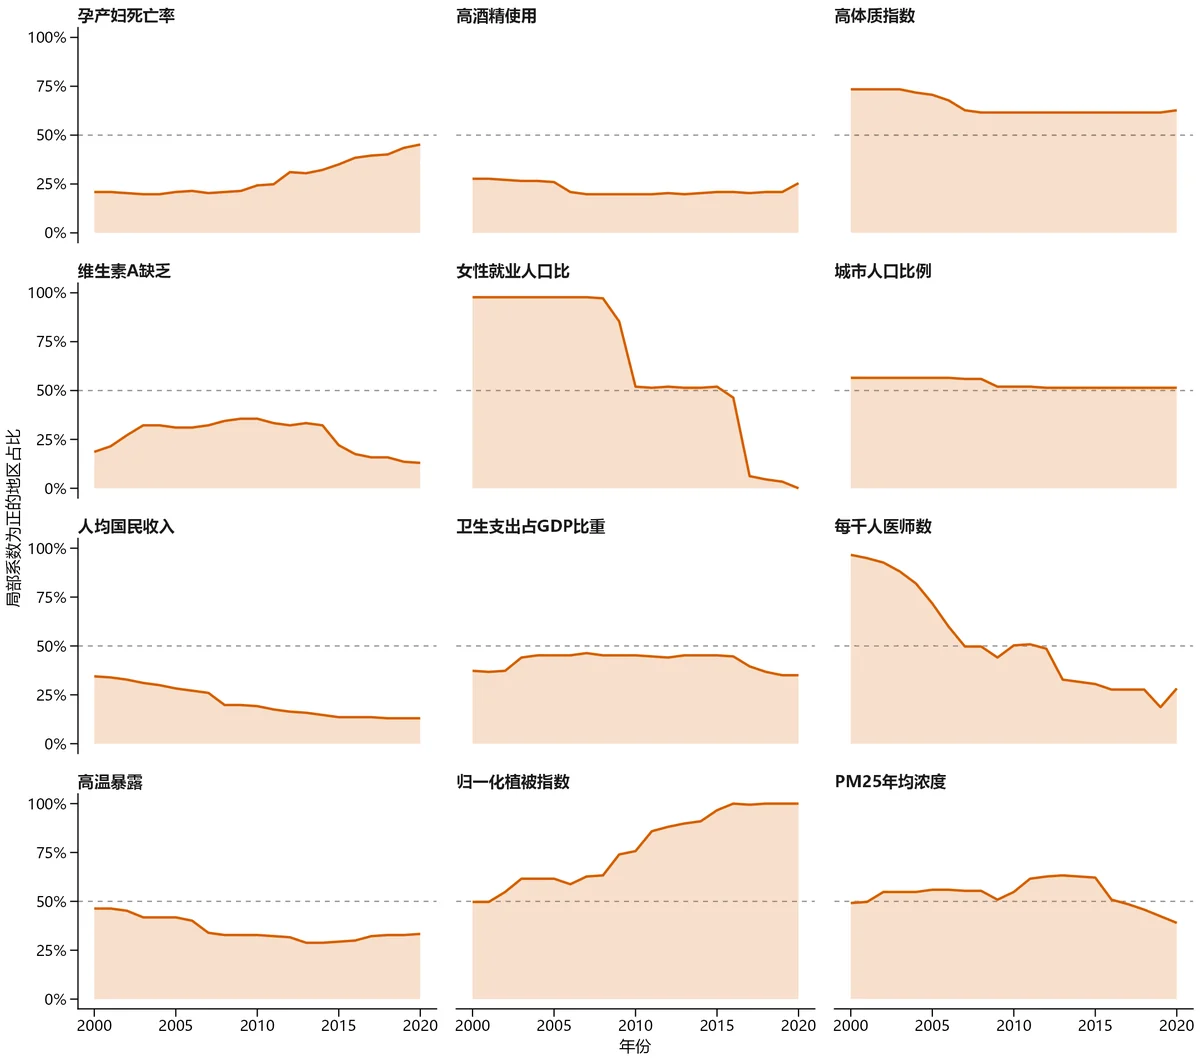
全部进阶图(中文 / 英文,PNG + PDF)在案例文件夹的 Case-06-Continuous-Global-HALE\visualization\outputs\zh 或 en\local_coef_module\。
15 六张结果表
| 表 | 里面有什么 | 怎么用 |
|---|---|---|
model.evaluation | DIC、eff、LS、running_time(分钟)、waic、pd2 | 每次先看。DIC、WAIC、LS 越小越好,只在同一数据、同一 Y 上比较;全部写进论文附表 |
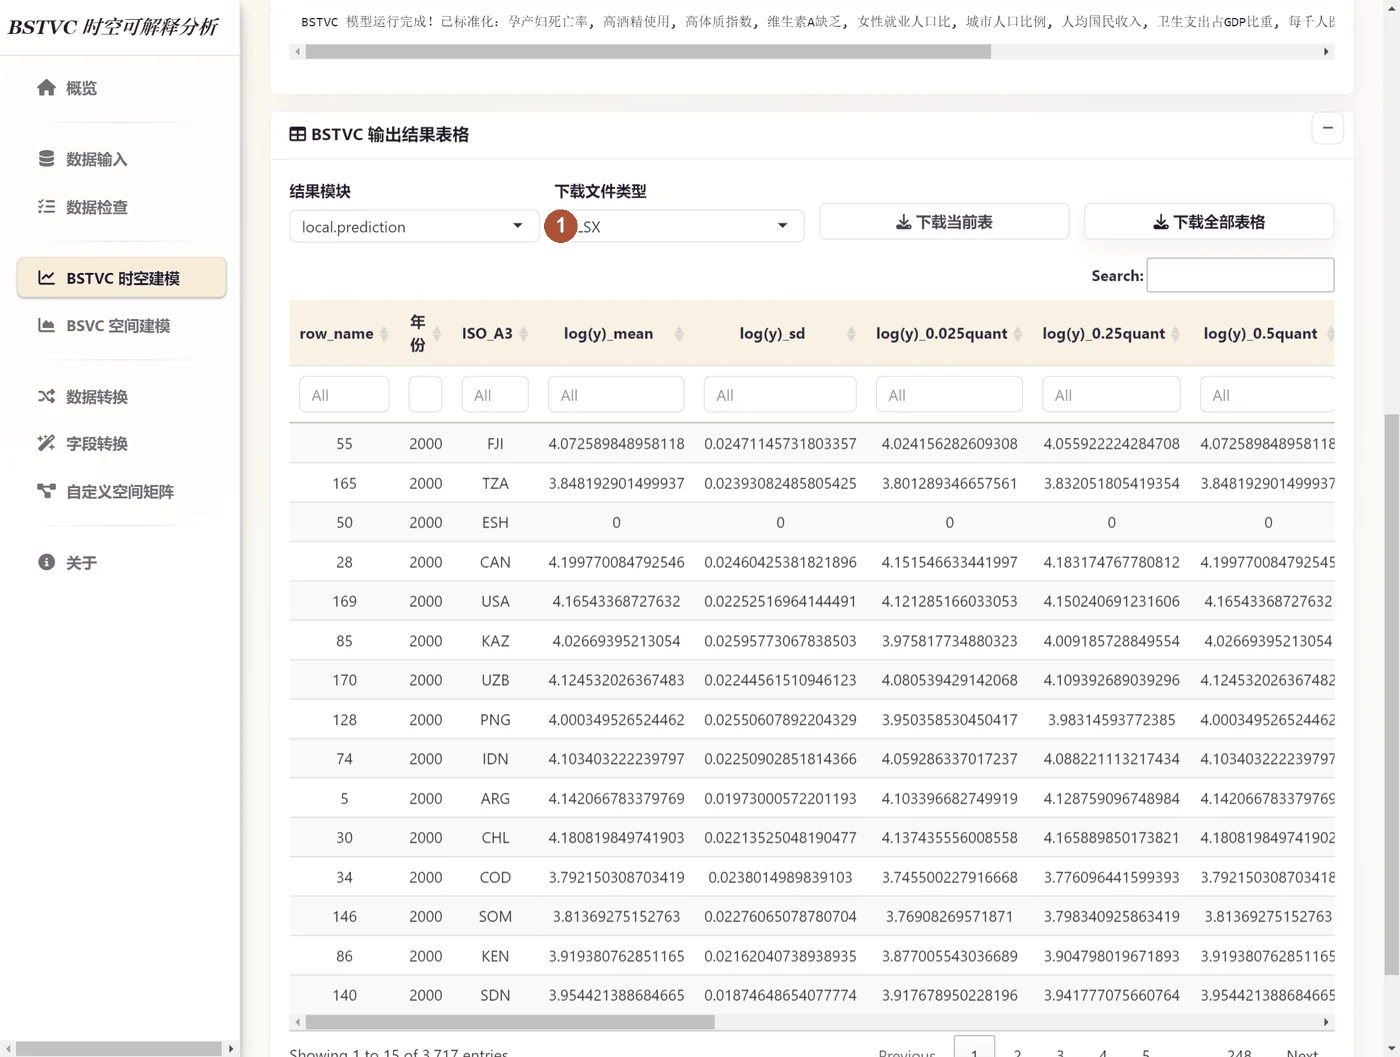
local.prediction | 每个地区 × 时点的拟合值(均值、标准差、分位数)、观测 y、predict_y;连续型另有 fill_y(缺失 Y 用拟合值补上) | 算 R² / AUC、补缺、画拟合值地图 |
summary.random.effects | 每个因素在空间上、时间上变化幅度的概括 | 数值越大,该因素的作用在空间(或时间)上变化越大 |
time.coefficients | 每个因素每个时点一行:mean、sd、分位数、time_index、explain_variable | 画时间系数图;读作“比研究时期平均强 / 弱多少” |
space.coefficients | 每个地区一行:X_mean, X_sd, X_0.025quant … X_0.975quant,最后一列是空间 ID | 按空间 ID 连地图,画空间系数地图和方向概率地图 |
STVPI | space.X、time.X、space.time.X 以及 all、residual(仅连续型)的份额和区间 | 找关键因素;二分类 / 计数没有 residual |
某地某年的完整作用 = space.coefficients 里这个地区的 X_mean + time.coefficients 里这一年的 mean(均值直接相加)。解释变量没有标准化时,不同因素的系数单位不同,不能互相比大小。
STVPI,英文版叫 contribution.STVPI;出图代码两种都认。16 用 R 出图:三步
- 安装 R(4.2 或更新),第一次运行前安装包:
install.packages(c("readxl","dplyr","tidyr","ggplot2","sf","patchwork","scales","RColorBrewer","classInt","ragg","systemfonts"))。 - 把 R 的工作目录设为某个案例文件夹(纯英文路径),例如
setwd("D:/BSTVC_data/Case-01-Continuous-Africa-U5MR")。 source("visualization/Case1_Africa_U5MR.R"),图会出现在visualization/outputs/zh/和visualization/outputs/en/。
cfg 里的几项:结果工作簿 xlsx、地图 shp、空间字段 key、响应类型 type、时间起点 t0、建模数据 data(进阶模块用),以及变量中英对照 var_en(英文图用)。只要核心图,删掉脚本里的 run_local_coef 一行即可。示例脚本:案例 1(R_visualization 版本)
# 案例 1:非洲 48 国五岁以下儿童死亡率,2000–2020(连续型)
# Case 1: under-five mortality in 48 African countries, 2000-2020 (continuous)
# 在 R_visualization 文件夹里运行 / run inside the R_visualization folder:  source("scripts/Case1_Africa_U5MR.R")
# 输出 / output: outputs/Case1_Africa_U5MR/zh/ 与 outputs/Case1_Africa_U5MR/en/(300 dpi PNG + 矢量 PDF)
source("R/bstvc_plot_functions.R"); source("R/run_case.R")
source("R/bstvc_local_coef_functions.R"); source("R/run_local_coef.R")
cfg <- list(
  id = "Case1_Africa_U5MR", title = "案例 1 非洲五岁以下儿童死亡率", title_en = "Case 1 Africa under-five mortality",
  xlsx = "data/Case1_Africa_U5MR/all_result_tables.xlsx", shp = "data/Case1_Africa_U5MR/africa_countries_v2.shp", key = "iso3",
  data = "data/Case1_Africa_U5MR/model_data.csv",                 # 建模用数据:进阶模块取 X 值 / modelling table (covariate values)
  type = "continuous", standardized = TRUE, label_field = "name",
  t0 = 2000, tlab = "年份", tlab_en = "Year", time_col = "年份", pred_times = c(2000, 2010, 2020),
  pred_label = "五岁以下儿童死亡率(‰)", pred_label_en = "Under-five mortality (per 1,000)",
  var_en = c("城市人口比例" = "Urban population", "PM25暴露" = "PM2.5 exposure", "人口百万" = "Population"))

for (lang in c("zh", "en")) {
  run_case(modifyList(cfg, list(lang = lang)))          # 核心图 / core figures
  run_local_coef(modifyList(cfg, list(lang = lang)))    # 进阶模块(可选)/ optional SHAP-style module
}
run_case.R:一个配置画出全部核心图
# =====================================================================================
#  run_case.R  -  one call draws the full set of core figures for one BSTVC / BSVC workbook
#  一次调用画出一份结果工作簿的全套核心图;cfg$lang = "zh" 或 "en"
#  Usage: source("R/bstvc_plot_functions.R"); source("R/run_case.R"); run_case(cfg)   (see scripts/*.R)
#  Output: outputs/<id>/<lang>/  (300 dpi PNG + vector PDF; no titles or captions inside the figures)
# =====================================================================================
.cfg_lang <- function(cfg) {                      # pick the language-specific settings (fields ending in _en)
  lang <- if (is.null(cfg$lang)) "zh" else cfg$lang; bstvc_lang(lang)
  if (lang == "en") for (f in c("tlab", "pred_label", "time_labels", "map_note", "label_field", "short", "title"))
    if (!is.null(cfg[[paste0(f, "_en")]])) cfg[[f]] <- cfg[[paste0(f, "_en")]]
  if (lang == "en" && !is.null(cfg$label_col)) cfg$label_col <- NULL
  cfg$lang <- lang; cfg
}
.saver <- function(cfg) function(p, stem, w, h) {   # cfg$map_note: one line under every map figure (e.g. a disclaimer)
  if (!is.null(cfg$map_note) && grepl("fig03|fig04|fig08_prediction_maps|fig15|fig20", stem)) {
    note <- grid::textGrob(cfg$map_note, x = unit(2, "mm"), hjust = 0, gp = grid::gpar(fontfamily = BSTVC_FONT, fontsize = 6, col = "grey35"))
    p <- patchwork::wrap_elements(full = p) / patchwork::wrap_elements(full = note) + patchwork::plot_layout(heights = unit(c(1, 4), c("null", "mm"))); h <- h + 4 }
  save_pub(p, paste0(cfg$id, "_", stem), w, h, outdir = cfg$outdir)
}
.read_case <- function(cfg) {
  res <- read_bstvc(cfg$xlsx); if (cfg$lang == "en") res <- translate_res(res, cfg$var_en)
  map <- sf::st_read(cfg$shp, quiet = TRUE)
  if (!is.null(cfg$drop)) map <- map[!as.character(map[[cfg$key]]) %in% cfg$drop, ]
  map <- map[!duplicated(as.character(map[[cfg$key]])), ]
  bb <- sf::st_bbox(map); list(res = res, map = map, asp = unname((bb[4] - bb[2]) / (bb[3] - bb[1])))
}
run_case <- function(cfg) {
  stopifnot(file.exists(cfg$xlsx), file.exists(cfg$shp))
  cfg <- .cfg_lang(cfg)
  cfg$outdir <- file.path(if (is.null(cfg$outdir)) file.path("outputs", cfg$id) else cfg$outdir, cfg$lang)
  dir.create(cfg$outdir, showWarnings = FALSE, recursive = TRUE)
  R <- .read_case(cfg); res <- R$res; map <- R$map; st <- "nature"; fac <- res$factors; k <- if (is.null(cfg[["k"]])) 6 else cfg[["k"]]
  nc <- min(3, length(fac)); nr <- ceiling(length(fac) / nc)
  mapH <- function(nr, ncol, extra = 8, legend = 0) { pw <- (183 - 4) / ncol - legend; round(nr * (R$asp * pw + 9) + extra) }
  S <- .saver(cfg)
  cat("\n=== ", cfg$title, " [", cfg$lang, "] ===\n", sep = "")
  # 1 global model evaluation
  ev <- res$model.evaluation; cat(check_model_eval(ev), sep = "\n")
  write.csv(model_eval_table(ev), file.path(cfg$outdir, paste0(cfg$id, "_model_evaluation.csv")), row.names = FALSE)
  S(plot_model_card(ev), "fig01_model_evaluation", 183, 55)
  # 2 temporal coefficients (BSTVC only)
  if (!is.null(res$time.coefficients))
    S(plot_time_coef(res$time.coefficients, cfg$t0, cfg$tlab, ncol = nc), "fig02_time_coefficients", 183, 12 + 42 * nr)
  # 3 spatial coefficients (core): coefficient maps + direction-probability maps; 4 hot / cold spots
  sc <- res$space.coefficients
  labs_map <- if (!is.null(cfg$label_field)) setNames(as.character(map[[cfg$label_field]]), as.character(map[[cfg$key]])) else NULL
  if (isTRUE(cfg$no_maps)) {
    S(plot_space_coef_intervals(sc, cfg$key, fac, labs_map, ncol = nc), "fig03_spatial_coefficients", 183, 20 + 60 * nr)
  } else {
    S(plot_space_coef_maps(map, cfg$key, sc, fac, ncol = nc, k = k, standardized = cfg$standardized), "fig03_spatial_coefficients", 183, mapH(nr, nc, 6, legend = 17))
    S(plot_direction_prob_maps(map, cfg$key, sc, fac, ncol = nc), "fig03b_direction_probability", 183, mapH(nr, nc, 16))
    hs <- plot_hotspot_maps(map, cfg$key, sc, fac, ncol = nc)
    if (!is.null(hs)) S(hs, "fig04_hotspots_Gi_star", 183, mapH(nr, nc, 14))
  }
  # 5-6 STVPI
  sv <- read_stvpi(res)
  S(plot_stvpi_facets(sv, ncol = 2), "fig05_STVPI_faceted", 183, 40 + 10 * length(fac))
  if (any(grepl("^time\\.", sv$effect))) S(plot_stvpi_stacked(sv), "fig06_STVPI_stacked", 120, 18 + 6 * length(fac))
  # 7-8 fit and predictions
  lp <- res$local.prediction; typ <- cfg$type
  S(plot_prediction_accuracy(lp, typ, logaxes = isTRUE(cfg$logaxes)), "fig07_prediction_accuracy", 89, 80)
  if (isTRUE(cfg$no_maps) && !is.null(cfg$time_col)) {
    S(plot_prediction_tiles(lp, cfg$key, cfg$time_col, labs_map, legend_title = cfg$pred_label, time_labels = cfg$time_labels), "fig08_prediction_tiles", 140, 110)
  } else if (!is.null(cfg$time_col) && cfg$time_col %in% names(lp)) {
    tm <- cfg$pred_times; ncp <- min(3, length(tm))
    p <- plot_prediction_maps(map, cfg$key, lp, cfg$time_col, tm, "predict_y", ncol = ncp, legend_title = cfg$pred_label)
    if (!is.null(cfg$time_labels)) p$data$time <- factor(cfg$time_labels[as.character(p$data$time)], levels = cfg$time_labels[as.character(tm)])
    S(p, "fig08_prediction_maps", 183, mapH(ceiling(length(tm) / ncp), ncp, 18))
  } else {
    S(plot_map_classed(map, cfg$key, data.frame(key = lp[[cfg$key]], value = lp$predict_y), NULL, k = 7, legend_title = cfg$pred_label), "fig08_prediction_map", 120, round(R$asp * 95 + 10))
  }
  invisible(res)
}
17 排错与常见问题
| 现象 | 怎么办 |
|---|---|
| 双击后窗口黑一会儿 | 正常,程序在启动。不要反复双击。 |
| 地图读取失败 | 少选了文件:.shp .dbf .shx .prj(和 .cpg)要一次全选。 |
| 数据检查日志里有 Error,最后是 Success | 正常的检查过程信息,以卡片标题为准。 |
| 结果画到地图上看起来错位 | 检查提示“已自动重排”后仍选了“原始数据”。改选“检查后数据”重跑。 |
| 下拉框里没有我的列 | 载入的不是这张表(例如载入了宽表而不是转换后的长表)。重新载入后再选。 |
| 转换后的 CSV 用 Excel 打开乱码 | 下载时选 Excel xlsx。 |
运行失败:Loop 0 is not valid: Edge 0 crosses edge … | 地图里有自相交的多边形。见案例 1 的修复步骤。 |
| 窗口一直灰着、显示“正在运行” | 大模型要多等一会儿(案例 6 约 ≈ 17 分钟)。任务管理器里 CPU 占用高、内存在变 = 仍在计算;若长时间没有任何占用而窗口不更新,关闭软件后重开。 |
| 只选了一个 X 就报错 | 至少需要 2 个 X。 |
| eff 或 DIC 是负数 | 是该数据在该设置下的真实输出,如实报告,由使用者判断(见案例 4b)。 |
| k 近邻矩阵报错或没有输出 | 官方说明的已知局限;改用默认 QUEEN 矩阵或其他矩阵。 |
| 数字和本手册略有不同 | 数值计算的正常波动,重复运行第 3–4 位有效数字可能不同。 |
17.1 好习惯
- 程序、数据、地图、结果全部用英文路径。
- 一个研究一个文件夹:表格、地图、结果放一起;原始数据不覆盖,转换后的文件另起名。
- 从小做起:先用 2–3 个完整的 X 跑通,再加变量。
- 每次跑完立刻下载全部表格,并在旁边记下设置(Y、X 及顺序、类型、时间、空间、标准化、矩阵、线程、软件版本、日期)——结果表本身不保存这些。
18 官网、资源与引用
bstvc.research@gmail.com。邮件标题建议“BSTVC V2|问题简述”,附软件版本、Windows 版本、操作步骤、设置、完整提示和截图;数据先脱敏。18.1 怎样引用
请引用方法论文,并写明软件版本(本手册:BSTVC 桌面版中文版 26.10.25)、使用日期和设置。模型原理请参阅这些已发表的论文:
- Song, C., Shi, X., & Wang, J. (2020). Spatiotemporally Varying Coefficients (STVC) model: a Bayesian local regression to detect spatial and temporal nonstationarity in variables relationships. Annals of GIS, 26(3), 277–291.
- Song, C., Shi, X., Bo, Y., Wang, J., Wang, Y., & Huang, D. (2019). Exploring spatiotemporal nonstationary effects of climate factors on hand, foot, and mouth disease using Bayesian STVC model in Sichuan, China. Science of the Total Environment, 648, 550–560.
- Song, C., Yin, H., Shi, X., et al. (2022). Spatiotemporal disparities in regional public risk perception of COVID-19 using Bayesian Spatiotemporally Varying Coefficients (STVC) series models across Chinese cities. International Journal of Disaster Risk Reduction, 77, 103078.
- Wan, Q., Tang, Z., Pan, J., et al. (2022). Spatiotemporal heterogeneity in associations of national population ageing with socioeconomic and environmental factors at the global scale. Journal of Cleaner Production, 373, 133781.(STVPI)
免费下载 · 科研使用。
附录
A. 一页检查清单
- 全部路径为英文。
- 表格:长表(或先转换);缺失写 NA;没有重复的(地区, 时间);至少 2 个 X。
- 地图:文件齐全;ID 字段与表格同名同类型;多边形有效;岛屿心中有数。
- 数据输入 → 看两条 OK 和三个方块。
- 数据检查 → “已完成自动重排” → 建模选检查后数据。
- 建模:Y · X · 响应类型 · 时间 · 空间 · 标准化 = 是 · QUEEN · 线程 20 → 运行。
- 先看模型评价,全部记录;立刻下载全部表格并记下设置。
- 运行案例脚本出图;按“评价 → 贡献 → 时间 → 空间 → 拟合”的顺序读图。
B. 配套文件
| 本手册 | 单个 HTML 文件,用浏览器打开,可直接转发 |
| 六个案例文件夹 | 数据、地图、README_zh.md(变量说明与预期结果)、reference_results_V2/(V2 结果表)、visualization/(出图脚本 + 中英两套论文图 + 进阶图) |
R_visualization | 全部案例的出图代码与数据,一处运行即可重画全部图 |